시간의 흐름에 따른 심리적 특성의 변화를 연구하기 위해 종단자료의 활용은 필연적이다. 횡단자료에서와는 다르게 종단자료에서는 동일한 개인에 대한 반복 측정을 통해 시간에 따른 변화에 개인차가 혼입될 가능성을 차단함으로써 시간에 따른 변화를 정확하게 측정할 수 있다. 빈복측정으로 이루어진 종단자료의 또 다른 중요성은 변화의 과정에 대한 정보를 제공할 수 있다는 것이다. 예를 들어, 심리장애의 진행이나 치료과정, 교육으로 인한 수행의 변화 등, 최초의 상태와 결과에 대한 정보에 더하여 결과에 이르는 과정에 대한 정보는 변화의 기제에 대한 이해를 가능하게 함으로써 효과적인 개입이나 예방을 가능하게 한다(조승빈, 2022; Bollen & Curran, 2006; Willett, 1988).
잠재 성장모형(latent growth model)은 잠재곡선모형(latent curve model) 또는 성장곡선모형(growth curve model) 등으로도 불리며 이러한 변화의 과정을 이해하기 위해 심리학의 여러 분야에서 자주 사용하는 모형이다(Bollen & Curran, 2006). 잠재성장모형에서는 시간에 따른 변화를 절편과 기울기의 두 종류의 성장요인을 통해 설명한다. 절편 요인은 모형에서 설정한 기저 시점에서 기대되는 기댓값의 수준을, 기울기 요인은 선형 또는 비선형 변화의 양상을 나타내며 표본에 존재하는 평균적인 성장 궤적은 이러한 두 종류의 성장요인과 시간에 대한 함수로 표현된다. 따라서, 잠재성장모형의 성장요인들은 변화의 기제를 나타낸다고 해석할 수 있다. 선형 성장모형은 시간의 흐름에 따라 증가 혹은 감소하는 선형의 성장궤적을 모형화하기 위해 사용된다. 선형 잠재성장모형은 절편과 선형 기울기라는 2 개의 성장요인을 가지며, 절편 요인은 기저 시점에서 기댓값의 수준, 선형 기울기 요인은 단위 시간 변화에 따른 행동의 변화율이라는 직관적인 해석이 가능하다. 성장요인에 대한 직관적 해석은 선형 잠재성장모형이 가지는 중요한 장점이며 성장요인과 연관된 요인들에 대해서도 이론적으로 의미 있는 해석을 가능하게 하여 선형 잠재성장모형을 통해 변화의 기제를 이해하는 데 중요한 역할을 한다.
이러한 장점에도 불구하고, 다양한 변화의 양상을 단순한 선형함수로 모형화하는 선형 잠재성장모형의 특성은 선형 잠재성장모형을 다양한 상황에 적용하기 어렵게 만든다. 예를 들어, 사람의 신체적 성장이 선형적 변화를 따르지 않는 것처럼, 심리적 특성의 선형적 변화에 대한 가정은 이론적으로 지지가 되지 않거나 실제 자료에서 관찰되지 않는 경우가 자주 발생한다(McArdle & Nesselroade, 2014). 특히 측정의 빈도와 기간이 길 때 이러한 변화 양상을 더욱 흔하게 발견할 수 있다(예를 들어, Dick et al., 2014; Hayes et al., 2007; Ployhart & Vandenberg, 2010). 따라서, 여러 연구자들이 비선형적인 변화를 고려할 수 있는 다양한 형태의 잠재성장모형을 제안하였다. 예를 들어, 선형 잠재성장모형에 2차항 이상의 고차항 기울기 요인을 추가하거나(Bollen & Curran, 2006), 성장요인의 요인부하량의 조정을 통해 지수함수나 곰퍼츠 함수와 같은 비선형 성장 함수를 사용하는 방법 등이 제안되었다(Grimm et al., 2011). 성장모형의 요인부하량에 대해 모형의 판별(identification)을 위한 최소한의 제약조건만을 적용하여 특정한 형태의 변화 양상을 제약하지 않음으로써 비선형 변화를 모형화할 수도 있다(Wu & Lang, 2016; Meredith & Tisak, 1990).
비선형 변화를 모형화하는 또 다른 방법은 측정 기간을 분할하여 분할된 기간에 대해 별개의 선형 성장모형을 적용하는 것이다. 이러한 모형을 분할 선형 성장모형(piecewise linear growth model, 개괄: Flora, 2008)이라고 한다. 분할 선형 성장모형은 비선형 변화를 모형화하는데 있어 전술한 비선형 성장함수를 이용한 잠재성장모형에 비해 몇 가지 장점을 가진다. 먼저, 분할된 구간에 서로 다른 선형 성장모형을 적용하기 때문에 다양한 형태의 성장궤적에 대한 모형화가 가능하다. 두 번째, 분할된 각 구간에서 선형성장함수를 적용하기 때문에 선형 성장모형에서와 같이 성장요인에 대한 직관적이고 이론적으로 의미 있는 해석이 용이하다. 이러한 특성은 성장모형을 통해 변화의 기제를 이해하는 데 중요한 역할을 한다. 마지막으로, 분할 선형 성장모형의 경우 비선형적 변화를 모형화할 수 있을 뿐만 아니라 시기별로 달라지는 관련 요인들의 영향을 추정할 수 있다. 예를 들어, 초등학교에서 중학교(황혜영, 김나영, 2021), 또는 중학교에서 고등학교(Duan et al., 2009)로의 진학은 아동 또는 청소년들의 발달과정에서 중요한 전환점의 역할을 하며 이를 전후로 학업 스트레스의 정도(황혜영, 김나영, 2021)나 물질사용(Duan et al., 2009) 등은 비선형적 변화를 보일 뿐만 아니라 변화와 연관된 요인들이 달라졌다. 고차항 성장모형이나 비선형 함수(예를 들어 지수함수, 곰퍼츠함수 등)를 사용하여 이러한 변화를 모형화할 경우에는 시기별로 달라지는 요인의 영향을 추정하는 것이 불가능하다.
변곡점(knot)의 설정은 분할 선형 성장모형의 설정에서 핵심적인 요소이다. 분할 선형 성장모형에서 변곡점은 별개의 선형 성장함수가 적용될 구간을 나누는 지점으로, 적절한 변곡점의 설정은 성장요인의 의미 있는 해석을 가능하게 할 뿐만 아니라 모형적합도를 향상시킨다(Kohli et al., 2015b). 분할 선형 성장모형을 적용하는 많은 경우, 이론에 기반하여 선험적(a priori)으로 변곡점을 설정한다(Hughes & Cao, 2018; Ahn et al., 2017). 예를 들어, 진학에 따른 학업 스트레스의 변화를 분석한 황혜영과 김나영(2021)에서는 초등학교 졸업을, 이차성징의 변화를 분석한 Ellis 등(2011)에서는 사춘기에 해당하는 12.5세를, 알코올 사용의 변화를 모형화한 Dick 등(2014)에서는 청소년기와 성인 진입기(emerging adulthood)를 나누는 19세를 변곡점으로 설정하였다. 이론에 기반하여 선험적으로 변곡점을 설정하는 것은 모형의 설정이 간단하고 성장요인의 해석이 명확하다는 장점을 가진다.
그러나, 변곡점에 대한 이론적 근거가 항상 명확하게 주어지는 것은 아니며, 이러한 경우에는 자료로부터 변곡점을 추정할 수 있다. Harring 등(2006)은 2 개의 구간으로 이루어진 분할 선형 성장모형에서 변곡점을 추정할 수 있는 방법을 제안하였다(Kohli. & Harring, 2013; Cudeck & Harring, 2007). Harring 등(2006)이 제안한 모형은, 두 구간의 선형 성장함수가 변곡점에서 서로 만난다는 가정을 기반으로 변곡점의 위치를 모수화하여 추정할 수 있음을 보였다. Kohli 등(2015a)은 초등학교 및 중학교 학생들의 수학과목 성취의 변화를 모형화하기 위해 변곡점을 추정하는 분할 선형 성장모형을 사용하였으며 이러한 모형이 2차항 성장모형이나 선형 성장모형에 비해 더 나은 적합도를 가지는 것을 확인하였다. Gerstorf 등(2010)은 변곡점의 추정을 통해 죽음을 앞둔 노년의 삶의 질이 급격히 악화되기 시작하는 시점을 확인하였다.
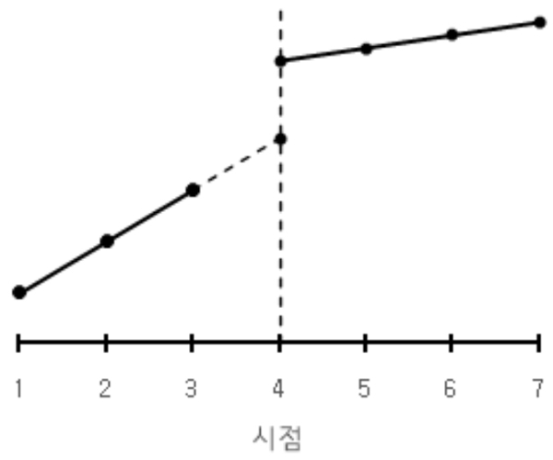
분할 선형 성장모형의 중요한 장점 중 자주 간과되는 것 한 가지는 변곡점에서 성장궤적이 연결되지 않는 불연속 성장궤적을 모형화할 수 있다는 것이다. 그림 3은 7개의 측정 시점을 가지며 시점 4가 변곡점인 불연속 성장궤적의 예시이다. 그림 3에서 변곡점의 전과 후의 성장함수로 추정한 성장궤적(실선)은 변곡점에서 서로 만나지 않는다. 변곡점을 전후하여 발생하는 급격한 변화로 인해 기댓값이 갑작스럽게 증가 또는 감소하는 경우에 이러한 불연속적인 성장궤적이 나타날 수 있다. 예를 들어, 고등학교 졸업 후 성인 진입기로 접어드는 시기의 개인적, 상황적 변화는 알코올 사용의 불연속적인 변화를 초래했으며(Dick et al., 2014), 대학생의 수입은 졸업을 전후하여 급격하게 변하며 이는 수입의 불연속적인 변화로 이어졌다(Jagger & Xu, 2016). 변곡점에서 발생하는 이러한 급격한 변화에 대해 정해진 용어는 없으나 여러 연구에서 ‘도약(jump)’이라고 칭하고 있으며(Liu et al. 2018; Lock et al., 2018; Jaggars & Xu, 2016), 본 연구에서도 같은 용어를 사용할 것이다. 분할 선형 성장모형에서는 성장요인의 추가를 통해 도약으로 인한 불연속 성장궤적을 모형화할 수 있으며 도약의 존재를 실증적으로 검정할 수 있다. 그러나 도약으로 인한 성장궤적의 불연속성은 분할 선형 성장모형을 적용한 연구들에서 자주 간과되는 특성이다(예를 들어, 황혜영, 김나영, 2021; 안은미 외, 2016; Flora, 2008; Li et al. 2001).
성장궤적에 그림 3과 같은 불연속적인 변화 양상, 즉 도약이 존재하는 종단자료를 분석하기 위해 분할 선형 성장모형을 적용할 때 도약을 추정하지 않는 것은 모형설정의 오류(misspecification)이며 모수 추정의 편향과 모형 적합도의 저하가 발생할 것을 예상할 수 있다. 또한, 변곡점을 추정하는 모형(Harring et al., 2006)의 경우 변곡점에서 성장궤적의 연속성은 변곡점을 추정하기 위한 필수적인 가정이기 때문에 실제 성장궤적에 도약이 존재하더라도 이를 모형에 포함하지 못한다(Coman & Wu, 2018; Kohli et al. 2015a; Gerstorf et al., 2010; Harring et al., 2006). 따라서 변곡점의 추정에도 편향이 발생할 가능성을 배제할 수 없다. 그러나 도약을 모형에 포함시키지 않는 것이 모수의 추정과 적합도에 미치는 영향에 대해 실증적으로 확인한 연구는 지금까지 이루어지지 않았다. 따라서 본 연구의 목표는 변곡점에서 도약이 존재하는 불연속 성장궤적을 분석하기 위해 분할 선형 성장모형을 사용할 때 도약을 모형에 포함하지 않음으로써 발생할 수 있는 모수 추정의 편향과 적합도의 저하를 시뮬레이션을 통해 확인하는 것이다. 구체적으로, 두 구간으로 이루어진 불연속 성장궤적에서 도약의 크기를 변화시켜 생성한 자료를 Harring 등(2006)이 제안한 변곡점을 추정하는 분할 선형 성장모형(Kohli et al, 2013; Cudeck & Harring, 2007; Harring et al, 2006)으로 분석하고 그 결과를 통해 성장요인과 변곡점 추정의 편향, 모형적합도의 변화를 확인하였다. 분할 선형 성장모형은 두 구간으로 이루어진 성장궤적에 가장 흔히 활용되며 두 구간으로 이루어진 성장궤적에 대한 분할 선형 성장모형의 적용은 세 구간 이상의 구간으로 이루어진 성장궤적에 직접적인 일반화가 가능하다. 이어지는 장에서는 분할 선형 성장모형의 설정과 도약의 추정을 위한 모수화 방법, 변곡점 추정을 포함하는 이론적 배경을 개괄한다.
분할 선형 성장모형의 설정
도약을 포함하는 분할 선형 성장모형을 설명하기 위해서는 먼저 비선형 변화가 존재하지 않는 일반적인 선형 성장모형의 설정을 확인할 필요가 있다. 공변인(covariate)이 없는 비조건(unconditional) 선형 성장모형에서 시점 t의 측정값의 기댓값 를 식 1에서와 같이 절편과 시간요인을 통한 시간의 함수로 나타낸다.
식 1에서 I 는 절편 요인, S 는 선형 기울기 요인을 나타낸다. λt는 기울기 요인에 대한 요인부하량, 즉 시간을 나타낸다. 절편 요인과 기울기 요인은 평균이 각각 μI와 μS, 분산이 ψI과 ψS, 공분산이 ψIS인 다변량 정규분포를 따르는 것으로 가정한다.
식 1의 두 성장요인의 해석은 일반적인 선형 회귀모형에서 회귀계수의 해석과 마찬가지로, 절편 요인은 기저 시점에서 기댓값을, 기울기 요인은 단위시간 변화에 따른 변화량의 기댓값으로 해석할 수 있다. 절편 요인과 선형 기울기 요인은 각 요인에 해당하는 요인부하량의 설정을 통해 정의된다. 예를 들어, 7회의 반복측정에서 얻어진 시점 t 의 기댓값 를 모형화하기위해 에서 최초 측정 시점을 기저 시점으로 설정하고 측정 시점 간 동일한 간격을 가정한 선형 성장모형의 설정은 아래 식 3과 같다.
식 3에서 η 는 절편(I)과 기울기(S)의 두 성장요인으로 이루어진 요인 벡터이다. Λ는 (7 × 2) 차원의 요인부하 행렬이며 첫 번째 열은 절편 요인(I)에 해당하는 요인부하량, 즉 상수를 나타낸다. Λ 행렬의 두 번째 열은 기울기 요인(S)에 해당하는 요인부하량, 즉 λt를 나타내며 시간 단위의 변화는 λt를 통해 결정된다. 따라서 식 3의 선형 잠재성장모형에서 I 는 첫 번째 시점의 기댓값, 즉 절편을 나타내며 S 는 시간의 변화에 따른 변화량, 즉 선형 기울기를 나타낸다.
분할 선형 잠재성장모형을 통해 그림 1과 같이 특정 시점을 전후로 성장궤적이 변화하는 비선형 성장궤적을 모형화할 수 있다. 분할 선형 잠재성장모형은 변곡점을 기준으로 나누어진 구간에 대해 서로 다른 선형 성장모형을 적용함으로써 그림 1과 같은 비선형적 변화 양상을 모형화한다. 먼저, 그림 1과 같이 변곡점에서 성장궤적이 꺾이는 형태의 변화 양상의 경우 시점 t의 기댓값 은 식 4와 같이 기울기 요인을 추가함으로써 모형화할 수 있다.
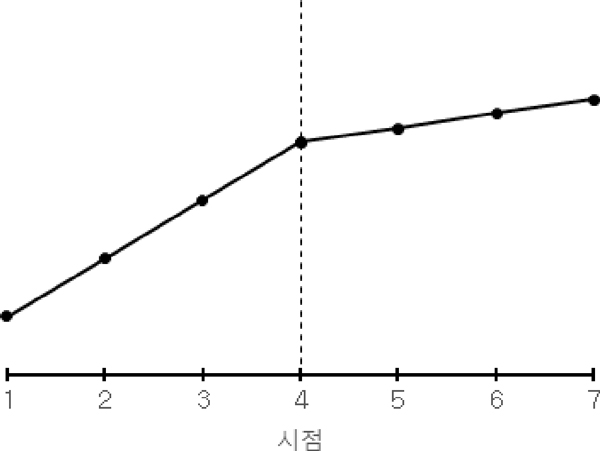
식 4에서 S1은 구간 1(측정시점 1-3)의 기울기 요인, S2는 구간 2(측정시점 4-7)의 기울기 요인을 나타내며 λ1t와 λ2t는 각각 시점 t 에서 성장요인 S1과 S2에 해당하는 요인부하량이다. 기울기 요인의 모수화는 요인부하행렬 Λ를 통해 이루어지며 주로 다음의 두 가지 방법을 사용한다. 기울기 요인을 모수화하는 첫 번째 방법은 S1이 변곡점 이전 구간에서 선형성장함수의 기울기를, S2가 변곡점 이후의 선형 기울기를 나타내도록 설정하는 것이다. 이러한 모형을 7개의 측정 시점을 가지며 4번째 시점이 변곡점인 자료에 적용하면 아래 식 5와 같이 나타낼 수 있다.
식 5에서, 구간 1의 성장함수는 , 구간 2의 성장함수는 로 표현할 수 있다. 즉, 구간 2의 성장함수는 (I + 3S)를 절편으로 가지고 S2를 기울기로 가지는 선형 성장함수이다. 식 5의 모형에서 시간 단위를 변곡점에 중심화할 경우, 모형의 적합도를 변화시키지 않으면서 성장요인(I, S1, S2)에 대한 더욱 직관적인 해석이 가능하다. 시간 단위를 변곡점에 중심화 할 경우, 요인부하행렬 Λ 는 아래 식 6과 같이 설정한다.
식 5와 6에서 S2의 추정값과 해석은 변하지 않으며, 식 6에서 구간 1의 성장함수는 , 구간 2의 성장함수는 로 나타낼 수 있다. 따라서 S1은 변곡점 이전의 기울기 요인, S2는 변곡점 이후의 기울기 요인을 나타냄을 더 직관적으로 확인할 수 있다. 이와 같은 성장요인의 해석의 용이함을 위해 이후에 설명하는 모형에서도 변곡점에서 중심화된 시간 단위를 사용한다.
S2 요인을 설정하는 두 번째 방법은 구간 2의 기울기를 구간 1의 기울기에 대한 상대적 변화량으로 모수화하는 것이다. 이러한 모수화는 아래의 식 7과 같이 표현할 수 있다.
식 7에 따르면 구간 1의 성장함수는 , 구간 2의 성장함수는 와 같이 나타낼 수 있다. 즉, S2는 구간 1 기울기 요인 S1에 비교하여 구간 2 기울기의 상대적 변화량을 나타낸다. S2에 대한 두 가지 모수화 방법의 비교에서 중요한 점은 모수화 방법에 따라 S2의 해석이 달라지고, 따라서 S2를 통해 검정하는 가설이 달라진다는 점이다. 식 6에서 S2에 대한 가설검정은 구간 2의 기울기의 유의성이며 식 7에서 S2에 대한 가설검정은 구간 1과 2 간의 기울기 차이에 대한 유의성이다.
분할 선형 성장모형에서 변곡점의 추정
많은 경우, 진학이나 발달단계의 전환점과 같이 이론적으로 의미 있는 변곡점을 선험적으로 설정할 수 있는 자료에 분할 선형 성장모형을 적용한다. 그러나 이론에 기반한 선험적 변곡점의 설정이 가능하지 않은 경우에는 변곡점 자체를 모수로서 추정할 필요가 있다. 이런 경우를 위해 자료로부터 변곡점을 실증적으로 추정하는 모형이 제안되었다(Kohli et al, 2013; Cudeck & Harring, 2007; Harring et al., 2006). Harring 등(2006)은 2개의 구간으로 구성된 분할 선형 성장모형에서 변곡점을 추정하는 모형을 제안하였으며(Harring et al., 2006) 이러한 모형은 여러 연구(예를 들어, Coman & Wu, 2018; Kohli et al., 2015a; Gerstorf et al., 2010)에서 변곡점을 추정하기 위해 사용되었다.
변곡점 γ를 기준으로 두 구간으로 나누어지는 분할 선형 성장모형을 아래 식 8과 같이 나타낼 수 있다.
식 8에서 l1과 l2는 각각 별개의 절편과 기울기 요인(I1 과 S1, I2 와 S2)을 가지는 구간 1과 2의 선형 성장함수를 나타내고 λt 는 측정 시점을 나타낸다. 식 8은 변곡점을 추정하기 위해 추가된 모수 γ 에 대한 조건부 방정식으로 표현되어 있어 이를 잠재 성장모형의 틀 안에서 모수화하는 과정이 필요하다. 식 8의 모형을 잠재성장모형의 틀 안에서 모수를 추정하기 위해 Harring 등(2006)은 변곡점 γ 에서 변곡점 전후의 성장궤적이 연결되고 두 번째 구간의 기울기가 첫 번째 구간의 기울기에 비해 작은(예를 들어, 그림 1) 형태의 성장궤적을 가정하였다. 이러한 가정 하에서 그림 1과 같은 성장궤적은 모든 구간에서 l1과 l2로 추정한 값 중에서 작은 값을 선택하는 것과 같다. 따라서 식 8의 성장함수는 아래 식 9의 함수로 표현할 수 있다.
식 9에서 min( )은 최솟값을 구하는 함수이다. 그림 1의 경우와 같이 변곡점에서 l1과 l2가 만난다고 가정한다면 식 8은 아래 식 10과 같이 정리할 수 있으며, 따라서 식 9는 식 11와 같이 정리할 수 있다.
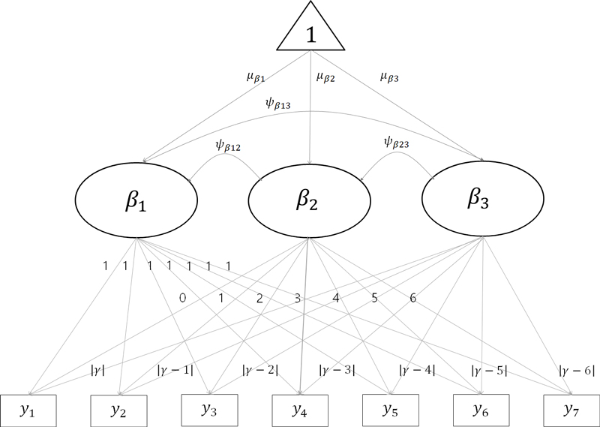
식 11의 모형은 로 재모수화하는 경우, 3개의 요인을 가지는 그림 2의 분할 선형 성장모형이 되며 그림 3의 모형은 잠재성장모형의 틀 안에서 모수를 추정할 수 있다. 식 8에서 11의 모형은 식 9의 min함수를 max로 바꿈으로써 변곡점 이후 기울기가 증가하는 형태의 성장궤적 또한 모형화 할 수 있다.
분할 선형 성장모형에서 도약의 추정
지금까지 기술한 분할 선형 성장모형은 그림 1과 같이 각 구간의 성장궤적이 변곡점에서 만나는 것을 가정한다. 그러나, 이러한 가정이 항상 만족되는 것은 아니며 변곡점에서 발생하는 급격한 변화로인해 측정값의 갑작스러운 증가 또는 감소, 즉 도약으로 인해 그림 3에서와 같이 변곡점에서 두 성장 궤적이 만나지 않는 불연속 성장궤적을 이룰 수 있다. 그림 3과 같이 변곡점에서 도약으로 인해 발생한 불연속 성장궤적은 지금까지 살펴본 분할 선형 성장모형에 도약을 추정할 수 있는 성장모형을 추가함으로서 모형화할 수 있다. 구체적으로, 도약이 존재하는 불연속 성장궤적은 아래 식 12에서와 같이 절편 요인 I2 의 추가를 통해 모형화한다.
식 12에서 λ1t, λ2t, λ3t 는 각각 시점 t 에서 성장요인 S1, l2, S2에 해당하는 요인부하량이다. 기울기 요인에서와 마찬가지로 l2의 모수화는 구간 2의 절편 또는 l1 대비 구간 2 절편의 상대적 변화량 두 가지 방식이 가능하며 후자의 방법을 사용할 경우 도약의 크기에 대한 모수화와 가설검정이 가능하다.
구체적으로, l2를 구간 1의 절편 l1에 대한 구간 2 절편의 상대적 변화량으로 모수화할 경우, l2는 도약의 크기를 나타내게 되며 도약의 크기에 대한 가설검정이 가능하다. 식 12에서 l2를 도약의 크기로 모수화하기 위해 다음과 같이 설정할 수 있다.
식 13에 따르면, 구간 1의 성장함수는 , 구간 2의 성장함수는 로 나타낼 수 있다. 시간이 변곡점에서 중심화되었기 때문에 I2요인은 구간 1의 성장함수를 통해 추정한 변곡점에서 기댓값과 구간 2의 성장함수를 통해 추정한 변곡점에서 기댓값 간의 차이를 수량화한다. 식 13에서 S2 의 모수화는 식 6에서와 같으며 S2에 대한 식 7의 모수화 방법 또한 식 9 또는 10의 I2 모수화 방법과 조합하여 사용할 수 있다.
I2를 구간 2의 절편으로 모수화하는 방법을 식 6에 추가할 경우 다음과 같이 모형을 설정할 수 있다.
식 14에 따르면 구간 1의 성장함수는 , 구간 2의 성장함수는 로 나타낼 수 있다. 따라서 I1은 구간 1 성장함수에 따른 변곡점에서 기댓값, 구간 1의 성장함수의 절편, I2는 구간 2 성장함수에 따른 변곡점에서 기댓값, 즉 구간 2의 성장함수의 절편이라는 해석이 가능하다. 식 13에서 도약에 대한 가설검정은 추가적인 절차 없이 I2 요인을 통해 가능한 반면, 식 14와 같이 I2를 모수화하는 경우에 도약에 대한 가설검정은 I1 - I2 라는 선형조합에 대한 가설검정을 통해 가능하다.
인간의 발달이나 학습의 과정과 같은 심리학의 자료에서 그림 3과 같은 도약으로 인한 불연속 성장궤적은 드문 일이 아니다. 분할 선형 성장모형을 통해 이러한 불연속 성장궤적 또한 모형화하거나 도약에 대한 가설검정이 가능하지만 많은 경우, 명시적 또는 암묵적으로 도약이 존재하지 않는다고 가정하고 변곡점에서 성장궤적이 연결되는 형태의 모형을 사용한다. 또한, Harring 등(2006)이 제안한 변곡점의 추정은 변곡점에서 구간 1과 2의 성장궤적이 연결된다는 가정이 필수적이다. 그러나 성장궤적에 도약이 존재하는 경우 성장궤적의 연속성 가정이 만족되지 않는다. 따라서, Harring 등(2006)이 제안한 변곡점 추정방법(식 8-11)은 그림 3과 같은 불연속 성장궤적에 적용할 수 없다. 도약으로 인한 불연속 성장궤적이 존재할 때 이를 모형에 반영하지 못한다면 모형설정의 오류로 이어지고 모형적합도의 저하와 모수의 추정에 편향이 발생할 것을 예상할 수 있다. 본 연구의 목표는 시뮬레이션을 통해 성장궤적에 존재하는 도약을 분할 선형 성장모형에 반영하지 못했을 때 변곡점을 포함한 모수 추정의 편향과 모형적합도의 저하를 확인하는 것이다.
방 법
시뮬레이션 자료의 생성
분할성장모형의 변곡점에 존재하는 도약을 추정하지 않았을 때 발생하는 문제를 확인하기 위해 성장궤적에 도약이 존재하는 종단자료를 생성하고 이를 Harring 등(2006)이 제안한 모형, 즉 성장궤적의 연속성에 대한 가정을 기반으로 변곡점을 추정하는 모형으로 분석하였다. 자료의 생성을 위해 도약의 크기와 구간 간 기울기의 차이를 변화시켰으며 이에 따른 분석모형의 결과에서 모형의 적합도와 성장요인 추정의 편향을 확인하였다.
생성된 자료의 시점은 총 7개이며 4번째 시점을 변곡점으로 설정하여 구간 1(시점 1에서 4)과 구간 2(시점 4에서 7)로 분할하였다. 성장궤적은 총 4개의 성장요인(I1, S1, I2, S2)으로 모수화 되었다. 주어진 시점 t 의 기댓값에 대한 성장모형은 식 15와 같다.
식 15에서 성장요인 I1, S1, I2, S2는 각각 구간 1의 절편 요인, 구간 1의 기울기 요인, 구간 2의 절편 요인, 구간 2의 기울기 요인을 나타내며 λ1t, λ2t, λ3t는 각각 시점 t 에서 성장요인 S1, I2, S2 에 해당하는 요인부하량을 나타낸다. 전술한 바와 같이 식 15에서 I2 와 S2의 해석은 요인부하량의 설정에 따라 달라지며 본 연구에서는 표 1과 같이 S2 는 구간 2의 기울기를, I2는 구간 1과 구간 2의 절편의 차이를 나타내도록 각 성장요인에 대한 요인부하량을 설정하였다. 시간 단위는 변곡점인 시점 4에서 중심화되었다. 따라서 식 13에서와 같이 도약은 I2를 통해 모수화된다.
표 1.
생성 모형의 각 성장요인에 대한 요인부하량과 각 시점에서 기댓값
| 성장요인 | |||||
|---|---|---|---|---|---|
| t | I1 | S1 | I2 | S2 | 기댓값 |
| 1 | 1 | -3 | 0 | 0 | I1 -3S1 |
| 2 | 1 | -2 | 0 | 0 | I1 -2S1 |
| 3 | 1 | -1 | 0 | 0 | I1 -S1 |
| 4 | 1 | 0 | 1 | 0 | I1+I2 |
| 5 | 1 | 0 | 1 | 1 | I1+I2+S2 |
| 6 | 1 | 0 | 1 | 2 | I1 +I2 +2S2 |
| 7 | 1 | 0 | 1 | 3 | I1 +I2 +3S2 |
성장요인들 간의 공분산은 분할 선형 성장모형을 사용한 선행 시뮬레이션 연구에서 사용한 조건을 본 연구에서도 사용하였다. 모든 조건에서 구간 1의 절편과 기울기 요인 I1과 S1의 평균은 각각 0과 1로 고정하였고 두 요인의 분산은 각각 0.2, 0.1, 두 요인 간 공분산은 0.05로 설정하였다. 구간 2의 절편(즉, 모수화 된 도약)과 기울기 요인 I2와 S2의 분산 또한 각각 0.2, 0.1, 두 요인 간 공분산은 0.05로 설정하였다(Kwok et al., 2010; Ning & Luo, 2017). 성장요인들 간의 공분산 구조가 과도하게 복잡해지지 않기 위해 서로 다른 구간의 성장요인들 간에는 공분산이 없는 것으로 설정하였다. 따라서 성장요인 (I1, S1, I2, S2) 의 분산-공분산 행렬은 다음 식 16과 같다.
오차항의 공분산 구조는 단위행렬로 설정하였다(Ning & Luo, 2017; Diallo & Morin, 2015; Kwok et al., 2010; Kwok et al., 2003)
시뮬레이션 자료의 생성을 위해 변화된 조건은 구간 1과 2간 기울기의 차이(2 조건), 도약의 크기(6 조건), 표본 크기(2 조건)로 총 24개의 조합이 만들어졌으며 각 조합에 대해 300개의 반복자료를 생성하였다. 표본 크기는 2 조건으로 설정하였는데,분할 선형 성장궤적을 확인하기 위해 필요한 표본 크기로 알려진 200을 최솟값으로(Diallo & Morin, 2015), 변곡점의 추정에 대한 이전 시뮬레이션 연구들이 설정한 최대 표본크기인 500을 최댓값으로 설정하였다(Ning & Luo, 2017; Kohli et a.l, 2015b; Feingold, 2015).
구간 1과 2간 기울기의 차이는 Raudenbush와 Liu(2001)에서 집단 간 기울기 차이를 효과크기를 통해 설정한 방법을 사용하였다. Raudenbush와 Liu(2001)는 두 집단 간 성장모형의 기울기 차이에 대한 효과크기를 다음과 같이 정의하였다.
식 17에서 δ는 효과크기, Sj와 Sk는 각각 집단 j와 k 의 성장모형의 기울기 요인이다. τ는 준거집단의 기울기 요인의 분산이다. 식 17의 Sj와 Sk를 분할 선형 성장모형의 서로 다른 구간의 성장요인으로 취급한다면 식 17을 통해 Raudenbush와 Liu(2001)가 제안한 효과크기의 기준을 구간 1과 2의 기울기 차이의 설정에 적용할 수 있다. Raudenbush와 Liu(2001)가 제안한 효과크기 기준은 큰 효과크기 δ = 0.5, 중간 효과크기 δ = 0.2이다. 구간 1의 기울기 요인 S1의 평균을 1, 분산을 0.2로 설정하였기 때문에, 구간 1과 2의 기울기 차이가 큰 효과크기일 때 구간 2의 기울기 요인 S2 요인의 평균을 0.84, 구간 1과 2의 기울기 차이가 중간 효과크기일 때 S2 요인의 평균을 0.95로 설정하였다.
변곡점에서 발생하는 도약의 크기 또한 식 17의 효과크기 δ 를 기준으로 변화시켰다. 식 15와 표 1에서 기술한 바와 같이 변곡점에서 발생하는 도약의 크기는 구간 1과 2 간 절편의 차이를 나타내는 I2로 모수화 된다. 도약의 크기 변화 또한 Raudenbush와 Liu(2001)의 효과크기 기준을 참고하였으며 본 연구에서 핵심적인 모수인만큼 효과크기 중간(0.2), 큼(0.5)에 해당하는 0.09, 0.22에 더하여 도약이 없는 조건과 세 가지의 극단적인 조건(0.36, 0.5, 0.8)을 추가하여 총 여섯 가지 조건으로 설정하였다.
시뮬레이션 자료의 분석과 결과의 평가
본 연구의 목표는 변곡점에서 도약이 존재하는 자료를 도약을 포함하지 않는 분할 선형 성장모형으로 분석할 때 발생할 수 있는 문제점을 확인하는 것이다. 따라서 전술한 방법으로 도약의 크기에 변화를 주어 생성한 자료를 Harring 등(2006)이 제안한 변곡점을 추정하는 분할 선형 성장모형(식 8-11, 그림 2)을 사용하여 분석하였다. Harring 등(2006)이 제안한 모형을 분석모형으로 사용함으로써 도약을 포함하지 않을 때 변곡점 추정에 발생할 수 있는 문제점 또한 확인하였다. 앞서 설명한 바와 같이, 변곡점에서 도약이 존재하는 자료에서 변곡점을 추정하지 않을 경우에 생길 수 있는 문제점을 확인하기 위해 분석모형을 통한 분석의 결과를 모수 추정의 정확도와 전체 모형의 적합도의 두 가지 측면에서 검증하였다. 먼저, 추정된 성장요인의 평균과 변곡점의 편향을 확인하였다. 편향은 생성모형의 모수(θ)와 분석모형을 통한 추정값의 기댓값 간의 차이로 본 연구에서는 식 18과 같이 모수와 300회의 반복에서 얻어진 추정값의 평균( ) 간의 차이에 대한 백분위편향(percentage bias)을 계산하여 사용하였다.
또한, 반복 시행에서 얻어진 각 모수추정값의 편향에 대해 3원 분산분석(표본크기 2 수준, 도약의 크기 6 수준, S2의 크기 2 수준)을 통해 모수추정값의 편향에 영향을 미치는 조건과 조건들 간의 상호작용을 확인하였다.
모수 추정의 정확도를 확인하기 위해 300회의 반복에서 얻어진 추정값 신뢰구간의 95% 포함확률(coverage probability) 또한 확인하였다. 95% 포함 확률은 시뮬레이션 자료를 분석하여 얻어진 모수 추정값의 95% 신뢰구간이 자료 생성에 사용한 모수의 값을 포함하는 비율을 의미하며 신뢰구간이 정확하게 추정된다면 포함확률은 95%에 가까운 값을 가지게 된다.
다음으로, 분석모형에 도약을 포함시키지 않을 때 발생할 수 있는 적합도의 저하를 확인하기 위해 χ2통계량과 비교적합지수(CFI, Bentler, 1990), 표준화 평균제곱잔차(SRMR; Jöreskog & Sörbom, 1989), 근사치 오차평균제곱근(RMSEA; Steiger, 1990)의 세 가지 적합도 지수에 대한 적합비율(Hit rate)을 확인하였다. 적합비율은 전체 반복에서 분석모형의 적합도가 각 적합도 지수의 일반적인 적합 기준을 만족시키는 비율로 계산하였다(Ning & Luo, 2017). 적합함의 기준은 카이제곱검정의 경우는 p≥0.05, 나머지 모형적합도 지수들은 Hu와 Bentler(1999)가 제시한 기준을 따라 RMSEA≤0.06, SRMR≤0.08, CFI≥0.95 인 경우를 모형 적합도의 기준을 충족한 것으로 판단하였다. 자료의 생성과 분석을 위해 Mplus 8.3(Muthén & Muthén, 2017)을 사용하였으며 모수의 추정은 Mplus의 기본 추정방법인 최대우도법(maximum likelihood method)을 통해 이루어졌다.
결 과
변곡점과 요인 추정값의 편향
도약의 크기에 따른 변곡점(γ), 구간 1 절편(I1), 구간 1 기울기(S1) 구간 2 기울기(S2)의 추정값에 발생하는 편향의 크기를 구간 2 기울기(S2)와 표본크기(N)의 변화 조건에 따라 표 2에 정리하였다. 먼저, 도약이 0일 때, 즉 모형설정의 오류가 없는 경우에는 대부분의 모수 추정값의 편향이 낮은 수준이었으나 변곡점(γ) 추정값의 편향은 N = 500, S2 = 0.95 일 때 –16.7%로 비교적 높은 수준의 편향을 보였다.
표 2.
모수 추정값의 백분위 편향(%)
| 도약 | 0 | 0.09 | 0.22 | 0.36 | 0.5 | 0.8 | |
|---|---|---|---|---|---|---|---|
| N = 200, S2 = 0.95 |
γ | -7.95 | -8.05 | -6.02 | 2.21 | 7.36 | 14.04 |
| I1 | 0.13 | 3.40 | 1.23 | 1.83 | 2.99 | 5.30 | |
| S1 | 1.12 | 1.26 | 6.37 | 8.91 | 13.72 | 22.92 | |
| S2 | -2.19 | -5.34 | -0.98 | -2.94 | -1.71 | 1.91 | |
| N = 500, S2 = 0.95 |
γ | -16.70 | -8.95 | 1.77 | 11.23 | 11.08 | 13.15 |
| I1 | -0.12 | 0.23 | 0.70 | 1.94 | 2.78 | 5.26 | |
| S1 | 0.68 | 2.50 | 5.33 | 9.87 | 13.55 | 23.76 | |
| S2 | -1.09 | -0.45 | -5.32 | -11.88 | -2.49 | -2.93 | |
| N = 200, S2 = 0.84 |
γ | -9.11 | -3.21 | 7.29 | 15.45 | 20.18 | 18.18 |
| I1 | 0.22 | 8.60 | 1.09 | 1.98 | 3.44 | 5.28 | |
| S1 | 2.76 | 4.47 | 6.54 | 10.10 | 14.31 | 23.56 | |
| S2 | -0.52 | -2.76 | -1.38 | -4.56 | -2.75 | -0.26 | |
| N = 500, S2 = 0.84 | γ | -7.27 | 18.50 | 15.85 | 18.50 | 18.33 | 17.23 |
| I1 | 0.03 | 2.07 | 1.02 | 2.07 | 3.15 | 5.24 | |
| S1 | 3.34 | 10.08 | 5.70 | 10.08 | 14.58 | 23.90 | |
| S2 | -1.55 | -3.24 | -2.67 | -3.24 | 5.48 | 0.98 |
도약의 크기 증가에 따라 구간 1 절편 요인 I1과 기울기 요인 S1의 추정값에 대한 백분위 편향의 크기는 대체로 증가하였다. I1의 경우, 도약의 크기가 0일 때 편향의 크기가 가장 작고 도약의 크기가 가장 클 때(0.8) 편향의 크기 또한 가장 컸으나 그 사이에서는 도약의 크기에 따른 비일관적인 변화 양상이 관찰되기도 하였다. 그러나, I1 추정값의 편향의 크기는 모든 조건에서 무시할 만한 수준 이하의 크기를 유지하였다(최대값 8.6%). S2의 경우 또한, 도약의 크기에 따른 편향의 크기의 변화가 일관적이지 않았으나 모든 조건에서 비교적 낮은 수준의 편향의 크기를 유지하였다(최대 -11.88%). 구간 1 기울기 요인(S1)의 경우 모든 조건에서 도약의 크기 증가에 따라 편향의 크기가 일관적으로 증가하였다. 변곡점 추정값 γ의 경우, 도약의 크기 증가에 따른 편향의 크기의 변화가 일관적이지 않았으나 도약의 크기가 클 때와 구간 1과 2의 기울기 차이가 클 때 편향의 크기 또한 비교적 컸다.
표 3과 4는 각각 S1과 γ 추정값의 편향에 영향을 미치는 조건을 확인하기 위해 세 가지 시뮬레이션 조건에 대해 3-way ANOVA를 실시한 결과이다. 표 2에서 예상할 수 있는 바와 같이 S1과 추정값의 편향에 가장 큰 영향을 미치는 조건은 구간 1과 2의 기울기 차이와 도약의 크기이며 이 두 조건 간, 또는 두 조건과 표본크기 간의 상호작용은 유의하지 않았다(표 3). γ 추정값의 편향의 경우(표 4), 표본크기, 구간 1과 2의 기울기 차이, 도약의 크기의 주효과, 표본크기와 도약, 기울기 차이와 도약의 상호작용이 유의한 영향을 미친 것으로 나타났다.
표 3.
구간 1 기울기(S1) 추정값 편향의 세 가지 시뮬레이션 조건에 대한 3-way ANOVA 결과
| Source | SS | DF | MS | F | p |
|---|---|---|---|---|---|
| N | 0.0007 | 1 | 0.0007 | 0.1439 | 0.7044 |
| S2 | 0.1036 | 1 | 0.1036 | 22.6605 | <0.0001 |
| I2 | 28.8823 | 5 | 5.7765 | 1263.5936 | <0.0001 |
| N × S2 | 0.0008 | 1 | 0.0008 | 0.1777 | 0.6734 |
| N × I2 | 0.0376 | 5 | 0.0075 | 1.6437 | 0.1448 |
| I2 × S2 | 0.048 | 5 | 0.0096 | 2.0991 | 0.0625 |
| N × S2 × S2 | 0.0181 | 5 | 0.0036 | 0.7926 | 0.5548 |
| Residual | 21.9567 | 4803 | 0.0046 | ||
| Total | 51.5728 | 4826 | 0.0107 |
표 4.
변곡점(γ) 추정값 편향의 세 가지 시뮬레이션 조건에 대한 3-way ANOVA 결과
| Source | SS | DF | MS | F | p |
|---|---|---|---|---|---|
| N | 4.9864 | 1 | 4.9864 | 4.5684 | 0.0326 |
| S2 | 74.7047 | 1 | 74.7047 | 68.443 | <0.0001 |
| I2 | 420.3050 | 5 | 84.061 | 77.015 | <0.0001 |
| N × S2 | 0.2621 | 1 | 0.2621 | 0.2401 | 0.6241 |
| N × I2 | 16.2922 | 5 | 3.2584 | 2.9853 | 0.0108 |
| I2 × S2 | 12.7900 | 5 | 2.5580 | 2.3436 | 0.0390 |
| N × S2 × S2 | 9.3015 | 5 | 1.8603 | 1.7044 | 0.1300 |
| Residual | 5242.4202 | 4803 | 1.0915 | ||
| Total | 5799.4292 | 4826 | 1.2017 |
도약의 크기에 따른 95% 포함확률
도약의 크기에 따른 95% 포함확률은 표 5에 요약하였다. 먼저, 도약이 0일 때, 변곡점 추정값(λ)의 포함확률은 0.95에 크게 못 미치는 것으로 확인되었다. 나머지 모수 추정값의 경우, 구간 1과 2간 기울기 변화가 작은 효과크기(S2 = 0.95)일 때 포함확률이 0.95에 가깝게(0.930에서 0.953) 나타났다. 구간 1과 2간 기울기 변화가 큰 효과크기(S2 = 0.84)일 때는 도약의 크기가 0일 때에도 전체적으로 0.95에 미치지 못하는 포함확률을 보였다(0.770 에서 0.918).
표 5.
분석모형의 95% 포함확률(coverage probability)
| 도약 | 0 | 0.09 | 0.22 | 0.36 | 0.5 | 0.8 | |
|---|---|---|---|---|---|---|---|
| N = 200, S2 = 0.95 |
γ | 0.516 | 0.559 | 0.598 | 0.542 | 0.524 | 0.519 |
| I1 | 0.953 | 0.922 | 0.916 | 0.864 | 0.765 | 0.505 | |
| S1 | 0.932 | 0.892 | 0.687 | 0.412 | 0.217 | 0.107 | |
| S2 | 0.958 | 0.922 | 0.760 | 0.689 | 0.735 | 0.854 | |
| N = 500, S2 = 0.95 |
γ | 0.413 | 0.466 | 0.466 | 0.449 | 0.464 | 0.308 |
| I1 | 0.948 | 0.937 | 0.921 | 0.787 | 0.608 | 0.192 | |
| S1 | 0.952 | 0.859 | 0.450 | 0.169 | 0.139 | 0.079 | |
| S2 | 0.930 | 0.791 | 0.651 | 0.646 | 0.665 | 0.792 | |
| N = 200, S2 = 0.84 |
γ | 0.568 | 0.610 | 0.594 | 0.592 | 0.569 | 0.478 |
| I1 | 0.918 | 0.923 | 0.900 | 0.853 | 0.767 | 0.518 | |
| S1 | 0.891 | 0.852 | 0.689 | 0.288 | 0.074 | 0.036 | |
| S2 | 0.869 | 0.813 | 0.844 | 0.864 | 0.906 | 0.936 | |
| N = 500, S2 = 0.84 | γ | 0.588 | 0.593 | 0.628 | 0.609 | 0.540 | 0.223 |
| I1 | 0.897 | 0.910 | 0.866 | 0.772 | 0.540 | 0.166 | |
| S1 | 0.806 | 0.709 | 0.384 | 0.056 | 0.000 | 0.011 | |
| S2 | 0.770 | 0.741 | 0.849 | 0.878 | 0.898 | 0.908 |
표 5에서 도약의 크기가 증가함에 따라 모수 추정값의 95% 포함확률이 대체로 감소하는 것을 확인할 수 있다. N = 200, S2 = 0.84를 제외한 모든 조건에서 I1과 S1의 포함확률은 도약의 크기 증가와 함께 포함확률이 감소하였다. N = 200, S2 = 0.84의 조건에서 또한 대체로 도약의 크기 증가에 따라 포함확률이 감소하는 양상을 보였다. 이는 도약을 추정하지 않는 오설정된 모형에서 해당 모수에 대한 영가설이 과도하게 기각될 수 있음을 의미한다. 변곡점 추정값(γ)과 구간2 기울기(S2)의 경우 도약의 증가에 따른 포함확률 변화의 양상이 일관적이지 않았다. 변곡점 추정값의 포함확률은 조건의 변화와 관계없이 일관적으로 0.5 정도의 낮은 값을 보였으며 도약이 가장 크고 표본크기가 500인 조건에서는 상대적으로 더 낮은 값을 보였다(0.223에서 0.308). 또한, 변곡점 추정값을 비롯한 대부분의 모수 추정값의 포함확률이 표본크기가 200일 때에 비해 500일 때 더 작았는데 이는 표본크기의 증가로 인한 표준오차의 감소에 기인하는 것일 수 있다.
도약의 크기에 따른 모형적합도
표 6은 도약의 크기에 따른 분석모형의 적합도의 변화를 적합비율(hit rate)을 통해 보여준다. 도약의 크기가 0일 때, 카이제곱검정의 적합비율은 예상할 수 있는 바와 같이 표본크기가 커짐에 따라 감소했으며 0.438에서 0.779의 적합비율을 보였다. RMSEA의 경우 0.831에서 0.944의 범위를 가지며 표본의 크기가 커질수록, 구간 1과 2간의 기울기 차이가 작을수록 높은 적합비율을 보였다. SRMR의 경우, 표본 크기에 따라 눈에 띄게 다른 결과를 보여주었으며 표본크기가 작을 때 적합비율이 상대적으로 낮았다. CFI는 0.727에서 0.857의 적합비율을 보였다. 도약의 크기의 증가에 따라 이를 추정하지 않는 분석모형의 적합비율은 일관적으로 감소하였으며 도약이 가장 큰 조건에서는 0에 가까운 적합비율을 보였다. 도약의 크기의 증가에 따라 이를 추정하지 않는 분석모형의 적합비율은 모두 감소하였다.
표 6.
도약의 크기에 따른 분석모형의 적합비율(hit rate)
| 도약의 크기 | 0 | 0.09 | 0.22 | 0.36 | 0.5 | 0.8 | |
|---|---|---|---|---|---|---|---|
| N = 200, S2 = 0.95 |
2검정 p≥.05 | 0.779 | 0.779 | 0.626 | 0.384 | 0.181 | 0.000 |
| RMSEA≤0.06 | 0.863 | 0.814 | 0.687 | 0.452 | 0.259 | 0.005 | |
| SRMR≤0.08 | 0.505 | 0.456 | 0.307 | 0.136 | 0.060 | 0.000 | |
| CFI≥0.95 | 0.758 | 0.745 | 0.581 | 0.350 | 0.180 | 0.000 | |
| N = 500, S2 = 0.95 |
2검정 p≥.05 | 0.496 | 0.418 | 0.169 | 0.034 | 0.000 | 0.000 |
| RMSEA≤0.06 | 0.944 | 0.903 | 0.757 | 0.315 | 0.067 | 0.000 | |
| SRMR≤0.08 | 0.857 | 0.791 | 0.656 | 0.258 | 0.046 | 0.000 | |
| CFI≥0.95 | 0.857 | 0.816 | 0.619 | 0.185 | 0.031 | 0.000 | |
| N = 200, S2 = 0.84 |
2검정 p≥.05 | 0.749 | 0.665 | 0.572 | 0.372 | 0.203 | 0.004 |
| RMSEA≤0.06 | 0.831 | 0.764 | 0.639 | 0.445 | 0.292 | 0.008 | |
| SRMR≤0.08 | 0.415 | 0.363 | 0.244 | 0.100 | 0.045 | 0.000 | |
| CFI≥0.95 | 0.727 | 0.659 | 0.533 | 0.356 | 0.198 | 0.004 | |
| N = 500, S2 = 0.84 | 2검정 p≥.05 | 0.438 | 0.333 | 0.169 | 0.036 | 0.000 | 0.000 |
| RMSEA≤0.06 | 0.867 | 0.799 | 0.698 | 0.477 | 0.094 | 0.000 | |
| SRMR≤0.08 | 0.783 | 0.698 | 0.547 | 0.284 | 0.051 | 0.000 | |
| CFI≥0.95 | 0.769 | 0.704 | 0.581 | 0.259 | 0.030 | 0.000 |
논 의
본 연구에서 변곡점에서 도약이 존재하는 불연속 성장궤적을 가진 자료의 분석을 위해 분할 선형 성장모형을 사용할 때 도약을 모형에 포함하지 않는 경우 발생할 수 있는 문제점을 시뮬레이션을 통해 확인하였다. 자료의 생성에 사용된 다양한 조건에서 도약을 포함하지 않음으로 인한 분할 선형 성장모형 설정의 오류는 분석의 결과에서 모수 추정의 편향과 모형 적합도의 저하로 이어짐을 확인하였다. 본 연구의 결과에 대한 요약과 논의는 다음과 같다.
먼저, 생성모형의 도약의 크기를 증가시켰을 때, 이를 포함하지 못하는 분석모형의 추정값이 가지는 편향의 변화 양상은 모수에 따라 다르게 나타났다. 도약의 증가에 따른 편향의 증가는 구간 1 기울기 S1에서 가장 두드러졌으며, 구간 1 절편 요인 I1의 경우 도약의 크기 증가에 따라 편향의 크기가 증가했으나 그 크기가 매우 낮은 수준에 머물렀다. 구간 2 기울기(S2) 추정값 또한 모든 조건에서 낮은 수준의 편향을 보여주었으며 이는 I1과 S2 추정은 모형에 포함되지 않은 도약의 크기에 상대적으로 적은 영향을 받는다는 것을 보여준다. 변곡점(γ) 추정값의 편향의 크기는 도약의 크기 증가에 따라 일관성 있는 변화가 확인되지 않았으나 표본크기와 구간 1과 2의 기울기 차이의 영향 또한 중요한 것으로 나타났다.
도약의 크기를 증가시킬 때 구간 2 기울기의 편향에 비해 구간 1 기울기 S1의 편향의 증가가 훨씬 뚜렷했으며 이는 자료 생성에 사용한 조건 때문일 수 있다. 본 연구에서 사용한 생성모형은 S1을 고정시키고 S2의 크기를 변화시킴으로써 구간 1과 2의 기울기 차이를 조절하였으며 모든 조건에서 공통적으로 S1 > S2, 즉 구간 1 기울기에 비해 구간 2 기울기가 작게 설정되었다. 따라서 분석모형이 가지는 변곡점에서 성장궤적이 만난다는 가정을 만족시키기 위해 구간 1과 구간 2의 기울기 추정값이 모수값과 달라질 때, 구간 2의 기울기 S2에 비해 큰 구간 1의 기울기 S1에서 모수값으로부터의 편향이 상대적으로 크게 발생했을 가능성이 있다. S1 추정값의 편향 크기에 대한 분산분석의 결과에서 도약의 크기 뿐만 아니라 S1과 S2의 차이가 편향의 크기에 영향을 미치는 중요한 조건으로 확인된 것 또한 이러한 가능성을 뒷받침한다고 할 수 있다. 이를 구체적으로 확인하기 위해서는 구간 1과 2의 기울기 차이가 S1 < S2 인 조건을 포함하는 생성모형을 사용한 시뮬레이션 연구 또한 필요할 것이다.
95% 신뢰구간의 포함확률의 경우, 도약의 크기가 증가함에 따라 구간 1 절편(l1)과 기울기(S1) 신뢰구간의 포함확률은 대체로 감소하였다. 이러한 결과와 함께 앞서 살펴본 도약의 크기에 따른 편향의 증가를 고려할 때, 실제 자료에 존재하는 도약이 모형에 포함되지 않는다면 두 성장요인에 대한 가설검정이 영가설의 과도한 기각으로 인해 잘못된 결론으로 이어질 수 있음을 시사한다. 특히 변곡점 추정값은 전체적으로 낮은 포함확률을 보였는데, 이러한 결과는 구간 1과 2의 기울기 차이가 클 때 추정값의 편향 또한 비교적 컸던 결과와 함께(표 2) 특히 구간 간 기울기 차이가 클 때 변곡점의 추정이 정확하지 않을 수 있음을 시사한다.
도약의 크기가 증가함에 따라 각 적합도지수의 기준을 만족시키는 결과의 비율, 즉 적합비율은 대체로 감소하였다. 그러나 적합비율이 감소하는 양상은 적합도 지수 간에 차이가 있었다. 도약의 크기 증가에 따라 가장 뚜렷한 감소 양상을 보인 경우는 RMSEA와 CFI 였다. RMSEA의 경우, 도약의 크기가 0인 경우에는 모든 조건에서 0.8 이상의 충분한 적합도를 보였으며 도약의 증가에 따라 적합도가 눈에 띄게 감소함으로써 도약을 모형에 포함하지 않음으로 인한 모형설정의 오류에 민감한 모습을 보였다. CFI의 경우, 도약의 크기가 0일 때의 적합비율이 RMSEA에 비해서는 낮지만 비교적 높은 수준을 보였으며 도약의 증가에 따라 적합비율이 눈에 띄게 감소하였다. SRMR의 경우는 도약의 크기에 따른 적합비율이 감소하였으나 표본크기가 200일 때는 도약이 0인 조건에서도 충분한 수준의 적합비율을 가지지 않았으며 이는 SRMR이 표본크기에 상당한 영향을 받음을 시사한다. 그 뿐 아니라, 본 연구의 생성모형에서 잔차 간 상관은 지정하지 않았으나 SRMR의 값은 잔차 간 상관의 영향을 받을 수 있다. 그러나 모든 생성 자료의 잔차 상관 행렬을 확인하는 것은 불가능하였다. 적합비율의 결과를 고려할 때 분할성장모형 설정의 오류를 확인하기에는 RMSEA와 CFI가 다른 적합도 지수에 비해 더 유용하다고 할 수 있다.
본 연구의 결과를 통해 분할 선형 성장모형의 실질적인 적용에 대한 시사점을 도출할 수 있다. 먼저, 변곡점의 위치에 대한 이론적 근거가 존재하는 경우에는 성장궤적에 도약이 없다는 충분한 근거가 존재하지 않는 이상 모형에 도약을 포함하는 것이 적절할 것이다. 본 연구의 결과에서 생성모형의 도약의 크기가 커질수록 이를 포함하지 않는 분석모형은 모수 추정의 편향, 95% 포함확률, 모형 적합도의 측면에서 대체로 부정적인 결과를 보여주었으며 이러한 부정적 결과는 본 연구에서 설정한 최대 크기의 도약의 조건일 때 가장 두드러졌다. 따라서 분할 선형 성장모형의 적용에서 식 13과 같은 모수화 방법을 통해 도약의 존재를 실증적으로 검정할 수 있으며, 도약이 존재하는 경우에는 식 13 또는 14의 방법으로 도약을 모형에 포함함으로써 모형 설정의 오류를 최소화 하고 모수 추정의 정확도와 모형의 적합도를 향상시킬 수 있을 것이다.
변곡점의 위치에 대한 이론적 근거가 빈약하거나 존재하지 않고 변곡점을 추정해야 하는 경우는 Harring 등(2006)이 제안한 방법을 통해 변곡점을 추정한 다음 도약으로 인한 불연속 궤적을 확인하는 전략을 사용할 수 있을 것이다. Harring 등(2006)이 제안한 방법은 변곡점에서 성장궤적이 연결된다는 가정을 가지기 때문에 도약을 추정하지는 못한다. 따라서 Harring 등(2006)의 모형을 통해 변곡점의 위치를 추정한 후, 추정된 지점에 변곡점을 고정하고 식 9 또는 10의 도약을 포함하는 분할 선형 성장모형을 적용하여 도약의 존재를 실증적으로 확인하고 그 크기를 추정할 수 있다. 그러나 변곡점 추정값의 편향의 크기와 신뢰구간의 낮은 포함확률을 고려한다면 자료에 도약이 존재하고 구간 간 기울기 차이가 클 때는 변곡점의 추정이 정확하지 않을 수 있으며, 이를 보완하기 위해서는 추정된 변곡점 전후로 서로 다른 변곡점을 사용한 분할 선형 성장모형을 비교하는 과정이 추가로 필요할 것이다. 특히 RMSEA와 CFI는 변곡점을 추정하지 않음으로 인한 모형의 부적합에 민감하다는 것이 확인되었으며 이러한 적합도 지수를 활용한 경쟁모형 간 비교는 최적의 모형의 선택에 도움이 될 것이다.
본 연구를 통해 도약이 존재하는 불연속 성장궤적을 가지는 종단자료의 분석을 위한 분할 선형 성장모형의 적용에서 도약을 모형에 포함하지 않을 때 발생할 수 있는 잠재적인 문제점을 확인할 수 있었다. 그러나 본 연구의 결과를 비선형 성장궤적의 분석을 위해 분할 선형 성장모형을 사용하는 다양한 상황에 적용하기 위해서는 본 연구가 가지는 아래의 한계점을 고려할 필요가 있다.
먼저, 대부분의 시뮬레이션 연구에서와 마찬가지로 본 연구에서 생성한 자료는 실제 자료가 가지는 다양한 조건을 모두 반영하지는 못한다. 본 연구에서 사용한 비선형 성장궤적의 양상, 오차항의 공분산 구조와 분포가정, 성장요인들의 분산-공분산 행렬의 구조 등의 조건을 실제 자료가 모두 만족시키는 경우는 흔하지 않을 것이다. 예를 들어, 본 연구에서는 구간 1과 2의 성장요인들 간에는 공분산이 없는 것으로 가정하였지만 실제로는 구간 1과 구간 2의 성장요인들 간에 공분산이 존재할 수 있으며 이러한 공분산은 분할 선형 성장모형의 모수 추정에 영향을 미칠 수 있다(Diallo & Morin, 2015). Diallo 와 Morin(2015)의 연구에서는 서로 다른 구간의 성장요인들 간 공분산뿐만 아니라 측정시점의 수, 기울기의 크기, 표본크기, 변곡점의 위치 등 다양한 요소가 분할 선형 성장모형의 모수 추정에 영향을 미칠 수 있는 것으로 확인되었다. 그러나 단일 시뮬레이션 연구에서 이러한 조건을 모두 포함하는 것은 비현실적이다. 본 연구에서 사용한 생성 및 분석 모형은 두 개의 선형 성장궤적으로 이루어지고 공변인 또한 포함하지 않는 비교적 단순한 모형이다. 이를 통해 본 연구의 결과는 분할 선형 성장모형을 사용한 분석에서 도약을 추정할 필요성을 보여주었으나 이러한 결과를 분할 선형 성장모형을 적용하는 다양한 상황에 일반화하기 위해서는 본 연구에서 사용한 모형 외에 다양한 형태의 모형과 조건을 포함한 연구가 필요할 것이다.
전술한 한계점과 관련하여, 본 연구에서 발견한 몇 가지 예상을 벗어난 결과의 원인을 확인하기 위해서는 일부 모수에 초점을 맞춘 자료를 생성할 필요가 있을 것이다. 구체적으로, 본 연구에서 분할 선형 성장모형에서 도약의 생략은 모형 설정의 중요한 오류이며 그 크기가 커질수록 모수 추정의 편향의 증가과 적합도의 저하로 이어질 것으로 예상하였다. 그러나 변곡점(γ)과 구간2 기울기 요인(S2)의 추정은 이러한 양상을 따르지 않았다. 이러한 결과는 전술한 바와 같이 본 연구에서 사용한 자료 생성 방식의 영향일 수 있으며 이러한 가능성을 확인하기 위해서는 도약의 크기와 구간 간 기울기 차이의 다양한 조합을 사용한 자료를 생성할 필요가 있을 것이다. 특히, 구간 2의 기울기 요인의 편향에 비해 구간 1 기울기 요인의 편향이 매우 큰 폭으로 변화하였는데 이러한 결과가 구간 1 기울기에 비해 구간 2 기울기가 작게 설정한 생성조건 때문인지를 확인하기 위해서는 구간 1의 기울기 요인이 구간 2의 기울기 요인보다 작은 조건으로 자료를 생성할 필요가 있을 것이다.
다음으로, 본 연구에서 사용한 Hu와 Bentler (1999)의 적합도 지수의 기준은 지금까지 많은 연구에서 사용되었으나 여전히 논쟁의 대상이다. 여러 연구에서 연속선상의 근사적합도지수를 바탕으로 이분적 판단을 내리는 것의 문제점을 지적했으며(Markland, 2007), Hu와 Bentler(1999)가 제안한 기준값의 일반화 가능성에 대해 의문을 제기하였다(Beauducel & Wittman, 2005; Yuan, 2005; Marsh et al., 2004). 이러한 연구에 따르면 모형의 적합도 기준의 적용은 표본크기, 모형의 크기, 모형 설정 오류의 양상 등 다양한 조건에 따라 달라질 뿐만 아니라 모형의 구조에 따라서도 달라진다. 따라서 적합도 기준을 다양한 형태의 모형에 일괄적으로 적용하는 것은 잘못된 결론으로 이어질 수 있으며 모형의 적합함의 기준은 개별 모형의 틀 안에서 결정할 필요가 있다. Hu와 Bentler(1999)의 적합도 지수의 기준이 분할 선형 성장모형에서 어떻게 적용되는지에 대한 연구가 부족한 상황에서 이러한 기준을 통과한 모형은 적합한 모형이고 통과하지 못한 모형은 적합하지 않다는 해석보다는 본 연구에서 확인한 적합비율의 결과는 도약의 크기 변화에 따른 적합비율의 변화의 측면에서 해석하는 것이 적절하다. 또한, Hu와 Bentler(1999)의 적합도 기준은 여전히 많은 실제 연구자들이 사용하고 있기 때문에 이러한 기준을 만족시키는 결과의 비율과 도약의 크기에 따른 변화는 분할 선형 성장모형의 실질적 적용에 대한 함의를 가진다고 할 수 있다.
앞서 언급한 제한점에도 불구하고 본 연구에서는 분할 선형 성장모형의 적용에서 자주 간과되는 불연속성장궤적의 도약이 모형에 포함되지 않았을 때 발생할 수 있는 잠재적인 문제점을 확인한 최초의 연구이다. 분할 선형 성장모형에서 도약을 포함하지 않는 모형설정의 오류(misspecification)는 모형에 포함되지 않은 도약의 크기가 클수록 모수의 추정과 모형의 적합도에 부정적인 영향을 미치는 것으로 확인되었으며 이러한 문제를 피하기 위해서는 분할 선형 성장모형을 사용한 분석에서 도약을 항상 모수에 포함시켜서 그 존재를 실증적으로 검정하는 것이 바람직하다고 할 수 있다.
참고문헌
황혜영, 김나영 (2021). 분할함수 잠재성장모형을 활용한 청소년의 학업 자아개념, 사회 자아개념 및 학업 스트레스의 종단적 관계 분석. 중등교육연구, 69(4), 529-556. https://www.kci.go.kr/kciportal/ci/sereArticleSearch/ciSereArtiView.kci?sereArticleSearchBean.artiId=ART002792386
Dick, D. M., Cho, S. B., Latendresse, S. J., Aliev, F., Nurnberger Jr, J. I., Edenberg, H. J., ... & Kuperman, S. (2014). Genetic influences on alcohol use across stages of development: GABRA2 and longitudinal trajectories of drunkenness from adolescence to young adulthood. Addiction biology, 19(6), 1055-1064.
Muthén, B., & Muthén, L. (2017). Mplus [Computer software and manual]. https://www.statmodel.com