최근 양적 방법론 영역에서는 몬테카를로(Monte Carlo) 시뮬레이션, 즉 현장에서 실제로 수집된 자료가 아닌 특정 조건을 만족하기 위해 생성된 가상의 자료를 이용하여 모형을 추정하는 연구가 활발히 진행되고 있다. 시뮬레이션 연구의 가장 큰 장점은 특정한 조건 아래에서 모형 추정의 결과를 확인할 수 있다는 것이다. 예를 들어, 어떠한 모형을 추정하기 위한 최소 표본크기의 결정(Kim, 2012; Muthén & Muthén, 2002; Wang et al., 2021), 모형을 잘못 설정하였을 때의 적합도 변화 양상 확인(Depaoli et al., 2022; Leite & Stapleton, 2011) 등 여러 가지 주제에 대해 연구하는 것이 가능하다. 특히, 사회과학 연구에서 흔히 사용되는 자료들의 경우 확인적 요인분석 모형이나 구조방정식 모형 등의 사용에 필수적인 정규성 가정을 만족하지 못하는 문제가 빈번하게 발생함에 따라(Blanca et al., 2013; Micceri, 1989), 자료의 비정규성이 모형의 추정(Maydeu-Olivares, 2017; Nevitt & Hancock, 2001) 또는 적합도에 미치는 영향(Brosseau-Liard & Savalei, 2014; Gao et al., 2019)을 탐색하는 연구 역시 함께 발전되었다. 해당 연구들의 경우 시뮬레이션을 진행하기 위해 정규분포를 따르지 않는 자료를 생성하는 것이 중요한데, 지금까지 independent generator(IG) 변환법(IG transformation; Foldnes & Olsson, 2016), copula 접근법(copula approach; Mair et al., 2012)과 같은 다양한 비정규 자료 생성 방법들이 소개된 것에 반해 실질적인 비정규 자료 생성 절차에 대해 구체적으로 논의한 연구는 드물다. 이에 본 연구는 몬테카를로 시뮬레이션을 위한 비정규 자료 생성 과정을 단계별로 설명함으로써 이와 관련한 시뮬레이션을 진행하는 방법론 연구자들에게 가이드라인을 제시하고자 한다. 특히 최근 가장 많이 사용되고 있는 비정규 자료 생성 방법인 power method(Fleishman, 1978; Headrick, 2002; Vale & Maurelli, 1983)를 중심으로 전반적인 과정을 설명함으로써 양적 방법론 연구자들이 실질적으로 참고할 수 있는 정보를 제공한다.
Power method는 Fleishman(1978)이 처음 제안한 방법으로, 먼저 표준정규분포를 따르는 임의의 변수를 생성한 뒤 해당 변수가 특정 왜도 및 첨도를 갖도록 3차 방정식을 이용하여 해당 변수를 변환한다. 이후 Vale과 Maurelli(1983)는 단변량 자료에 국한되어 있던 Fleishman(1978)의 연구를 다변량 자료로 확장하는 방안에 대해 논의하였으며, Headrick (2002)은 보다 정확한 비정규 자료를 생성할 수 있도록 3차 방정식을 5차 방정식으로 확장하여 이용하였다. 이와 같은 발전 과정을 모두 종합해 보았을 때 power method는 변환식(3차 혹은 5차 방정식)을 이용하여 비정규 자료를 생성하는 방법이라 볼 수 있다. 이 가운데 3차 방정식을 이용하는 power method의 경우 특정 조건을 만족하는 변환식이 여러 개 존재하는 중복도(multiplicity) 문제(Astivia & Zumbo, 2018; Helwig, 2022), 혹은 실제 자료 생성 시 설정한 비정규성 기준보다 낮은 값이 나타나는 하향 편향(downward bias)의 발생(Astivia & Zumbo, 2015; Morgan, 2020)과 같은 단점을 갖고 있음에도 불구하고 그 원리와 과정의 간명성으로 인하여 여러 통계 프로그램에 적용되어 있으며, 전체 비정규 자료 생성 방법 가운데 가장 많이 이용된다. 실제로 power method의 높은 사용성은 비정규성의 정도가 확인적 요인분석 모형의 추정에 미치는 영향을 확인한 Curran 등(1996)과 같은 유명한 연구나 정규성 가정을 요구하지 않는 새로운 CFI (comparative fit index) 신뢰구간 계산 방법을 제안하고 시뮬레이션을 통해 해당 방법의 유효성을 확인한 Lai(2019)와 같은 최신 연구에서 확인할 수 있다. 뿐만 아니라 3차 방정식을 이용하는 Fleishman(1978) 및 Vale과 Maurelli (1983)의 인용 횟수는 다른 비정규 자료 생성 방법들에 비해 월등히 높은 것으로 나타났다(Astivia & Zumbo, 2018).
이처럼 상대적으로 높은 사용 빈도에도 불구하고 실제로 연구자가 power method를 이용하여 비정규 자료를 생성하는 것은 여전히 쉽지 않다. 그 이유는 power method를 이용하여 비정규 자료를 생성하는 전반적인 절차를 자세히 정리하여 제공한 선행연구가 거의 없기 때문이다. 비정규성과 관련하여 시뮬레이션을 진행한 국외 연구의 경우 자료 생성 방법의 종류만을 언급하거나(Fairchild et al., 2024; Savalei & Falk, 2014; Suh, 2015) 그 원리를 간략하게 설명할 뿐(Astivia & Zumbo, 2015, 2018; Morgan, 2020) 전반적인 생성 절차에 대해 설명한 연구는 찾기 힘들다. 국내 연구 또한 자료 생성 방법의 종류만을 언급하였을 뿐(구남욱, 2014; 이슬 & 장승민, 2014), 사용된 방법의 원리 및 절차에 대한 설명은 포함되어 있지 않다. 비정규 자료의 생성에 실질적인 어려움이 따르는 또 다른 이유는 자료 생성에 이용되는 프로그램의 사용에 대한 정보가 부족한 것이다. 비록 Fairchild 등(2024)이 자료 생성 방법에 따라 사용할 수 있는 프로그램의 종류를 정리하였으나 해당 연구의 경우 실제 사용을 위한 함수 혹은 코드에 대한 구체적인 설명이 부족하다는 한계를 갖는다. 구남욱(2014)은 R 프로그램을 이용하여 비정규 자료를 생성하였다고 언급하였으나 마찬가지로 연구자가 응용할 수 있는 관련 코드나 설명은 존재하지 않는다. 이처럼 비정규 자료 생성과 관련한 정보의 부족은 방법론 연구자들이 power method를 이용하여 시뮬레이션 자료를 생성하는 데에 어려움을 초래한다.
따라서 본 연구는 현재 빈번하게 사용되고 있는 power method를 바탕으로 비정규 자료 생성의 원리 및 절차를 구체적으로 설명함으로써 비정규성 관련 시뮬레이션을 보다 용이하게 진행할 수 있는 가이드라인을 제공하고자 한다. 특히 사회과학 연구에서 많이 사용되는 Mplus(Muthén & Muthén, 1998-2017)와 R(R Core Team, 2024)을 이용해 시뮬레이션 장면에서 연구자가 power method를 직접적으로 이용할 수 있도록 관련 코드 또한 제공할 것이다. 이를 위하여 우선 power method의 기본 개념과 원리를 정리하고 전반적인 자료 생성 절차에 대해 설명한다. 다음으로 R의 lavaan 패키지(Rosseel, 2012) 내에 존재하는 비정규 자료 생성 함수와 아규먼트(argument)를 구체적으로 설명함으로써 비정규 자료 생성 방법에 대한 이해를 높인다. 마지막으로 앞서 설명한 일련의 자료 생성 절차 및 관련 코드를 실제 예시를 통해 보임으로써 연구자가 참고할 수 있는 실질적인 도구를 제공한다.
Power method의 이론적 배경
첫 섹션에서는 3차 방정식을 이용하는 power method의 원리를 발전 과정 순으로 설명하고, 이를 이용할 수 있는 lavaan 패키지를 소개한다. 이와 더불어 해당 패키지를 이용할 때 참고해야 할 주의 사항들에 대해 논의한다.
Fleishman(1978)의 단변량 비정규 자료 생성
Fleishman(1978)에 의해 처음 제안된 power method는 표준정규분포를 따르는 자료를 3차 다항식을 이용해 비정규 자료로 변환하는 방법이다. 즉, power method를 이용하기 위해서는 표준정규분포를 따르는 자료를 1차적으로 표집한 뒤 3차 다항식을 이용해 해당 자료를 변환해야 한다. 변환 과정에 사용되는 식으로 인해 해당 방법은 3차 다항식 변환법(third-order polynomial transformation)이라고도 불리며, 자료 변환에 사용되는 3차 다항식은 다음과 같다.
위 식에서 X는 표준정규분포를 따르는 임의의 표집된 변수, Y는 연구자가 얻게 될 특정 왜도 및 첨도를 갖는 변수, a, b, c, d는 변수 Y의 왜도 및 첨도를 조절하는 다항식의 계수이다. 연구자가 얻고자 하는 변수 Y는 표준정규분포를 따르는 변수 X와 다항식의 계수들에 의해 정의되며 다항식의 계수값에 따라 자료의 비정규성 정도는 달라진다. 즉, 연구자가 설정한 왜도와 첨도를 만족하는 자료가 생성되도록 3차 다항식의 계수를 올바르게 설정하는 것이 power method의 핵심이라고 할 수 있다.
식 1의 계수는 변수 Y의 정의된 평균, 분산, 왜도 및 첨도를 다항식의 계수를 이용하여 표현함으로써 산출될 수 있다. 이 과정에서 평균, 분산, 왜도, 첨도와 관련된 변수 Y의 1차 적률(E(Y)), 2차 적률(E(Y2)), 3차 적률(E(Y3)), 4차 적률(E(Y4))이 이용된다. 변수 Y의 1차부터 4차 적률을 각각 0, 1, γ1, γ2, 즉 변수 Y의 평균을 0, 분산을 1, 왜도를 γ1, 첨도를 γ2로 설정했을 때 이들은 다항식의 계수를 통해 다음과 같이 정리될 수 있다.
식 2부터 5는 순서대로 변수 Y의 평균, 분산, 왜도, 첨도를 다항식의 계수를 통해 표현한 것으로, 식 1의 계수들은 식 2부터 5까지의 비선형 연립방정식을 만족하는 해를 구함으로써 결정된다. 다시 말해, Fleishman(1978)의 방법은 식 1을 통해 정의된 변수 Y의 기술통계치가 특정 값을 만족하도록 하는 다항식의 계수를 확인하고 이를 이용하여 비정규 자료를 생성해 내는 방법이라 할 수 있다.
Vale과 Maurelli(1983)의 다변량 확장
Fleishman(1978)이 제안한 비정규 자료 생성 방법은 자료 변환의 원리가 기술통계치의 계산 공식에 기반하고 있어 그 과정을 직관적으로 이해할 수 있다는 장점이 존재하지만, 단변량 비정규 자료만을 생성할 수 있다는 단점을 갖는다. 일반적인 시뮬레이션 연구에서는 모형에 기반하여 변수들 간의 관계를 상정한 다변량 비정규 자료를 이용하므로, Vale과 Maurelli(1983)는 이러한 Fleishman(1978)의 단점을 극복하고자 해당 방법을 다변량 장면으로 확장하는 방안을 제안하였다.
3차 다항식 변환법을 이용하여 다변량 자료를 생성하는 경우에 연구자는 설정한 변수 간의 관계가 상정된 변수 X들을 표집한 뒤 식 1을 이용해 각 변수를 변환한다. 하지만 이와 같은 방법을 사용하게 되면, 변환 전에 설정한 변수들 간의 관계, 즉 상관계수(또는 공분산) 값이 변환 후에도 동일하게 유지되지 않는다는 문제가 발생한다. 이와 같은 문제를 해결하기 위해 Vale과 Maurelli(1983)는 중간상관행렬(intermediate correlation matrix)이라는 개념을 도입하였는데, 이는 자료 변환 후에도 변수들 간의 관계가 달라지지 않도록 조정하는 행렬을 의미한다. 설명을 위해 표준정규분포를 따르는 X1과 X2를 이용하여 변수들 간의 상관계수가 rY1Y2이면서 각 변수의 평균이 0, 분산은 1, 왜도는 γ1, 첨도는 γ2인 변수 Y1과 Y2를 생성한다고 가정한다. 이를 바탕으로 변수 Y1과 Y2는 다음과 같이 정의될 수 있다.
위 식에서 벡터 x1과 x2는 각각 변수 X1과 X2로 구성되어 있으며, 벡터 w1과 w1는 각각 변수 Y1과 Y2의 비정규성을 조절하는 3차 방정식의 가중치(polynomial weights), 즉 계수를 의미한다. 변수 Y1과 Y2는 표준화되어 있으므로, 두 변수 간 상관계수는 두 변수의 곱의 평균(expected cross product)과 동일하며 다음과 같이 정리될 수 있다.
이때 벡터 x1과 x2를 구성하는 변수 X1과 X2는 표준정규분포를 따르므로 E(x1x2')은 변수 X1과 X2 간의 상관계수인 rX1X2로 이루어진 상관행렬 R로 정의될 수 있으며 다음과 같이 정리된다.
가중치 w1과 w2의 경우 상수로 이루어져 있으므로, 식 9를 이용하여 식 8을 다음과 같이 풀어 쓸 수 있다.
a1 = -c1과 a2 = -c2(식 2 참조)를 바탕으로 rY1Y2는 다항식의 계수와 rX1X2를 통해 최종적으로 다음과 같이 표현될 수 있다.
정리하면, Vale과 Maurelli(1983)의 방법은 식 1을 통해 자료를 변환하더라도 rY1Y2가 사전에 설정한 값으로 유지되도록 하는 중간상관계수(intermedieate correlation) rX1X2로 구성된 중간상관행렬 R과 다항식의 계수들(즉, w1과 w2)을 찾음으로써 연구자가 원하는 다변량 비정규 자료를 생성한다. 즉, 이 방법은 자료의 비정규성에 대한 정보만을 포함하였던 비선형 연립방정식에 변수들 간의 관계에 대한 정보를 추가함으로써 power method의 사용성을 다변량 자료로 확장시켰다고 볼 수 있다.
power method를 이용할 수 있는 lavaan 패키지
3차 방정식을 이용하는 power method의 핵심은 연구자가 설정한 비정규성 조건을 만족하도록 하는 방정식의 계수와 생성된 변수들 간의 관계를 만족하는 원변수들 간의 상관계수(즉, rX1X2)를 확인하는 것이다. 비선형 연립방정식(식 2, 3, 4, 5, 11 참고)을 설정하고 이들의 해를 산출하는 일련의 과정은 연구자가 직접 실시하거나 혹은 통계 프로그램을 이용해 자동으로 수행할 수 있으며, 이후 식 1을 통해 비정규 자료를 생성하게 된다. 현재 여러 통계 프로그램 가운데 R의 경우 비선형 연립방정식의 해를 확인할 수 있는 패키지(Demirtas et al., 2021)부터 실제 비정규 자료를 생성하는 패키지(Fialkowski, 2018)까지 power method와 관련된 다양한 패키지들을 연구자의 필요에 따라 선택하여 이용할 수 있다는 장점이 있다. 특히 사회과학 영역에서 많이 사용되는 R의 lavaan 패키지는 power method를 이용한 자료 생성에 있어서 다른 패키지 및 프로그램들과 차별되는 몇 가지 강점을 갖는다. 첫째, 구조방정식 모형이나 잠재성장모형과 같은 구조방정식의 틀에서 표현되는 다양한 모형들을 바탕으로 비정규 자료를 생성할 수 있다. 다시 말해, 모형에 대한 정보가 존재하지 않는 다변량 자료만을 생성할 수 있는 다른 패키지들과 달리 lavaan 패키지를 이용하면 연구자가 설정한 연구 모형의 모수에 대한 정보와 비정규성 기준을 동시에 반영하는 자료를 생성할 수 있다. 둘째, R의 특징을 기반으로 필요에 따라 다른 패키지들의 기능을 결합하여 사용하는 것이 가능하다. 즉, lavaan 패키지가 지원하지 않는 추가적인 기능이 필요할 경우 해당 기능을 지원하는 다른 패키지들을 불러들여 보완할 수 있다. 연구자는 이러한 장점을 이용하여 단순히 비정규 자료를 생성하는 것에 그치지 않고 추가적인 함수를 이용해 자료의 저장 및 정리와 같은 작업들을 동시에 실시함으로써 자료 생성과 사용의 편의성을 높일 수 있다. 셋째, R과 함께 사회과학 영역에서 많이 사용되는 Mplus와 연동하여 응용하는 것이 가능하다. 사회과학 통계 모형의 시뮬레이션 연구에서 많이 사용되는 Mplus에는 power method가 내장되어 있지 않으므로 power method를 이용한 비정규 자료 생성이 불가능하다. 이에 따라 Mplus에서 power method를 이용한 시뮬레이션을 실시하기 위해서는 다른 프로그램을 이용하여 비정규 자료를 생성한 후 이를 바탕으로 Mplus의 외부 시뮬레이션(external simulation)을 실행하는 것이 필요하다. lavaan 패키지는 앞서 언급한 장점들을 바탕으로 비정규 자료뿐만 아니라 Mplus의 외부 시뮬레이션을 실시하기 위한 추가적인 정보들 또한 쉽게 생성 가능하다. 이에 따라 lavaan 패키지는 구조방정식 모형을 이용하여 비정규성 시뮬레이션을 실시하고자 하는 연구자들에게 보다 실용적인 도구로 사용될 수 있다.
이와 같은 장점에도 불구하고, 실제로 lavaan 패키지를 이용하여 비정규성 자료를 생성하는 절차를 상세히 서술한 연구는 매우 부족하다. 이는 시뮬레이션 상황에서 비정규 자료 생성 절차에 대한 전반적인 설명이나 코드 예시 등 연구자가 실질적으로 필요로 하는 정보들을 쉽게 얻을 수 없음을 의미한다. 자료 생성 절차에 대한 전반적인 설명의 부재는 연구자가 어떠한 순서로 자료를 생성해야 하는지 알기 힘든 문제를 초래할 수 있으며, 코드와 같은 실질적인 도구의 부재는 연구자가 비정규 자료 생성의 원리를 이해했더라도 실제 해당 방법의 사용을 어렵게 한다. 특히 power method를 이용하기 위해 lavaan 패키지를 사용할 경우 자칫 잘못하면 연구자가 원하는 정확한 비정규 자료를 생성하지 못하는 문제가 생길 수 있으므로 주의해야 한다.
먼저, lavaan 패키지의 자료 생성 함수는 단 하나의 자료 세트만을 생성하기 때문에, 시뮬레이션 조건에 맞는 개수의 자료 세트를 생성하기 위해서는 해당 함수를 반복 수행하도록 코드를 추가 작성해야 한다. 이 과정에서 함수의 특정 아규먼트를 제대로 설정하지 않을 경우 생성된 모든 자료가 동일한 정보를 갖는, 즉 여러 개의 동일한 자료 세트가 생성되는 문제가 발생해 시뮬레이션에서 이용할 수 없다. 이와 더불어 함수를 반복 수행하도록 코드를 작성할 때 자료를 생성하면서 동시에 이를 외부 파일로 저장하고, 저장된 파일명에 대한 정보를 한 번에 정리할 수 있도록 해야 한다. 이는 자료가 의도대로 정확하게 생성되었는지 확인하는 과정에 필요할 뿐만 아니라, 확인 후 해당 자료를 이용하여 시뮬레이션을 실시하는 과정에도 사용되기 때문이다. 즉, 비정규 자료를 생성하면서 동시에 그 결과물로부터 파생된 여러 개의 추가 자료를 함께 사용할 수 있도록 코드를 생성해야만 생성된 자료의 질을 확인하고 Mplus에서 외부 시뮬레이션을 실시할 수 있다. 따라서 본 연구는 다음 섹션에서 이와 같은 주의사항들을 고려하면서 lavaan 패키지를 통해 비정규 자료를 생성하는 절차에 대해 구체적으로 설명한다.
lavaan 패키지를 이용한 비정규 자료 생성
이번 섹션에서는 시뮬레이션에 사용되는 비정규 자료의 생성 절차 전반을 설명하고, 각 단계에서 실행해야 하는 내용들을 구체적으로 제시한다. 특히 lavaan 패키지와 Mplus를 이용하는 단계의 함수와 코드를 자세히 설명함으로써 연구자가 lavaan 패키지를 통해 비정규 자료를 생성하는 데 있어 필수적으로 인지하고 있어야 하는 내용을 논의한다.1)
전반적인 시뮬레이션 자료 생성 과정
정규성 가정이 위배 된 상황에서 시뮬레이션을 진행하고자 할 때 자료는 크게 세 단계를 통해 생성된다. 첫 번째 단계에서는 연구 모형의 특성 및 비정규성의 기준을 설정하며 생성될 자료의 조건을 결정한다. 두 번째 단계에서는 power method를 이용해 이전 단계에서 설정한 조건을 만족하는 자료를 생성한다. 마지막 단계에서는 두 가지 기준을 통해 생성된 자료가 조건을 정확하게 만족하는지 확인한다.
Step 1: 연구 모형 및 비정규성 기준 설정
첫 번째 단계에서는 연구 목적에 맞는 모형과 비정규성의 기준을 설정한다. 예를 들어, 연구자가 확인적 요인분석 모형을 연구 모형으로 설정했을 경우, 요인의 개수, 요인 간 상관, 요인당 지표변수의 개수, 오차 간 상관 등 세부적인 모형의 특성을 결정한다. 이와 같은 특성들은 선행연구를 참고하거나 혹은 연구 목적에 맞게 연구자가 직접 설정할 수 있다. 자료의 비정규성 기준, 즉 변수의 왜도 및 첨도 또한 선행연구를 바탕으로 결정할 수 있다. 일반적으로는 Curran 등(1996)이 제안한 비정규성 기준(왜도와 첨도의 절대값이 각각 2와 7 이상)을 이용하지만 연구 목적에 따라 다른 기준을 사용하는 것 역시 가능하다(Lai, 2018). 이와 같이 첫 번째 단계에서 설정되는 내용은 연구의 목적에 따라 달라지며, 본론의 마지막 부분에서 예시와 함께 더욱 자세히 설명한다.
Step 2: lavaan 패키지를 이용한 자료 생성
두 번째 단계인 비정규 자료 생성 단계는 연구자가 선택한 방법과 프로그램을 이용하여 실제로 비정규 자료를 생성한다. 본 연구에서는 R의 lavaan 패키지에서 power method를 기반으로 작동하는 자료 생성 함수의 이용 방법을 구체적으로 설명한다. 자료 생성을 위해서는 우선 R 프로그램과 함께 lavaan 패키지가 설치되어 있어야 하는데, R에서 패키지를 다운로드하는 함수는 install.packages()로 설치하고자 하는 패키지명을 괄호 안에 “”를 포함하여 작성함으로써 해당 패키지를 다운로드할 수 있다. 다운로드한 패키지는 library() 함수를 통해 설치될 수 있으며, 이때는 “”를 이용하지 않고 패키지명만을 기재해야 한다. 만약 이용하고자 하는 패키지가 이미 다운로드 되어 있는 경우, library() 함수만을 실행하여 패키지를 설치한다. 패키지와 관련한 사전작업이 완료되면 생성된 자료가 저장될 작업 경로를 설정해야 한다. 현재 설정되어 있는 작업 경로는 getwd()를 통해 확인할 수 있으며, 작업 경로의 변경은 setwd() 함수의 괄호 안에 연구자가 원하는 세부 경로를 지정함으로써 가능하다. 일련의 과정이 완료되었다면 lavaan 패키지를 이용한 비정규 자료 생성의 기초 작업은 끝났다고 볼 수 있다.
다음으로, 연구자가 설정한 연구 모형과 모수를 자료에 반영하기 위해서는 연구 모형에 대한 정보를 R 환경에서 하나의 객체(object)로 지정하고 이를 자료 생성 과정에 이용해야 한다. lavaan 패키지는 구조방정식의 틀에서 모형을 표현할 수 있는 4가지의 모형 문법을 제공하는데, 먼저 ‘=~’는 관찰변수를 이용하여 잠재변수를 측정할 때 사용되는 표현으로 Mplus의 ‘by’와 의미 및 기능이 동일하다. ‘~~’는 변수들의 분산 및 공분산을 측정할 때 사용되며 Mplus의 ‘with’와 동일하다. ‘~’는 회귀모형을 규정할 때 이용되며 Mplus의 ‘on’와 동일하다. 마지막으로 ‘~1’은 절편을 추정하고자 할 때 사용되는 문법으로, Mplus의 ‘[ ]’와 동일하다. 만약 연구자가 확인적 요인분석 모형을 바탕으로 시뮬레이션을 진행하고자 한다면 ‘=~’를 이용하여 잠재변수를 표현하고, ‘~~’를 이용하여 요인 간 분산 및 공분산과 지표변수의 오차분산을 표현할 수 있다. 이와 같은 lavaan 패키지의 모형 문법을 통해 연구자는 연구 모형에 대한 정보를 목적에 맞게 설정한 뒤, 이를 특정 이름의 객체로 저장한 후 자료 생성 함수의 아규먼트로 사용한다.
lavaan 패키지에 내장된 여러 함수 가운데 시뮬레이션 자료를 생성하는 함수는 simulateData()로, 연구자는 이를 이용해 앞서 객체로 저장한 모형에 대한 정보를 바탕으로 정규분포를 따르는 자료, 또는 정규분포를 따르지 않는 비정규 자료를 생성할 수 있다. simulateData() 함수를 이용하기 위해 정의해야 하는 주요 아규먼트 가운데 ‘model’은 자료 생성의 바탕이 되는 연구 모형을 의미하며, 앞서 설정한 연구 모형의 객체를 그 값으로 지정한다. 이를 통해 simulateData() 함수는 연구 모형에서 설정한 변수들 간의 관계가 반영된 자료를 생성하게 된다. ‘model.type’은 연구자가 설정한 모형의 종류를 의미하며, 확인적 요인분석 모형을 의미하는 ‘cfa’, 구조방정식 모형을 의미하는 ‘sem’, 잠재성장모형을 의미하는 ‘growth’ 총 세 가지 유형을 선택할 수 있다. ‘meanstructure’는 평균 구조의 포함 여부를 의미하는데, 전통적인 구조방정식의 경우 이를 포함하지 않는 것이 일반적이나 잠재성장모형에는 필수적으로 포함된다. ‘std.lv’는 잠재변수들의 분산을 1로 고정함으로써 변수들을 표준화하는 것을 의미하며, ‘sample.nobs’는 생성될 자료의 표본크기를 의미한다. ‘skewness’와 ‘kurtosis’는 생성될 자료의 왜도 및 첨도, 즉 자료의 비정규성을 설정하는 핵심 아규먼트로, 각 아규먼트를 특정한 값으로 고정하면 연구 모형에 대하여 설정한 모든 조건을 만족하는 비정규 자료를 생성할 수 있다. 만약 해당 아규먼트들의 값을 설정하지 않을 경우 simulateData()는 연구 모형에 대하여 설정한 조건들을 만족하면서 정규분포를 따르는 자료를 생성한다. 마지막으로 ‘seed’는 난수 생성 공식에 사용되는 시작값으로, 어떠한 값으로 설정하는지에 따라 생성된 자료는 달라진다. 반대로 다른 모든 조건이 동일하다는 가정하에 ‘seed’ 또한 같은 값이 입력될 경우 정확히 동일한 자료가 생성된다. 이러한 특징을 이용하여 ‘seed’는 동일한 자료를 생성한 뒤 결과를 확인하고자 할 때 사용될 수 있다. 그림 1은 비정규 자료 생성의 기초 작업부터 simulateData() 함수의 사용까지의 과정을 실제 코드로 나타낸 것으로, 해당 코드에 사용된 경로 등은 본 연구자가 예시를 위해 적용한 값이다.
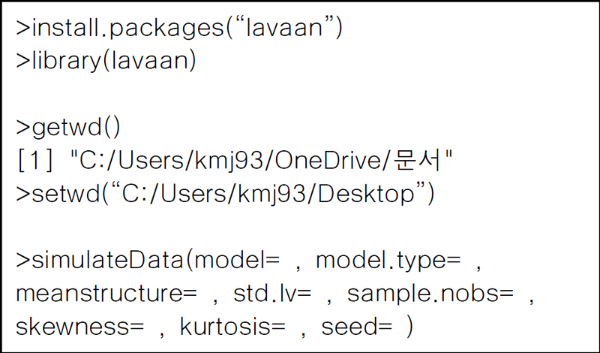
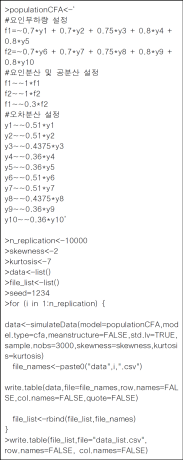
일반적으로 시뮬레이션 연구를 진행하기 위해서는 여러 세트의 자료를 생성해야 하지만, simulateData() 함수는 단 하나의 자료 세트만을 제공한다. 이는 해당 함수의 아규먼트 중 replication, 즉 생성할 자료 세트의 개수에 대한 아규먼트가 존재하지 않기 때문이다. 이에 따라 다수의 자료 세트를 생성하기 위해서는 ‘for’문을 이용하여 simulateData() 함수를 원하는 자료 세트의 수만큼 반복 수행해야 한다.2) ‘for’문은 1부터 연구자가 직접 설정하는 횟수 n까지 { } 내에 i가 포함된 코드를 반복하여 실시하도록 하는 명령문이다. 다시 말해, ‘for’문의 { } 내에 simulateData() 함수 내용을 작성하면 연구자가 지정한 반복 횟수 n번 만큼 해당 함수를 반복 수행하여 n개의 자료 세트를 생성하게 된다. ‘for’문의 장점은 반복 수행 과정에서 자료의 생성과 저장을 동시에 할 수 있다는 것으로, 원하는 개수의 자료를 생성하면서 동시에 자료를 외부 파일로 저장하고 이 저장된 파일들의 이름에 대한 정보가 담긴 또 하나의 파일을 생성하는 것이 가능하다. 다만 자료 생성 함수를 실행하기에 앞서, 생성될 자료와 파일명이 저장될 빈 공간(리스트)을 만들고 반복 수행 횟수를 하나의 객체로 지정하는 작업이 우선되어야 한다. 객체의 이름은 연구자가 원하는 대로 설정할 수 있으며, 본 예시에서는 그림 2에 서술된 바와 같이 n_replication으로 지정하였다. 덧붙여, 자료의 확인이 필요할 때에는 함수 내부의 아규먼트가 아닌 ‘for’문 시작 전에 난수 생성 시작 값을 지정해야 한다. 이는 이전 섹션에서 언급하였듯이 seed 값을 아규먼트로 설정한 후 반복문을 실시하면, 함수가 수행될 때마다 난수 생성이 다시 처음부터 실시되므로 결국 동일한 자료 세트가 반복 횟수만큼 생성되는 문제가 발생하기 때문이다.
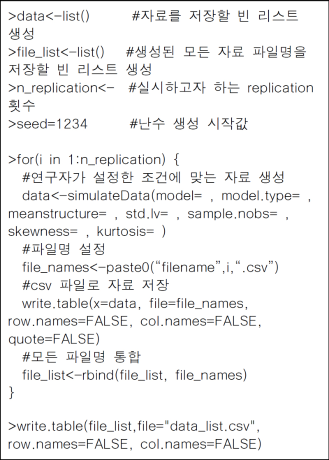
다음으로 ‘for’문을 이용하여 1부터 설정한 n_replication 횟수만큼 { }내에 작성한 simulateData()를 반복 수행한다. 회차마다 생성된 자료는 사전에 설정한 data라는 빈 리스트에 저장된다. 그 후 생성된 자료를 파일로 저장하기 위해 먼저 paste0() 함수를 사용하여 파일명을 설정한다. R에 내장되어 있는 paste0() 함수는 설정한 아규먼트들을 띄어쓰기 없이 하나로 통합하는 함수로, 그림 2의 코드에서는 “filename”(파일명)과 “i”(실시 회차), 그리고 “.csv”(확장자명)를 하나로 통합한다. 해당 함수를 이용해 각 회차별 파일명은 ‘filenamei.csv’의 형식으로 저장된다. 이후 내장함수인 write.table() 함수를 이용하여 생성된 자료를 앞서 설정한 파일명으로 저장한다. 해당 함수는 자료를 파일로 저장할 때 사용되는 함수로, 해당 함수의 아규먼트 가운데 ‘x’는 저장할 자료를, ‘file’은 자료파일의 이름을 의미한다. ‘row.names’는 행 이름의 포함 여부, ‘col.names’는 열 이름의 포함 여부를 의미하는데, simulateData() 함수에서 해당 내용에 대해 따로 지정하지 않았으므로 모두 FALSE로 지정한다. ‘quote’는 자료의 각 값에 큰따옴표를 설정할지의 여부를 의미하며 이용하지 않는 기능이므로 FALSE로 설정한다. 그 후 설정한 파일명은 기존 객체에 행을 추가하는 rbind() 함수를 이용하여 file_list 객체에 누적하여 저장된다. 회차가 끝날 때마다 생성되는 모든 자료 파일은 사전에 setwd()를 이용하여 설정한 작업 경로(혹은 설정하지 않았을 경우 getwd()를 통해 확인한 작업 경로)에 저장된다. 모든 회차가 완료된 후에는 작업 경로에 설정한 반복 횟수만큼의 자료 세트가 생성되며, file_list 객체에는 저장된 모든 파일명이 포함되어 있다. 파일명에 대한 정보 또한 외부 파일로 저장해야 Mplus에서 이용할 수 있으므로 write.table() 함수를 이용하여 작업 경로에 저장한다. 해당 함수의 아규먼트에 대한 설명은 앞과 동일하다.
Step 3: 자료 평가
lavaan 패키지를 이용해 생성된 비정규 자료는 두 가지 기준을 통해 자료가 정확하게 생성되었는지 평가할 수 있다. 첫 번째는 생성된 자료를 이용해 모형을 추정함으로써 모형 추정치가 모형 모수(model parameter) 값과 일치하는지 확인하는 것이며, 두 번째는 변수들의 왜도 및 첨도를 확인해 연구자가 사전에 설정한 비정규성 기준을 만족하는지 확인하는 것이다. 만일 생성된 자료가 두 가지 기준을 모두 만족한다면 올바른 자료가 생성되었다고 판단할 수 있으며, 이를 이용해 시뮬레이션을 진행할 수 있다.
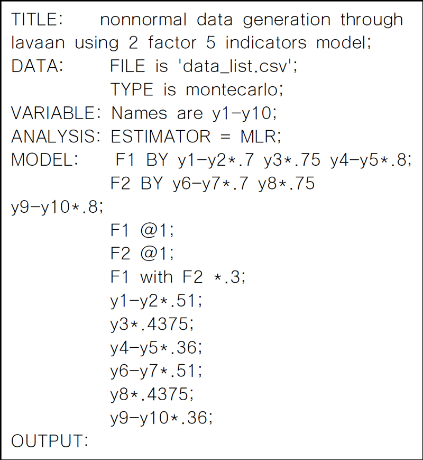
모형 추정치와 모수의 비교. 설정한 모수가 자료에 정확히 반영되어 있는지 확인하기 위해서는 모형 추정치를 확인해야 한다. 이는 새롭게 생성된 비정규 자료에 대하여 Mplus의 외부 시뮬레이션 기능을 이용해 모형을 추정함으로써 확인할 수 있다. 일반적으로 모형을 추정하기 위해 사용되는 Mplus의 input 명령어에서 VARIABLE, ANALYSIS, MODEL, OUTPUT 등의 커맨드는 연구자가 설정한 모형 및 추정 방법에 맞춰 작성한다. 그다음 DATA 커맨드만 그림 3과 같이 작성하면 새롭게 생성된 자료들을 전부 이용하여 모형을 추정할 수 있다.
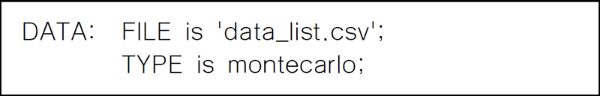
위의 DATA 커맨드의 FILE 값으로 설정된 ‘data_list.csv’, 즉 데이터 파일은 생성된 모든 자료 세트의 파일명에 대한 정보를 포함하고 있어야 한다. 또한, 해당 파일은 생성된 자료 파일과 동일한 경로에 저장되어 있어야 한다. 다음으로 TYPE 값은 ‘montecarlo’로 설정함으로써 Mplus의 외부 시뮬레이션을 실시할 수 있다. 이와 같이 작성된 input 파일을 실행하면 생성된 모든 비정규 자료 세트를 이용하여 추정된 모형 모수 추정치들의 평균 및 관련 준거(criteria)에 대한 정보를 output 파일로 얻을 수 있다. 해당 내용은 자료의 평가뿐 아니라 이후 자료의 분석 단계에서도 동일하게 사용된다.
자료의 왜도 및 첨도 확인. 모형 추정에 사용되는 Mplus의 경우 시뮬레이션에서 변수의 일변량 왜도 및 첨도에 대한 정보를 제공하지 않으므로, 자료의 비정규성을 확인하기 위해 R을 이용한다. 이는 생성한 모든 자료에 대하여 변수의 왜도 및 첨도를 앞서 언급한 ‘for’문을 이용하여 쉽게 확인할 수 있기 때문이다. 해당 작업을 위해 작업 경로는 자료가 저장되어 있는 경로로 설정되어야 한다. 이는 저장된 자료를 R의 환경으로 불러온 후 작업해야 하기 때문이다. 변수들의 왜도 및 첨도를 확인하기 위해서는 psych 패키지(Revelle, 2024)의 describe() 함수가 필요하다. 만일 해당 패키지가 다운로드 되어있지 않은 경우 install.packages()와 library()를 이용하여 해당 패키지를 설치한다. 이후 기술통계치를 확인하기 전에 필요한 객체들을 우선 설정하며, 코드는 그림 4와 같다.
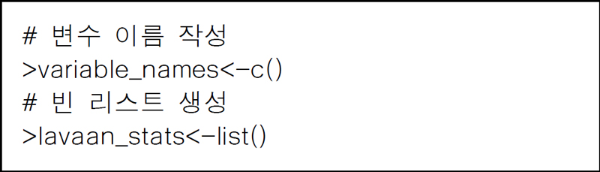
앞의 자료 생성 단계에서 변수명을 자료 내에 포함하지 않았으므로, 추후 구분을 위해 먼저 변수명을 지정한다. c() 함수는 괄호 안에 작성한 내용을 이용하여 벡터를 생성하는 함수로, 사용할 변수 이름을 “” 안에 작성한다. 예를 들어 y1부터 y3까지 3개의 변수를 생성했다면, c(“y1”, “y2”, “y3”)와 같이 작성함으로써 각 변수들의 이름을 설정할 수 있다. 다음으로 자료별로 확인한 기술통계치 결과를 저장할 빈 리스트를 생성한다. 마지막으로, 설정한 반복 횟수만큼(n_replication) 저장된 자료를 불러오고, 각 자료마다 왜도 및 첨도를 포함한 기술통계치를 계산한 후 이들을 누적하여 하나의 파일로 저장하도록 그림 5와 같이 코드를 작성한다. 불러올 파일명은 paste0()를 이용해 설정하며, 이는 앞서 지정한 자료 파일명에 따라 내용이 달라진다. 이후 read.table() 함수를 이용하여 파일을 불러오고, 이를 ‘dat’이라는 이름의 객체로 지정한다. 이때 설정하는 아규먼트 값 중 ‘header’는 파일 내 변수명에 대한 정보 유무를 나타내며, 변수명이 포함되어 있지 않을 경우 FALSE로 설정한다. 자료에 변수명에 대한 정보가 없을 경우 names()를 이용하여 해당 자료의 변수명을 설정할 수 있다. names()는 괄호 안에 지정한 자료의 변수명을 확인하는 함수로, 이를 기존에 설정한 변수명 객체로 대체하여 변수명을 변경할 수 있다. 다음으로, psych 패키지에서 제공하는 describe() 함수를 통해 불러온 자료 객체, 즉 dat의 기술통계치를 계산하고 그 결과물을 ‘stats’라는 이름의 객체에 저장한다. R에서 $는 특정 열을 지정하는 기호로, 추후 결과를 확인할 때 혼동을 피하기 위해 describe() 결과에서 제공되는 ‘vars’열을 사전에 설정해 둔 변수명 벡터로 대체한다. 이후 몇 번째 파일에 대한 기술통계치 결과인지 구분하기 위해 파일 번호를 추가한다. 마지막으로 모든 자료 파일에 대한 기술통계치 결과를 누적하여 저장한다. 이는 사전에 생성한 객체(즉, lavaan_stats)에 결과가 저장된 객체(즉, stats)를 병합함으로써 가능해진다. 이를 위해서는 두 객체의 자료 구조가 통일되어야 하므로 list() 함수를 이용해 stats 객체의 자료 구조를 리스트로 변환한다. 그다음 c() 함수를 이용하여 두 객체를 병합한다.
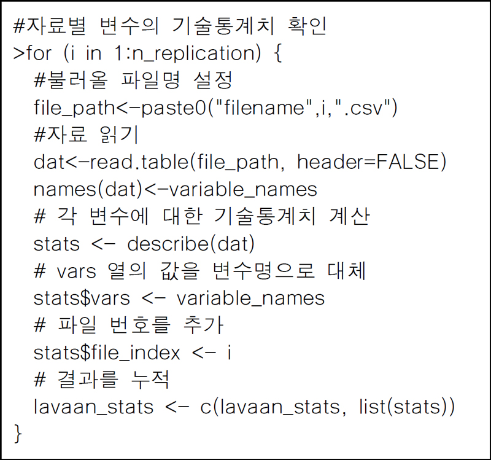
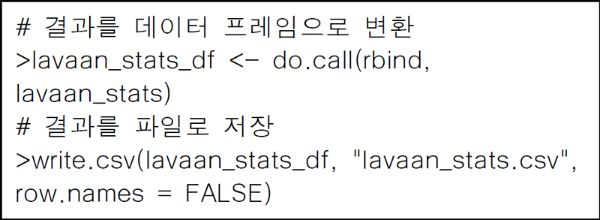
사전에 지정한 반복 횟수만큼 코드가 실행되면, 연구자는 모든 자료에 대한 기술통계치 결과가 통합 저장된 lavaan_stats 객체를 얻게 된다. 연구자는 R에서 describe() 함수를 이용하거나, 해당 객체를 외부 파일로 저장한 후 SPSS와 같은 다른 프로그램을 이용함으로써 변수별 평균 왜도 및 첨도를 계산할 수 있다. R 외의 프로그램을 이용하기 위해 기술통계치 결과를 외부 파일로 저장하는 코드는 그림 6과 같다. 우선 병합된 lavaan_stats 객체는 자료 구조가 리스트이므로, 이를 외부 파일로 저장하기 위해 구조를 데이터 프레임(data frame)으로 변환한다. 이를 위해서는 특정 함수를 반복해서 사용하는 do.call() 함수를 이용한다. do.call() 함수는 첫 번째 아규먼트에 적힌 함수를 두 번째 아규먼트인 리스트 자료에 반복 적용하는 함수로, 앞서 병합한 리스트 유형의 기술통계치 결과를 데이터 프레임으로 변환하기 위해 사용될 수 있다. 해당 함수를 이용하여 자료 구조를 데이터 프레임으로 변환한 후, write.csv() 함수를 이용하여 기술통계치 결과들을 .csv 파일로 저장한다. 그림 6의 코드에서는 모든 기술통계치 결과를 통합한 lavaan_stats_df를 lavaan_stats.csv라는 이름의 파일로 저장하며, row.names 아규먼트를 FALSE로 지정하여 행 이름을 저장하지 않았다. 자료 생성 및 평가 절차에서 사용된 모든 R 프로그램 함수들은 부록에 표로 제시되어 있다.
lavaan 패키지를 이용한 실제 비정규 자료 생성 예시
앞서 시뮬레이션 자료를 생성하는 단계 및 lavaan과 Mplus를 연동하여 사용하는 방법에 대해 구체적으로 설명하였다. 이번 섹션에서는 실제 예시를 통해 전체적인 자료 생성 절차 및 결과를 제공함으로써 해당 방법에 대한 연구자들의 이해를 높인다.
연구 모형 및 비정규성 설정
본 연구에서는 요인당 5개의 지표변수를 갖는 이요인 모형(two factor model)이 고려되었다. 분석의 간명성을 위해 요인부하량과 오차분산은 두 요인에 대하여 모두 동일한 값으로 지정되었다. 구체적으로 요인부하량(즉, λ1부터 λ10)은 Hu 등(1992) 및 Yuan과 Bentler(1998)를 참고하여, 0.7, 0.7, 0.75, 0.8, 0.8, 0.7, 0.7, 0.75, 0.8, 0.8로 설정하였으며, 요인 분산(즉, ϕ1과 ϕ2)은 모두 1로 설정하였다. 이에 따라 각 지표변수의 오차분산(즉, ψ1부터 ψ10)은 각각 0.51, 0.51, 0.4375, 0.36, 0.36, 0.51, 0.51, 0.4375, 0.36, 0.36으로 자동 설정되었다. 마지막으로 요인 간 공분산(즉, ϕ12)은 0.3으로 설정하였으며, 자료의 비정규성 정도는 Curran 등(1996)의 기준에 따라 모든 지표변수에 대하여 왜도 2, 첨도 7로 설정하였다.
자료 생성
lavaan 패키지를 이용하여 비정규 자료를 생성하기 위해, 본 연구는 lavaan 패키지의 문법을 바탕으로 그림 7에 작성된 내용과 같이 모형을 설정하고 ‘populationCFA’라는 이름의 객체에 저장하였다. 설정한 모형을 바탕으로 표본크기는 표본이 모집단의 특성을 가지고 있을 것으로 기대하기에 충분히 큰 값인 N = 3000으로 설정하였으며, n_replication은 10000으로 설정하여 총 10,000개의 자료 세트를 생성하였다. 다음으로 지표변수의 왜도 및 첨도를 객체로 지정한 뒤 이를 함수의 아규먼트 값으로 설정하였다. 이는 만약 연구자가 비정규성 기준을 다른 값으로 수정하고자 할 때 코드 수정을 편리하게 하기 위함으로, 함수 내부 아규먼트의 값을 직접 설정하여도 동일한 결과를 생성한다. 그림 7에 제시된 모든 코드를 작성한 뒤 수행하게 되면 “data1.csv”부터 “data10000.csv”까지 총 10,000개의 서로 다른 비정규 자료가 생성되며, “data_list.csv”파일에서 저장된 모든 자료 파일명을 확인할 수 있다.
자료 평가
lavaan 패키지를 통해 생성된 비정규 자료는 두 가지 측면에서 자료의 적절성이 평가되었다. 먼저, 생성된 자료가 사전에 설정했던 비정규성의 기준, 즉 왜도 2와 첨도 7의 기준을 만족하는지 확인하였다. 이를 위해 모든 지표변수의 왜도와 첨도의 평균, 표준편차, 상대적 편향(relative bias, RB)이 검토되었다. RB는 설정한 모수와 추정치 간의 상대적 차이를 의미하며, 다음과 같이 정의된다.
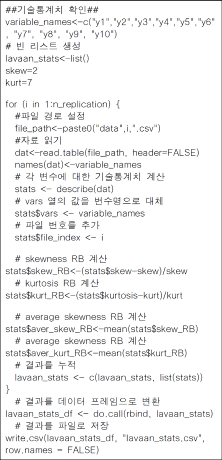
위 식에서 θk는 k번째 모수값이며 은 생성된 모든 자료 세트에 대한 k번째 모수의 추정치들의 평균을 의미한다. RB가 작을수록 연구 조건에서 설정한 비정규성을 정확히 반영한 자료가 생성되었다고 볼 수 있다. 선행연구의 기준에 따라(Curran et al., 1996; Flora & Curran, 2004; Kaplan, 1989), 5% 미만의 RB는 trivial bias, 5%에서 10% 사이의 RB는 moderate bias, 10%보다 큰 RB는 substantial bias를 나타내는 것으로 해석된다. 그림 8에 제시된 R 코드는 모든 자료의 기술통계치를 계산하고 외부 파일로 저장한 후, SPSS 등을 통해 각 변수들이 설정한 검토 기준들을 만족하는지 확인하기 위한 코드이다.
다음으로, 모형 추정치가 설정한 모수를 올바르게 반영하는지 확인하기 위해 Mplus에서 생성된 자료를 이용하여 모형을 추정하였다. 이요인 모형을 추정하기 위해 Mplus 8(Muthén & Muthén, 1998-2019)을 이용하였으며, 모형 추정 방법으로는 비정규 자료의 추정에 널리 이용되는 강건한 ML 추정 방법(Mplus의 MLR 추정 옵션)을 이용하였다. MLR은 모수의 검정에는 수정된 표준오차를 이용하고(Huber, 1967; White, 1980), 모형의 적합도 검정에는 보정계수(scaling correction factor)를 적용한 χ2을 이용함으로써(Satorra & Bentler, 1994, 2001) 정규성 위배에 따른 거짓유의성(false positive)의 발생을 감소시키는 것으로 알려져 있다. Mplus에서 제공하는 결과 중 자료를 평가하기 위해 모든 모수(즉, 요인 분산, 요인부하량 및 오차분산)의 상대적 편향(RB), 평균 제곱근 오차(root mean square error, RMSE), 그리고 95% 커버리지(coverage rate)가 검토되었다. RMSE는 시뮬레이션에서 반복 추정에 따른 모수 추정치의 변동성을 나타내는 값으로 다음과 같이 정의된다.
위 식에서 는 k번째 모수 추정치들의 분산을 의미하며, 해당 값이 0에 가까울수록 모형의 모수를 함의하고 있는 자료가 안정적으로 생성되었다고 볼 수 있다. 95% 커버리지는 생성된 모든 자료 세트 중에서 95% 신뢰구간에 모수가 포함되는 비율을 의미하며, Muthén과 Muthén(2002)의 기준에 따라 .91에서 .98 사이의 값을 갖는 경우 설정한 모형의 모수를 만족하는 자료가 생성된 것으로 간주한다. 모형 추정에 사용된 Mplus 신택스는 그림 9에 서술된 바와 같다.
먼저 자료의 적절성을 평가하고자 생성된 비정규 자료의 왜도 및 첨도를 확인하였으며 그 결과는 표 1과 2에 제공된다. 표 1을 보면, 지표변수들의 왜도 평균이 1.984부터 1.990으로서, RB는 –0.8%에서 –0.5%로 5% 미만인 것을 확인할 수 있다. 또한, 표 2를 보면, 지표변수들의 첨도 평균은 6.813에서 6.889로서, RB는 –2.7%에서 –1.6%로 왜도의 경우와 마찬가지로 5% 미만인 것을 알 수 있다. 왜도 및 첨도의 평균을 확인했을 때 설정한 왜도 및 첨도보다 다소 낮은 값이 나타났으나, 이는 Astivia와 Zumbo(2015) 및 Morgan(2020)이 지적했던 바와 같이 power method를 통해 생성된 비정규 자료의 왜도 및 첨도에서 하향 편향(downward bias)이 발생하는 경향이 존재한다는 결과와 일맥상통한다. 전체적으로 보았을 때, 자료의 비정규성이 모두 평가 기준을 만족하였으므로, lavaan 패키지를 통해 생성된 비정규 자료는 사전에 설정한 왜도 및 첨도를 만족한다고 할 수 있다.
표 1.
생성된 변수들의 왜도의 평균, 표준편차, 상대적 편향(RB) 결과
| Indicator | mean | sd | RB |
|---|---|---|---|
| y1 | 1.989 | 0.202 | -0.005 |
| y2 | 1.990 | 0.204 | -0.005 |
| y3 | 1.986 | 0.206 | -0.007 |
| y4 | 1.985 | 0.201 | -0.008 |
| y5 | 1.988 | 0.208 | -0.006 |
| y6 | 1.987 | 0.202 | -0.006 |
| y7 | 1.989 | 0.209 | -0.005 |
| y8 | 1.985 | 0.203 | -0.008 |
| y9 | 1.985 | 0.205 | -0.007 |
| y10 | 1.984 | 0.198 | -0.008 |
표 2.
생성된 변수들의 첨도의 평균, 표준편차, 상대적 편향(RB) 결과
| Indicator | mean | sd | RB |
|---|---|---|---|
| y1 | 6.868 | 2.495 | -0.019 |
| y2 | 6.887 | 2.458 | -0.016 |
| y3 | 6.859 | 2.511 | -0.020 |
| y4 | 6.828 | 2.391 | -0.025 |
| y5 | 6.871 | 2.585 | -0.018 |
| y6 | 6.859 | 2.409 | -0.020 |
| y7 | 6.889 | 2.624 | -0.016 |
| y8 | 6.832 | 2.529 | -0.024 |
| y9 | 6.836 | 2.519 | -0.023 |
| y10 | 6.813 | 2.303 | -0.027 |
다음으로, 자료의 적절성을 평가하고자 생성된 자료를 이용한 이요인 모형 추정의 결과는 표 3에 제공된다. 모형 추정치들의 상대적 편향은 –0.4%에서 0%까지 매우 작은 값을 보였고, RMSE 또한 0.022부터 0.030까지로 상당히 작은 값을 보였으며, 95% 커버리지도 0.935에서 0.947까지로 나타나 Muthén과 Muthén(2002)이 제안한 기준을 만족하였다. 즉, 본 연구에서 제공하고 있는 방식으로 lavaan 패키지를 이용하여 생성된 비정규 자료는 설정한 모형 모수를 만족하는 자료를 정확하고 안정적으로 생성하였다. 이와 같은 두 가지 평가 결과에 따라 lavaan 패키지를 통해 생성된 비정규 자료는 이요인 모형 기반의 비정규성 관련 시뮬레이션 연구를 진행하기에 적절하다고 할 수 있다.
표 3.
이요인 모형 모수 추정치의 상대적 편향(RB), root mean square error(RMSE)와 95% 커버리지(.95 CR)
| Population Parameters | Average Estimates | RB | RMSE | .95 CR | |
|---|---|---|---|---|---|
| Factor loadings | |||||
| λ1 | 0.700 | 0.700 | 0.000 | 0.026 | 0.944 |
| λ2 | 0.700 | 0.700 | 0.000 | 0.026 | 0.946 |
| λ3 | 0.750 | 0.750 | 0.000 | 0.028 | 0.943 |
| λ4 | 0.800 | 0.800 | 0.000 | 0.028 | 0.943 |
| λ5 | 0.800 | 0.800 | 0.000 | 0.028 | 0.942 |
| Factor loadings | |||||
| λ6 | 0.700 | 0.700 | 0.000 | 0.026 | 0.947 |
| λ7 | 0.700 | 0.700 | 0.000 | 0.026 | 0.945 |
| λ8 | 0.750 | 0.750 | 0.000 | 0.028 | 0.941 |
| λ9 | 0.800 | 0.800 | -0.001 | 0.028 | 0.945 |
| λ10 | 0.800 | 0.800 | -0.001 | 0.028 | 0.943 |
| Factor variance and covariance | |||||
| ϕ1 | 1.000 | - | - | - | - |
| ϕ2 | 1.000 | - | - | - | - |
| ϕ12 | 0.300 | 0.300 | 0.000 | 0.022 | 0.947 |
| Error variances | |||||
| ψ1 | 0.510 | 0.510 | 0.000 | 0.030 | 0.939 |
| ψ2 | 0.510 | 0.510 | -0.001 | 0.030 | 0.940 |
| ψ3 | 0.438 | 0.436 | -0.004 | 0.026 | 0.940 |
| ψ4 | 0.360 | 0.360 | -0.001 | 0.022 | 0.940 |
| ψ5 | 0.360 | 0.359 | -0.002 | 0.022 | 0.938 |
| ψ6 | 0.510 | 0.509 | -0.001 | 0.030 | 0.939 |
| ψ7 | 0.510 | 0.509 | -0.002 | 0.030 | 0.935 |
| ψ8 | 0.438 | 0.437 | -0.003 | 0.026 | 0.942 |
| ψ9 | 0.360 | 0.359 | -0.003 | 0.022 | 0.938 |
| ψ10 | 0.360 | 0.359 | -0.003 | 0.022 | 0.940 |
결론 및 논의
본 연구의 주요한 목적은 비정규 자료 생성 절차를 power method에 기반하여 구체적으로 제공하고, 실제 비정규 자료를 생성하는 예시를 보임으로써 비정규 자료를 이용하고자 하는 방법론 연구자들에게 유용한 정보를 제공하는 것이었다. 정규성 가정이 위배된 상황을 가정하는 시뮬레이션 연구의 경우 연구 목적에 맞는 비정규 자료를 생성하는 것이 연구 결과에 큰 영향을 미침에도 불구하고 비정규성과 관련된 선행연구들의 경우 어떤 종류의 비정규 생성 방법을 사용하였는지에 대한 언급만 존재할 뿐, 비정규 자료 생성 원리 및 절차를 상세히 설명한 경우는 찾을 수 없다. 이는 연구자가 실제로 연구 목적에 맞는 비정규 자료를 생성하고 이를 시뮬레이션 연구에 활용하는 데 있어 어려움이 존재할 수 있음을 의미한다. 이에 본 연구는 현재 가장 많이 사용되는 비정규 자료 생성 방법인 power method를 바탕으로 해당 방법의 기본 원리와 비정규 자료를 생성하는 절차를 단계별로 자세히 밝힘으로써 비정규 자료 생성에 대한 연구자들의 이해를 높이고자 하였다. 뿐만 아니라 이요인 확인적 요인분석 모형을 이용한 실제 비정규 자료 생성 예시를 제공함으로써 방법론 연구자들이 참고할 수 있는 가이드라인을 제시하였다. 또한, 이 과정에서 연구자가 활용할 수 있는 도구로서 R 코드와 Mplus 신택스를 함께 제공함으로써 비정규 자료 생성, 특히 power method의 활용성과 접근성을 높이고자 하였다.
본 연구에서 중점적으로 다룬 비정규 자료 생성 절차는 자료가 반영하고자 하는 연구 모형 및 비정규성의 기준을 설정하고, 해당 내용을 바탕으로 비정규 자료를 생성한 후, 자료가 잘 생성되었는지 평가하는 세 단계로 구성되어 있다. 본 연구는 가장 대중적으로 사용되는 비정규 자료 생성 방법인 power method를 바탕으로 전반적인 절차를 설명하였으며, 특히 자료의 생성 및 평가 단계에서 power method를 지원하는 lavaan 패키지의 사용법에 대해 심도 있게 논의하였다. lavaan 패키지를 이용한 비정규 자료 생성의 핵심은 반복문을 이용하여 비정규 자료뿐만 아니라 평가 단계에 필요한 관련 자료들을 동시에 생성하는 것이다. 다시 말해, 반복문을 통해 조건에 맞는 여러 개의 비정규 자료 세트와 모든 자료 세트의 이름이 정리된 추가 자료를 생성해야 한다. 이를 통해 연구자는 자료의 평가 단계에서 Mplus를 이용하여 자료가 연구 모형 모수를 포함하는지 확인하고, R 혹은 SPSS와 같은 다른 프로그램을 통해 비정규성 기준을 만족하는지 확인할 수 있다. 이처럼 본 연구는 power method를 바탕으로 비정규 자료 생성 절차를 설명하고, Mplus와 연동할 수 있는 lavaan 패키지를 자료 생성에 이용함으로써 실제 활용 가능성이 높은 정보를 제공했다는 장점을 갖는다. 특히 자료 생성 절차를 상세히 설명함으로써 추후 연구자가 다른 비정규 자료 생성 방법을 선택하더라도 참고할 수 있는 기본 틀을 제공했다는 강력한 이점 또한 존재한다.
본 연구는 자료 생성 절차의 단계를 구체적으로 설명함으로써 비정규 자료 생성에 대한 이해를 높인다는 목적을 달성하였으나 몇 가지 측면에서 여전히 제한점을 가지고 있다. 첫째로, 본 연구는 실제 자료 생성 예시에서 이요인 확인적 요인분석 모형을 연구모형으로 설정한 다음 절차를 설명하였기 때문에 만약 연구자가 다른 모형(예, 구조방정식 모형, 잠재성장모형 등)을 이용하고자 할 경우 모형 설정 부분의 코드를 새로 작성할 필요가 있다. 다만 확인적 요인분석은 다른 모형들로 충분히 확장될 수 있을 뿐만 아니라 lavaan 패키지의 모형 문법 또한 이해하기 어렵지 않으므로 연구자들의 응용이 필요한 부분이다. 둘째로, 본 연구는 실제 비정규 자료 생성 예시를 보이는 과정에서 단 하나의 비정규성 기준만을 설정하였다. 이는 명확한 기준을 바탕으로 전반적인 생성 절차를 선명하게 설명하기 위함이었다. 비록 power method를 이용한 실제 자료 생성 예시에서 선행연구와 비슷하게 왜도 및 첨도에서 하향 편향(downward bias)이 나타났으나, 평가 기준을 벗어날 만큼의 문제는 발생하지 않았다. 이는 자료 생성 과정에서 선택된 lavaan 패키지가 충분히 연구 목적에 맞는 비정규 자료를 생성할 수 있음을 시사한다. 따라서 후속 연구에서는 다른 통계 모형들을 이용하면서 동시에 다양한 비정규성 기준을 설정하였을 때 lavaan 패키지가 여전히 평가 기준에 적합한 비정규 자료를 생성하는지 확인하는 과정이 필요할 수 있다.
이러한 제한점에도 불구하고 본 연구는 비정규 자료 생성 절차를 구조화하고 단계별 설명을 제공함으로써 방법론 연구자들이 시뮬레이션 연구에 참고할 수 있는 내용을 제공했다는 점에 의의가 있다. 뿐만 아니라 lavaan 패키지의 자료 생성 코드와 Mplus에서 시뮬레이션을 실시하는 코드를 제공함으로써 power method를 이용한 비정규 자료 생성에 있어서 활용할 수 있는 도구 또한 제공하였다. 이를 통해 본 연구가 비정규 자료 생성, 특히 power method를 이용하여 시뮬레이션 연구를 진행하고자 하는 많은 연구자들에게 실질적인 도움을 제공할 수 있을 것으로 기대한다.
1) 본 연구는 방법론 연구자들을 대상으로 하는 만큼, R과 Mplus에 대한 배경지식을 갖고 있음을 가정하였다. 만약 R의 설치부터 실행과 같은 R 프로그램에 대한 기본적인 이해가 필요한 경우 김수영(2019)을 참고할 수 있으며, Mplus의 input 파일을 작성하는 방법에 대한 정보가 필요한 경우에는 김수영(2016)을 참고할 수 있다.
2) R에서 사용되는 반복문에는 크게 ‘for’문, ‘while’문, ‘repeat’문이 있다. 연구자는 사용 목적에 맞는 반복문을 선택해야 하며, 각 반복문은 다음과 같은 특징을 갖는다. ‘for’문은 반복 횟수를 지정함으로써 해당 횟수만큼 함수를 반복 수행하며, ‘while’문은 연구자가 설정한 조건을 만족하는 동안 함수를 반복 수행한다. ‘repeat’문은 ‘if’나 ‘break’를 이용하여 특정 조건을 만족할 때까지 함수를 반복 수행한다. 본 연구에서는 연구자가 필요한 자료 세트의 개수만큼 함수를 반복하는 것이 필요하므로 ‘for’문을 이용하였다.
참고문헌
Demirtas, H., Shi, Y., Allozi, R., & Gao, R. (2021). PoisNonNor: Simultaneous generation of count and continuous data. Retrieved from https://CRAN.R-project.org/package=PoisNonNor
Fialkowski, A. C. (2018). SimMultiCorrData: Simulation of correlated data with multiple variable types. Retrieved from https://CRAN.R-project.org/package=SimMultiCorrData
R Core Team (2024). R: A language and environment for statistical computing. Vienna, Austria. Retrieved from https://www.R-project.org/
Revelle, W. (2024). psych: Procedures for psychological, psychometric, and personality research. Retrieved from https://CRAN.R-project.org/package=psych
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1-36. http://www.jstatsoft.org/v48/i02/
부 록
비정규 자료 생성 절차에서 사용된 모든 R 프로그램 함수들
| 구분 | 함수명 | 사용 목적 |
|---|---|---|
| 자료 생성 | paste0() | 설정한 아규먼트들을 띄어쓰기 없이 하나로 통합하는 함수로, 파일명을 생성할 때 사용 |
| rbind() | 기존 객체에 행을 추가하고자 할 때 사용되는 함수 | |
| simulateData() | power method를 통한 비정규 자료를 생성할 때 사용되는 함수 | |
| write.table() | R 환경에서 생성된 자료를 연구자가 설정한 확장자명의 파일로 저장할 때 사용되는 함수 | |
| 자료 평가 | c() | 특정 아규먼트를 이용하여 벡터를 생성할 때 사용되는 함수 |
| desccribe() | 왜도, 첨도를 포함한 변수의 기술통계치를 확인할 때 사용되는 함수 | |
| do.call() | 특정 함수를 반복해서 적용하고자 할 때 사용되는 함수 | |
| list() | 자료의 구조를 리스트로 변경하는 함수 | |
| names() | 자료의 변수명을 확인할 때 사용되는 함수 | |
| read.table() | R 환경이 아닌 외부에 저장되어 있는 파일을 R 환경으로 불러오고자 할 때 사용되는 함수 | |
| write.csv() | R 환경에서 생성된 자료를 csv 확장자명의 파일로 저장할 때 사용되는 함수 |