잠재계층분석(latent class analysis; LCA)은 관찰변수에 대한 개인의 응답 패턴을 기반으로 잠재계층을 추출함으로써 이질적 특성을 가지는 잠재적 집단을 구분하는 데 이용되는 피험자 중심의 분석 방법이다(Goodman, 1974; Lazarsfeld, 1950; Lazarsfeld & Henry, 1968). Lazarsfeld(1950)에 의해 처음 소개된 LCA는 이분형 관찰변수를 이용하는 분류 기법으로1), 이후 Gibson(1959)이 이를 연속형 관찰변수에 적용하기 위해 제안한 동일한 분류 기법을 잠재프로파일분석(latent profile analysis; LPA)이라고 한다. 두 분석 방법은 잠재계층의 수를 통계적으로 결정하고 추출할 수 있다는 장점이 있어 개인의 응답 특성에 관심이 있는 연구자들에게 활발하게 이용되고 있다. 실제로 국내 온라인 데이터 베이스 DBpia를 이용하여 2018년부터 2023년까지 ‘잠재계층분석’, ‘잠재프로파일분석’, ‘LCA’, ‘LPA’ 등의 키워드로 검색하여 나오는 논문은 사회과학 분야에서만 809편에 이른다. 이처럼 널리 사용되고 있는 LCA와 LPA는 지역독립성 가정(local independence assumption 또는 conditional independence assumption)을 전제 조건으로 설정한다. 두 분석 방법에서 지역독립성 가정은 추정 모수의 수를 줄임으로써 통계적 효율성과 해석의 명료성을 높이기 위한 일반적인 분석 조건으로 간주되고 있다(Masyn, 2013; Tein et al., 2013; Vermunt & Magidson, 2004). 지역독립성 가정은 특정 잠재계층에 속하는 개인의 관찰변수에 대한 응답들이 서로 독립임을 뜻한다(Magidson & Vermunt, 2004). 지역독립성 가정은 모형 내에 잠재계층 변수 외에 관찰변수를 설명하는 다른 요인이 존재하지 않음을 가정하는 것으로, 해당 가정의 만족은 오직 잠재계층 변수만으로 관찰변수들을 충분히 설명할 수 있음을 의미한다(Nylund & Choi, 2018). 따라서 유의미한 설명력을 가진 잠재계층 추출을 목적으로 하는 LCA와 LPA에서 지역독립성 가정이 만족되었는지 확인하는 과정은 필수적이다. 그럼에도 불구하고, 여전히 많은 연구들 가운데 지역독립성 가정의 의미와 중요성을 정확히 이해하고 두 분석 방법을 활용한 경우는 드물다. 특히 현재까지 대부분의 지역독립성 가정에 대한 논의는 LCA 위주로만 진행되어 왔기 때문에, 연속형 변수를 이용하는 LPA의 맥락에서 가정의 위배를 탐지하고 이를 해결하는 방법에 대한 논의는 더욱더 충분히 진행되지 않았다. 이에 본 연구는 LCA와 LPA를 이용한 국내 연구에서 간과되고 있는 지역독립성 가정의 역할과 가정의 위배 여부를 확인하는 절차의 중요성에 대해 논의한다. 이를 위해 지역독립성 가정의 위배가 모형의 간명성과 계산의 효율성 및 정확성에 미치는 영향에 대해 설명하고, 가정이 위배된 상황을 탐지하고 이를 반영하는 모형화 방법들도 함께 제시한다.
LCA와 LPA는 유사한 특성을 보이는 개인들을 동질적인 집단으로 분류하기 위한 분석 방법으로, AIC(Akaike Information Criteria), BIC (Bayesian Information Criteria), Entropy 지수와 같은 다양한 적합도 지수를 통해 보다 객관적으로 잠재계층을 추출할 수 있다는 장점이 있다. 또한, 두 분석 방법은 군집분석과 같은 전통적인 분류 방법들에서 전제되는 것보다 더 적은 수의 가정을 만족하는 것만으로도 분석이 가능하다는 점에서 자료의 활용도가 높다(Magidson & Vermunt, 2004; Muthén & Shedden, 1999). 이처럼 유연성이 높은 분석 방법인 LCA와 LPA에도 만족시켜야하는 기본 가정이 존재하는데, 이는 바로 지역독립성이다. LCA 및 LPA에서 지역독립성은 정확한 잠재계층의 추출 및 해석에 직접적인 영향을 미친다. 지역독립성 가정이 위배되면, 상관이 있는 변수들이 결과에 왜곡된 영향을 미쳐서 허위(spurious) 잠재계층을 만들어 낼 뿐 아니라(Uebersax, 1999), 잠재계층의 수를 결정할 때 왜곡된 적합도 지수를 참고하게 됨으로써 잘못된 분석 결과를 야기할 수 있는(Asparouhov & Muthén, 2011) 것으로 알려져 있다.
구체적으로 살펴보면, 지역독립성 가정이 위배된 상황은 모형의 설정, 추정, 평가 등 일련의 모든 분석 과정에 영향을 미친다. 먼저 모형 설정의 관점에서 지역독립성 가정의 위배는 연구자가 모형을 잘못 설정하는 오류를 범했을 가능성을 나타낼 수 있다(Vermunt, 2010). 다음으로, 추정의 관점에서 지역독립성 가정의 위배는 모수 추정에 편향을 일으키는 것으로 알려져 있다(Albert & Dodd, 2004; Biemer, 2011; Pepe & Janes, 2007; Sepúlveda et al., 2008; Torrance-Rynard & Walter, 1997; Vacek, 1985). 본론에서 더 자세히 다루겠지만, 지역독립성을 가정함에 따라 LCA와 LPA는 개별 조건부확률의 단순 곱을 통해 전체 조건부확률에 대한 정보를 계산한다. 그러나 가정이 위배될 경우 이 계산 방식은 적절하지 않으며, 그에 따라 편향된 추정치를 산출하게 된다. 마지막으로, 이와 같이 추정된 모수들은 적절한 수의 잠재계층을 추출하고 해석하는 데 중요한 역할을 하기 때문에 모형의 평가에도 영향을 미친다(Asparouhov & Muthén, 2011).
위와 같은 지역 독립성 가정의 위배에 따른 부정적 영향은 올바른 방식으로 모형을 수정함으로써 완화될 수 있다. 사실, 지역 독립성 가정의 위배 상황이 그 자체로 모든 LCA 및 LPA의 분석에 부정적 영향을 미치는 것은 아니다. 그보다는, 해당 가정이 위배되었음에도 불구하고 디폴트 가정을 유지한 채로 분석을 진행하는 것이 잘못된 결과를 초래하는 것이다. 따라서 LCA와 LPA를 이용하는 연구자들은 분석을 진행하기에 앞서 지역독립성 가정의 만족 여부를 탐지하고, 만약 가정이 위배되었다면 적절한 모형화 방법을 이용하여 이 문제를 해결해야 한다. 이에 많은 연구자들이 다양한 통계적 기법을 이용한 지역독립성 가정의 위배 탐지 기법과 모형화 방법을 제안했다(Asparouhov & Muthén, 2011; Espeland & Handelman, 1989; Garrett & Zeger, 2000; Magidson & Vermunt, 2004; Qu et al., 1996). 다만, 이러한 탐지 및 모형화 방법들에 대한 체계적인 정리와 종합적인 논의는 아직 충분히 이뤄지지 않았다. 비록 몇몇 연구들에서 지역독립성 위배 시 이용 가능한 대표적인 방법들에 대한 연구를 진행했지만(Oberski et al., 2013; Visser & Depaoli, 2022), 한정적인 몇몇 방법들에 대한 비교에 그쳤다는 아쉬움이 있다. 더욱이, 현재까지 제안된 방법들은 대부분 LCA에만 적용할 수 있으며, LPA에 적용할 수 있는 탐지 및 모형화 방법에 대해서는 따로 논의되지 않는 경우가 많았다. 그에 따라 현재까지도 LPA의 맥락에서는 가정 위배 시 적용될 수 있는 탐지 및 모형화 방법에 대한 충분한 탐색이 진행되지 못했다. 연속형 관찰변수를 이용하는 LPA에서 지역독립성 가정의 원리는 이분형 관찰변수를 이용하는 LCA에서와 다른 방식으로 설명되어야 하며, 가정의 위배에 대한 탐지 및 모형화 기법 또한 기존에 소개된 방법들을 그대로 적용할 수 없다. 즉, 경험적 연구자들이 분석 기법을 올바르게 활용하기 위해서, LCA 뿐만 아니라 LPA에 적용 가능한 지역독립성 위배의 탐지와 모형화를 위한 방법들 또한 종합적으로 논의될 필요가 있다.
실제로 LCA와 LPA를 이용한 다수의 국내 연구들은 지역독립성 가정의 중요성을 간과하고 충족 여부를 확인하는 과정을 생략하는 경향을 보였다. 최근 5년 이내의 LPA 또는 LCA를 활용한 국내 심리학 연구 80편 중 77편은 지역독립성 가정에 대한 언급조차 없었으며(김예진 등, 2022; 신재은, 현명호, 2019; 신희영 등, 2021; 이재호, 2018; 안찬영 등, 2022; 조준희, 주은선, 2022 등), 나머지 이론적으로 지역독립성의 중요성에 대해서 밝힌 3편의 연구(오영교, 차성현, 2018; 정진주, 장혜인, 2022; 최상민 등, 2022)도 구체적으로 어떤 방법으로 가정의 만족 여부를 탐지했는지 기술하지 않았다. 이러한 경향성은 많은 연구자들이 아직까지도 LCA 및 LPA에서 지역독립성 가정이 갖는 의미와 중요성, 그리고 가정이 위배되었을 때 발생할 수 있는 다양한 문제점들에 대해 충분히 인지하지 못하고 있음을 시사한다.
본 연구의 가장 중요한 목적은 연구자가 LCA와 LPA에서 지역독립성 가정의 의미와 역할에 대해 충분히 이해할 수 있도록 설명함으로써 향후 연구에서 해당 분석 방법을 정확하고 효율적으로 사용하는 데 기여하는 것이다. 이에 본 연구는 지역독립성 가정의 수리적 의미와 추정에 미치는 영향과 같은 개념적인 내용을 다루면서 가정의 중요성에 대한 이해를 높이고, 지역독립성 가정의 위배 여부를 판단하고 모형화할 수 있는 다양한 실용적인 방법들을 추정 방법에 따라 나누어 논의한다. 즉, 본 연구는 정확하고 안정적인 LCA 및 LPA의 추정과 해석을 위해 연구자들이 지역독립성 가정의 만족 여부를 확인하는 과정이 포함된 적절한 분석 절차를 필수적으로 따르도록 하는 데 목적이 있다.
이와 같은 목적을 달성하기 위해 본 연구에서는 지역독립성 가정을 전제로 성립되는 LCA 및 LPA의 기본적인 수식을 간략히 소개하고, 해당 수식을 통해 추정되는 모수들의 종류와 의미에 대해 다루며, 지역독립성 가정의 위배가 이러한 모수들의 추정에 영향을 미치는 원리를 확인한다. 또한, 연구자들이 적절한 분석 절차를 따르는데 참고할 수 있도록 지역독립성 가정 위배 탐지 및 모형화 방법들을 추정 방법에 따라 나누어 설명한다. 이를 위해 지난 수십 년간 발전해온 LCA 연구들에서 주로 사용된 방법들을 정리하고, 해당 방법들에서 사용된 개념을 LPA로 확장하여 적용할 수 있는 방법들에 대해 논의한다.
LCA 및 LPA에서의 지역독립성 가정
LCA와 LPA는 관찰변수에 대한 개인의 응답 패턴을 기반으로 잠재계층을 추출할 때 사용되는 분석 방법이다. 두 분석 방법에서 모든 관찰변수에 대한 응답은 모집단 내에 잠재적으로 존재하는 하위집단(즉, 잠재계층)에 따라 달라지는 것으로 여겨진다. 이는 자료에서 관찰된 특정한 응답 패턴이 잠재계층에 대한 정보를 통해 설명됨을 의미한다. 이러한 논리에 따라, 이분형 변수를 이용하는 LCA에서 피험자가 M개의 관찰변수에 대해 특정 응답 패턴 y=[y1, y2, ... ym]을 보일 결합확률 P(y)는 다음의 식과 같이 정의될 수 있다.
위 식에서 πk는 각 잠재계층의 비율, P(y | c = k) 는 잠재계층변수 c가 k일 때 모든 관찰변수에 대해 응답 패턴 y를 가질 조건부확률을 가리킨다. 식 1에 따르면, 피험자가 특정한 응답 패턴을 보일 확률 P(y)는 잠재계층비율 πk와 조건부확률 P(y | c = k) 의 곱을 통해 계산된다. 한편, LPA는 관찰변수에 대한 응답을 정규분포를 따르는 연속형 변수라고 가정함에 따라 특정 응답 패턴을 가질 결합확률을 결합확률밀도에 대한 정보로 표현하게 된다. LPA에서 응답 패턴 y를 보일 결합확률밀도에 대한 함수 f(y)는 다음과 같이 정의된다.
위 식에서 f(y | θk)는 각 잠재계층 k에서의 확률분포 모수 θk가 주어졌을 때의 조건부 결합확률밀도함수를 가리킨다. 식 2에 따르면, 피험자가 모든 연속형 관찰변수에 대하여 특정 응답 패턴 y를 보일 결합확률밀도는 잠재계층비율과 각 잠재계층의 다변량 확률분포의 모수(즉, 개별 분포들에 대한 주변 평균 및 분산, 변수들 간 공분산)가 주어졌을 때 해당 응답 패턴을 가질 조건부확률밀도의 곱으로 정의된다.
이처럼 LCA와 LPA를 이용할 때 정확한 모수 추정 결과를 얻기 위해서는 분석 과정에 포함되는 한 가지 가정에 대해 반드시 고려해야 한다. 이는 모든 관찰변수에 대한 지역독립성 가정이다. 지역독립성 가정이란 어떤 잠재적인 특성을 가진 피험자가 서로 다른 두 변수에 대해 응답할 확률이 독립적임을 가정하는 것으로, LCA와 LPA의 맥락에서는 특정 잠재계층 내에서 각 관찰변수의 응답이 다른 관찰변수에 의해 영향받지 않는 것으로 정의된다. 지역독립성 가정은 잠재계층변수 c가 4개의 관찰변수 y1, y2, y3, y4를 설명하는 모형의 경로도인 그림 1을 통해 시각적으로 이해할 수 있다. 그림 1(a)는 LCA 및 LPA에서 지역독립성 가정이 만족된 상황을 나타낸다. 해당 그림에서 관찰변수들은 잠재계층변수 c에 의해서만 설명되며, 각 관찰변수들의 오차 간 상관이 존재하지 않는 것을 확인할 수 있다. 반면, 그림 1(b)는 지역독립성 가정이 위배된 상황으로, 오차 e1과 e2 간에 상관이 있고, 오차 e3와 e4 간에 상관이 있음을 보인다. 즉, 잠재계층변수 c가 각 관찰변수들을 충분히 설명하지 못하는 상황을 나타낸다.
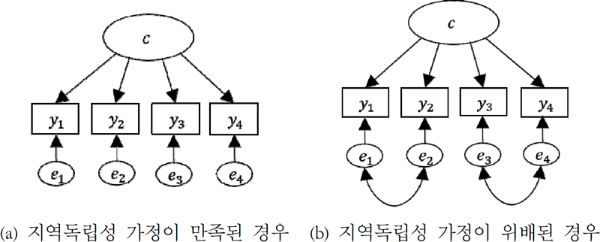
일반적으로 LCA와 LPA에서는 지역독립성 가정을 기본적으로 전제하는데, 이는 해당 가정이 분석 과정에 몇 가지 강력한 이점을 제공하기 때문이다. 우선, 지역독립성 가정은 앞서 언급된 조건부확률에 대한 계산을 단순화함으로써 분석 과정에서 필요한 수리적 절차를 효율적으로 만들 수 있다(Magidson & Vermunt, 2004). LCA에서 지역독립성 가정이 만족되면, 각 잠재계층 내에서 피험자의 응답 패턴에 대한 조건부확률은 각 문항에 응답할 확률의 단순 곱으로 계산된다. 피험자가 잠재계층 k에 속할 때 특정 응답 패턴을 보일 조건부확률 P(y | c = k) 는 지역독립성 가정이 만족될 때 다음의 식과 같이 표현될 수 있다(Goodman, 1974).
위 식에서 P(ym | c = k) 는 잠재계층변수 c가 k일 때 m번째 이분형 관찰변수 ym의 응답에 대한 조건부확률을 가리킨다. 식 3은 지역독립성 가정이 만족됨에 따라 P(y | c = k)가 M개 조건부확률들의 단순 곱 로 계산될 수 있음을 보인다. 이와 같은 지역독립성 가정에 따른 계산 과정의 효율성은 연속형 변수를 이용하는 LPA에서도 확보될 수 있다. 이는 모든 변수가 독립적일 때 결합확률밀도함수는 주변확률밀도함수들의 단순 곱으로 표현된다는 확률분포의 기본 원리에 의해 성립한다. 즉, LPA에서의 조건부 결합확률밀도함수 f(y | θk) 또한 지역독립성 가정이 만족됨에 따라 M개 조건부 주변확률밀도함수들의 단순 곱 로 계산될 수 있다.
다음으로, 지역독립성 가정은 추출된 잠재계층 k 내 관찰변수들 간 상관행렬 Rk의 제약을 통해 모형의 간명성을 증가시킬 수 있다. LCA와 LPA에서 지역독립성을 가정하는 것은 Rk를 항등행렬 Ik로 제약하는 것과 같은데, 이는 주어진 잠재계층에서 관찰변수 간 상관계수를 모두 0으로 제약함을 의미한다(Asparouhov & Muthén, 2011). 다시 말해, 지역독립성을 가정하면 Rk는 다음의 식과 같이 설정된다.
위 식에서 Rk는 k번째 잠재계층에서 M개의 관찰변수들 간 상관행렬, Ik는 항등행렬, 비대각 요소 0은 잠재계층 내 각 관찰변수들의 상관계수를 나타낸다. 식 4에 따르면, 지역독립성 가정은 Rk의 비대각 요소를 0으로 고정함으로써 추정해야 할 모수의 수를 줄여 모형을 간명하게 만든다(Vermunt & Magidson, 2005).
지역독립성 가정은 계산과정에서의 효율성과 간명성을 높인다는 명확한 이점을 제공하므로 분석에 앞서 필수적으로 만족되어야 하는 가정으로 고려된다(Oberski et al., 2013). 실제로 해당 분석에 가장 많이 사용되는 Mplus, Latent GOLD, R 패키지 poLCA, tidyLPA 등의 통계 프로그램에서도 해당 가정이 디폴트로 이용되고 있다. 이처럼 대부분의 LCA 및 LPA를 이용하는 연구에서 지역독립성 가정을 기본으로 채택하고 있기 때문에, 실제 자료의 특성이 해당 가정을 만족하지 못하는 경우에는 잘못된 분석 결과를 얻을 수 있다. 즉, 잠재계층 내 관찰변수 간 상관이 높을 경우, 지역독립성 가정이 위배됨에 따라 추정 결과에는 다양한 문제가 발생하게 된다.
지역독립성 가정의 위배가 LCA 및 LPA의 분석 결과에 미치는 영향
LCA와 LPA에서 지역독립성 가정이 위배되었을 때 발생하는 대표적인 문제는 잠재계층비율 πk와 조건부확률 P(ym | c = k) 또는 f(ym | c = k)가 편향된다는 것이다. 이는 결합확률을 산출하는 과정 중에 사용되는 단순 곱 계산 방식(식 3 참고)이 더 이상 수리적으로 타당하지 않게 되기 때문이다(Vermunt, 2010). 이와 같이 지역독립성 가정의 위배에 영향을 받는 두 종류의 정보(즉, 비율과 조건부확률)는 모두 잠재계층과 피험자, 관찰변수 간 관계성을 정의하는 데 중요한 역할을 하는데, 그중 조건부확률은 각 잠재계층에서의 분포 모수 추정에 직접적인 영향을 미치기 때문에 더 주목할 필요가 있다.
분포 모수는 추출된 잠재계층의 의미를 해석하고 그 적절성을 평가하기 위해 주요하게 이용되는 정보이다. 분포 모수 추정치가 편향될 경우, 연구자는 모형의 분석 결과 전반을 오해석하거나, 잘못된 결론을 내릴 수 있다. 그런데 여기에서 한 가지 주목할 점은, LCA와 LPA에서 이용되는 분포 모수의 종류가 두 모형에서 서로 다르다는 것이다. 이는 두 모형에서 이용되는 변수의 유형에 따라 잠재계층별 응답 경향성에 대한 정보를 갖는 모수의 종류가 다르기 때문이다. 본 섹션에서는 LCA 및 LPA에서 분포 모수가 잠재계층의 의미를 결정하는 기본 원리를 소개하고, 지역독립성 가정의 위배에 따른 조건부확률의 편향이 해당 모수들에 어떻게 영향을 미치는지를 각각의 모형에 따라 구분하여 살펴본다.
LCA에서의 경계 모수
LCA에서 잠재계층의 의미는 이분형 변수들을 그대로 이용하기보다는 그 기저에 정규분포를 따르는 연속적인 잠재반응변수(latent response variable)가 있음을 가정하고 해당 잠재반응변수를 이용하여 설명하는 것이 일반적이다(McCutcheon, 2002; Uebersax, 1999). 이에 따라, LCA는 각 잠재반응변수들에 대한 분포 모수로서 경계(threshold) 정보를 이용하게 된다. 경계란 이분형 변수들에 대한 응답 범주를 나누는 잠재반응변수 상에서의 구분점(cut off)으로 정의되는데, 관찰변수가 가지는 응답 확률에 대한 정보를 잠재반응변수에 반영하여 두 변수를 연결하는 역할을 한다. 이때 관찰된 이분형 반응변수 ym과 잠재반응변수 는 경계를 통해 다음과 같은 관련성을 갖는다.
위 식에서 τmk는 경계로서 k번째 잠재계층에서 m번째 관찰변수에 대한 응답 범주(0 또는 1)를 구분하는 지점을 가리킨다. 식 5에 따르면, ym은 가 τmk보다 작을 때 0, 클 때 1의 값으로 관찰된다(Muthén, 1984). 이때 관찰된 ym에서 각 범주에 대한 응답 확률은 잠재적인 에서 τmk를 기준으로 구분된 표준정규분포의 면적에 상응하는 것으로 가정된다. 이와 같은 잠재반응변수에서의 경계 모수 위치와 관찰변수의 응답 확률 간 관계는 그림 2를 통해서도 쉽게 이해할 수 있다.
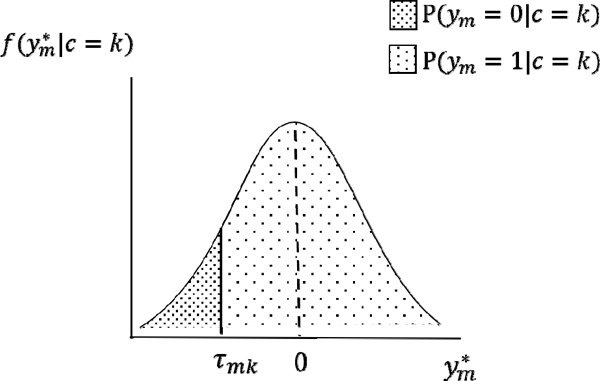
그림에서 τmk의 부호는 특정 잠재계층의 다수가 응답한 범주가 무엇인지를 나타내며, τmk의 절대값은 특정 잠재계층에서 각 응답 범주에 대한 P(ym | c = k)의 상대적 크기를 나타낸다. 즉, 경계 모수는 잠재계층의 해석에 핵심적인 정보가 된다. 예를 들어, τmk가 부적으로 큰 값이라면, 해당 잠재계층에 속한 피험자들은 관찰변수 ym에 대해 0보다는 1로 응답할 경향성이 명백히 높다고 해석할 수 있다.
이처럼 τmk는 P(ym | c = k) 의 크기에 대한 정보를 담고 있는 모수이기 때문에, 지역독립성 가정의 위배에 의해 조건부확률이 편향될 경우 τmk의 위치는 반드시 변화하게 된다(Muthén & Asparouhov, 2006). 이러한 경향성은 다음의 경계와 조건부확률 간 관련성을 통해서도 확인할 수 있다.
위 식을 보면, 경계 τmk는 P(ym = 1 | c = k)에 의해 결정됨을 알 수 있다. 이때 τmk와 P(ym = 1 | c = k) 는 반비례 관계이므로 P(ym = 1 | c = k) 가 큰 값을 가질수록 τmk는 작은 값을 가지게 된다. 예를 들어, 만약 지역독립성 가정의 위배에 의해 P(ym = 1 | c = k) 가 과대추정된다면, 해당 변수에 대한 τmk 값은 실제 모수보다 더 작은 값으로 편향될 것이다. 이처럼 지역독립성 가정이 위배되는 경우 LCA의 분포 모수인 경계는 잘못 추정된 조건부확률 때문에 실제와 다른 값을 가질 수 있으며, 그에 따라 잠재계층에 대한 잘못된 정보를 제공하게 된다.
LPA에서의 평균과 분산 모수
LPA에서는 LCA에서와 달리 잠재계층의 의미를 각 잠재계층별로 ym의 응답 분포를 직접 이용하여 정의할 수 있다. 이는 LPA가 LCA와 달리 연속형 관찰변수를 이용하는 분석 방법이며, 따라서 연속형 잠재반응변수와 그에 대한 기저분포를 가정할 필요가 없기 때문이다. 일반적으로 LPA에서는 각 관찰변수의 분포를 정규분포라고 가정하기 때문에(Sterba, 2013), 잠재계층의 의미에 대한 정보를 반영하는 모수로는 정규분포의 모수인 평균과 분산이 이용될 수 있다. 평균과 분산은 각각 잠재계층 내 피험자들의 해당 변수에 대한 대표적인 특성과 응답의 변산성을 반영하는 정보에 해당한다. 예를 들어, 그림 3과 같은 특정 잠재계층 k에서의 관찰변수 ym에 대한 응답 분포는 평균 μmk와 분산 에 대한 정보를 갖는다. 만약 μmk와 이 다른 잠재계층에 비해 작은 값이라면 해당 잠재계층에 속한 피험자들은 ym에 대해 비교적 낮은 경향성을 가지며, 더 동질적이고 일관된 응답 경향성을 보인다고 해석할 수 있다. 이처럼 LPA에서 특정 잠재계층이 가지는 의미는 모든 관찰변수들의 평균과 분산에 기반하여 해석하는 것이 가능하다.
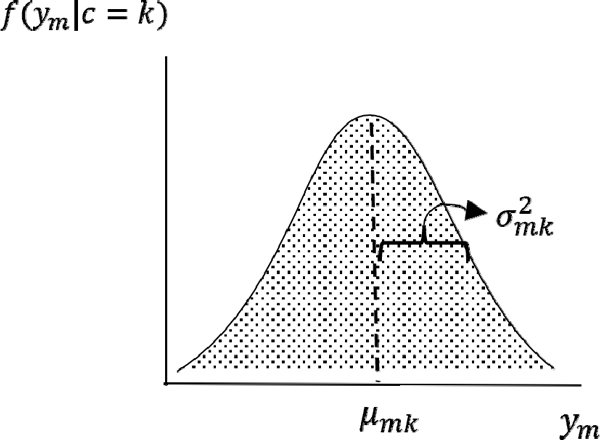
이와 같은 분포 모수들(즉, 평균과 분산)은 LCA에서와 같이 조건부확률밀도와 밀접한 관련이 있기 때문에, 지역독립성 가정 위배로 인해 조건부확률밀도가 편향될 경우 두 모수의 추정 역시 편향된다(Masyn, 2013). 이는 다음과 같은 각 잠재계층에서의 조건부확률밀도함수의 공식을 통해 확인할 수 있다.
위 식에서 P(ym | c = k)는 잠재계층변수 c가 k일 때 관찰변수 ym의 응답 경향성에 대한 조건부확률밀도를 의미한다. 식 7을 통해 알 수 있듯이 평균 μmk와 분산 는 조건부확률밀도 P(ym | c = k) 의 크기에 의해 결정된다. 즉, 조건부확률밀도에 대한 추정이 편향될 경우, 각 잠재계층에서 ym의 분포 모수들은 실제와 다른 값을 가지게 될 수 있으며, 그에 따라 잠재계층의 의미 역시 잘못 해석될 위험이 있다.
정리하면, LCA에서의 경계, 그리고 LPA에서의 평균 및 분산 모수는 모두 조건부확률과 밀접한 관계가 있으며, 지역독립성 가정의 위배로 인해 편향된 조건부확률의 추정은 이와 같은 주요 모수의 추정을 함께 편향시킴으로써 분석의 정확성을 떨어뜨리고, 잠재계층의 의미를 오해석하게 만든다. 게다가, 많은 선행연구에서 지역독립성 가정의 위배에 의해 발생하는 분포 모수의 편향은 잠재계층의 수를 결정하거나 모형의 적합도를 평가하는 데에도 많은 영향을 미친다고 알려져 있다(Albert & Dodd, 2004; Torrance & Walter, 1998). 즉, 지역독립성 가정의 위배로 인한 모수 추정의 편향은 잠재계층의 의미를 왜곡시키고, 나아가 모형의 적합성 또한 신뢰하기 어렵게 만들 수 있다. 따라서 연구자가 LCA 혹은 LPA를 연구에 이용하고자 한다면, 적절한 탐지 방법을 이용하여 지역독립성 가정이 위배되었는지를 확인하는 과정은 필수적이다.
LCA와 LPA에서 지역독립성 가정의 위배 탐지 방법
LCA와 LPA에서 지역독립성 가정의 위배를 탐지하는 모든 방법의 기본적인 핵심 원리는 잠재계층 내에서 관찰변수들 간 상관이 존재하는지를 확인하는 것이다. 관찰변수 간 관련성을 효율적으로 탐지하기 위하여 다양한 수리적 원리와 절차를 적용한 탐지 방법들이 제안되었으나(Magidson & Vermunt, 2004; McLachlan & Peel, 2000; Muthén & Shedden, 1999), 앞서 언급했듯이 이와 같은 연구들은 대부분 LCA의 맥락에서만 진행되어 왔다. 이는 잠재계층분석이 이분형 변수를 활용한 분석 방법에서 출발하여 연속형 변수를 이용하는 방법으로 발전됨에 따라, 지역독립성 가정의 위배 여부를 탐지하는 방법 자체도 오랜 시간 동안 이분형 변수에 대한 방법들을 위주로 발전되었기 때문이다(Hagenaars, 1988; Nylund & Choi, 2018; Vermunt, 1997). 이러한 이유로 LPA의 맥락에서 지역독립성 가정의 위배를 판단할 수 있는 방법에 대해서는 제대로 다루어지지 않았으며 참고할 수 있는 문헌도 절대적으로 부족하다. 이는 연구자들이 각자의 연구 상황에서 어떤 탐지 방법을 적용하는 것이 가장 적절한지를 파악하는 일에 어려움을 겪게 만든다. 이 섹션에서는 기존 LCA에서 지역독립성 가정의 위배를 탐지하는 방법들을 체계적으로 분류하고, 이와 같은 방법들이 갖는 개념적 원리를 상세히 설명하며, 나아가 각 방법에서 사용하고 있는 핵심적인 아이디어를 연속형 관찰변수에 적용함으로써 LPA에서 지역독립성 가정의 위배 여부를 확인하는 방법을 제시한다.
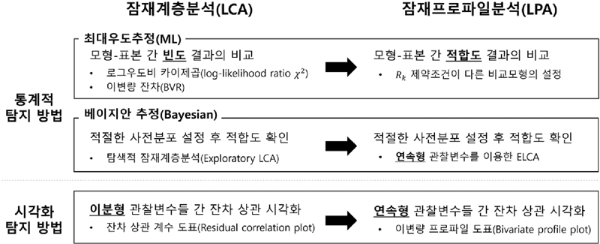
현재까지 논의되어 온 LCA의 맥락에서 지역독립성 가정의 위배를 탐지하는 방법들은 그 확인 방식에 따라 크게 통계적 방법과 시각화 방법으로 나누어질 수 있다. 통계적 방법은 모형에 포함된 다양한 모수를 추정하고 그 통계적 유의성을 확인함으로써 지역독립성 가정의 위배를 확인하는 탐지 방법이며, 시각화 방법은 도표를 통해 시각적으로 지역독립성 가정의 위배를 확인하는 탐지 방법이다. 이 중 통계적 방법은 다시 모형 추정에 이용된 추정 방법이 무엇인지에 따라 구분될 수 있으며, 대표적으로는 최대우도 추정과 베이지안 추정에 기반한 탐지 방법들이 잘 알려져 있다. 최대우도 추정을 이용한 탐지 방법의 경우, 그 원리를 이해하기 쉽고 접근성이 높다는 장점이 있으나, 일반적으로 전체 잠재계층에 대한 탐지 결과를 제공하기 때문에 어떤 잠재계층에서 가정이 위배되었는지 확인하기 힘들다는 단점이 있다(Asparouhov & Muthén, 2015; Visser & Depaoli, 2022). 반면, 베이지안 추정을 이용한 탐지 방법의 경우, 앞선 최대우도 추정 방법들에 비해 잠재계층별 가정의 위배 여부를 쉽게 파악할 수 있다는 장점이 있으나, 부적절한 사전분포를 지정했을 때 결과의 정확성과 안정성이 저해될 수 있다는 단점이 있다(Depaoli et al., 2020). 주목할만한 사실은, 이처럼 LCA에서 논의되어 온 여러 탐지 방법들이 각각의 분류에 따라 LPA로도 확장될 수 있다는 것이다. 그림 4는 LCA에서 이용되는 대표적인 탐지 방법들을 최대우도 추정 및 베이지안 추정에 기반한 통계적 방법 및 시각화 방법으로 분류하고, 각 분류에 따라 LPA에 적용 가능하도록 탐지 방법을 확장하는 기본 아이디어를 보인다. 이와 같은 구분에 따라, LCA 및 LPA에서 각 방법을 이용한 지역독립성 가정 위배 탐지의 원리는 다음과 같이 나누어 설명될 수 있다.
최대우도 추정을 이용하는 지역독립성 가정 위배의 통계적 탐지 방법
최대우도 추정은 모형과 자료가 주어졌을 때 자료의 발생확률, 즉 우도 함수를 최대화하는 모수를 찾는 추정 방법으로 일반적으로 관찰된 조건부확률에 대한 정보를 EM 알고리즘(expectation-maximization algorithm, Dempster et al., 1977)을 적용하여 반복계산함으로써 실행된다(Formann, 1978; Goodman, 1979). 최대우도추정은 대부분의 LCA와 LPA 연구에 이용되는 추정 방법이기 때문에(Nylund & Choi, 2018; Sinha et al., 2021), 이에 기반한 탐지 방법들 또한 비교적 널리 알려져 있다. 이와 같은 탐지 방법들은 모형에 대한 통계적 검정을 통해 지역독립성 가정의 위배 여부를 판단하므로 시각화에 비해 상대적으로 객관적인 방법이라고 볼 수 있으며, 검정의 기각 여부를 통해 연구자들이 지역독립성 가정의 위배를 보다 선명하게 탐지할 수 있다는 장점이 있다.
해당 추정 방법에 기반한 탐지 방법들은 공통적으로 통계적 검정을 통해 지역독립성을 가정한 모형 함의(model-implied) 결과와 관찰 자료 기반의 결과를 비교하는 원리를 이용한다. 구체적으로, LCA의 경우에는 지역독립성을 가정한 모형 기반의 기대빈도와 자료 기반의 관찰빈도를 비교하는 방법을 이용하며, LPA에서는 지역독립성을 가정한 모형의 적합도와 해당 가정 없이 자료 기반으로 추정한 모형의 적합도를 비교하는 방법을 이용한다.
LCA
최대우도 추정을 사용하는 LCA에서 사용할 수 있는 지역독립성 가정의 위배를 탐지하기 위한 방법들은 많은 연구자에 의해 다양하게 제안되어 왔는데(Espeland & Handelman, 1989; Garrett & Zeger, 2000; Magidson & Vermunt, 2004; Qu et al., 1996), 본 연구에서는 이 중에서도 Mplus의 tech10 옵션에서 제공하는 로그 우도비 χ2 검정(log-likelihood ratio chi-squared test)과 이변량 잔차(bivariate residual, BVR)를 이용하는 방법을 다룬다.2) 두 방법은 어떤 관찰변수에서 지역독립성 가정이 위배되었는지 탐지하기 위해 χ2 독립성 검정의 원리를 이용한다. χ2 독립성 검정은 빈도를 이용하여 두 범주형 변수가 서로 독립적인지의 여부를 확인하는 검정이다. 지역독립성 가정의 만족은 잠재계층 내 두 관찰변수 간 상관이 없음을 의미하므로, 독립성 검정을 통해 변수 쌍에 대한 관찰빈도와 기대빈도를 비교함으로써 판단할 수 있다. 예를 들어, 표 1과 같이 두 개의 이분형 관찰변수 y1, y2가 있을 때, 두 변수를 이용한 2 × 2 분할표는 관찰된 빈도 O(y1, y2)와 지역독립성 가정을 기반으로 산출되는 기대빈도 E(y1, y2)에 대해 작성될 수 있으며, 다음의 식에 의해 계산된다.
표 1.
두 이분형 관찰변수 y1, y2의 관찰빈도와 기대빈도에 대한 2 × 2 분할표
| 빈도의 종류 | 변수 y1 | 변수 y2 | |
|---|---|---|---|
| y2 = 0 | y2 = 1 | ||
| O(y1, y2) (관찰빈도) |
y1 = 0 | O(0, 0) | O(0, 1) |
| y1 = 1 | O(1, 0) | O(1, 1) | |
| E(y1, y2) (기대빈도) |
y1 = 0 | E(0, 0) | E(0, 1) |
| y1 = 1 | E(1, 0) | E(1, 1) | |
위 식에서 N은 전체 피험자의 수, P(y1 | c = k) 와 P(y2 | c = k) 는 잠재계층변수 c = k일 때 각각 관찰변수 y2과 y1의 조건부확률을 의미한다. 즉, 기대빈도는 LCA에서 추정된 모수인 잠재계층비율과 조건부확률을 기반으로 각 잠재계층별로 계산된 빈도를 합하여 전체 빈도에 대해 계산된 값이다. 이때 지역독립성 가정의 위배 여부는 관찰빈도와 기대빈도 분할표에서 얻어진 각 빈도 간 차이에 대한 유의성 검정을 통해 탐지할 수 있다. 즉, 총 m개의 관찰변수가 있을 때 가능한 모든 두 변수의 쌍으로 이루어진 관찰빈도와 기대빈도에 대한 mC2 개의 분할표에서 두 빈도 간 차이 O(y1, y2) - E(y1, y2)의 크기를 통계적으로 검정하는 것이다. 이처럼 χ2 독립성 검정의 원리를 이용한 지역독립성 가정의 위배 탐지 방법은 검정을 위한 이변량 통계량을 어떻게 이용하는지에 따라 다음의 두 가지 방법으로 구분된다.
첫 번째 방법은 Espeland와 Handelman(1989)이 제안한 로그 우도비 χ2 검정이다.3) 해당 방법은 기대빈도를 획득할 우도와 관찰빈도를 획득할 우도의 비율을 이용하는 통계적 검정 방법인 Wilks(1935)의 우도비 검정 원리에 기반한다. 개념적으로 이는 지역독립성 가정이 만족되었을 때 기대빈도 정보와 실제 관찰빈도 정보 간 차이를 로그 우도비를 통하여 확인하는 방법으로 볼 수 있다. 이때 검정을 위한 이변량 통계량은 관찰빈도 및 기대빈도 분할표의 차이에 기반하여 다음과 같이 계산된다.
위에서 L(y1, y2)는 이분형 관찰변수 y1과 y2에 대한 로그 우도비를 가리킨다. 식 9에 따르면, L(y1, y2)는 O(y1, y2)와 E(y1, y2)가 동일할 때 가장 작은 값을 가질 것으로 기대된다. 즉, 로그 우도비 값은 관찰빈도와 기대빈도의 차이에 비례해서 큰 값을 가지게 되므로 우도비의 크기는 지역독립성 가정의 위배 정도를 반영한다. 이때 L(y1, y2)는 독립성 여부를 판단하기 위한 χ2 검정통계량으로 사용될 수도 있다(Espeland & Handelman, 1989). 즉, L(y1, y2)가 을 따르기 때문에 해당 값이 기각값보다 커지면, 잠재계층 내 두 관찰변수가 독립이라는 영가설을 기각하고 지역독립성 가정이 위배되었다고 판단한다.
두 번째 방법은 Magidson과 Vermunt(2004)가 제안한 이변량 잔차를 이용하는 방법이다. BVR은 계산 원리가 직관적이고 쉬운 편이기 때문에 잔차 상관 정도를 파악하고자 하는 많은 연구자들에게 매력적인 지표로 사용되고 있다(Oberski et al., 2013). 또한, LCA를 이용하는 연구자들에게 가장 많이 사용되고 있는 통계 프로그램 Mplus(Muthén & Muthén, 1998–2017)와 Latent GOLD(Vermunt & Magidson, 2021)에서 공통적으로 지역독립성 가정의 위배 여부를 판단하기 위해 제공되는 지표로, 접근성이 좋다는 장점이 있다. 해당 지표는 이변량 Pearson 검정통계량을 구하는 방식으로 산출되며, 다음의 식과 같이 구할 수 있다.
위 식에서 T(y1, y2)는 두 관찰변수 y1, y2에 대한 BVR 값을 가리킨다. BVR이 클수록 지역독립성 가정의 위배 정도가 심하다고 판단할 수 있지만, 앞선 방법과 다르게 가설검정을 이용할 수는 없다. 이는 BVR이 이론적으로는 χ2 검정통계량에 기반한 값임에도 불구하고, 많은 경우에 χ2 분포를 따르지 않는다고 알려져 있기 때문이다(Vermunt & Magidson, 2021). 따라서 BVR을 통해 지역독립성 가정의 위배 여부를 판단하기 위해서는 BVR 값의 절대적인 크기(3.84 이상, Bakk et al., 2022; 10 이상, Visser & Depaoli, 2022; 20 이상, Asparouhov & Muthén, 2015)를 확인함으로써 위배 정도를 파악하거나, 부스트래핑을 이용한 독립성 검정 방법을 이용한다(Oberski et al., 2013; 서영숙, 2020).
LPA
최대우도 추정을 이용하는 LPA에서 지역독립성 가정의 위배를 탐지하는 방법은 지역독립성을 가정한 모형의 결과와 표본의 결과를 비교하는 원리를 이용한다. 다만 LCA와 달리 LPA는 빈도 정보를 이용할 수 없으므로, 두 결과를 비교하기 위한 대안적인 접근이 필요하다. 한 가지 방법은 잠재계층 내 상관행렬에 대한 모수 제약이 서로 다른 두 모형의 적합도를 비교하는 것이다. 이때 두 모형에서 각각 추정되는 상관행렬은 표 2와 같이 구분될 수 있다. 즉, LPA의 지역독립성 가정 위배 탐지를 위해서는 (a)에서와 같이 잠재계층 내 상관행렬을 항등행렬로 제약한 모형(즉, 지역독립성이 가정된 모형)의 적합도와 (b)에서와 같이 잠재계층 내 상관행렬의 비대각 요소를 0으로 고정하지 않고 자유롭게 추정한 모형(즉, 표본 결과가 반영된 모형)의 적합도를 비교한다. 만약 지역독립성이 가정된 모형의 적합도가 표본 결과가 반영된 모형의 적합도에 비해 현저하게 나쁘다면, 지역독립성 가정이 위배된 것으로 고려할 수 있다. 이와 같은 적합도 비교에는 내재된 관계의 두 모형 간 비교에 널리 활용되는 χ2 차이 검정을 이용할 수 있다(Pastor et al., 2007). 즉, 지역독립성을 가정한 간명한 모형과 지역독립성이 가정되지 않은 복잡한 모형 간의 χ2 차이가 통계적으로 유의하게 나타날 경우, 지역독립성 가정이 위배되었다고 판단할 수 있다.
표 2.
LPA의 지역독립성 가정 위배 탐지를 위해 설정된 두 모형에서 추정되는 상관행렬 Rk
| (a) 지역독립성을 가정한 잠재계층 내 상관행렬 Rk | (b) 지역독립성을 가정하지 않은 잠재계층 내 상관행렬 Rk |
적합도 비교를 통해 지역독립성이 위배되었다고 판단되면, 구체적으로 어떤 잠재계층 내 관찰변수들에서 가정이 위배되었는지 확인하기 위해 각 잠재계층 내 관찰변수 간 Pearson 상관계수를 추정할 수 있다. Pearson 상관계수를 기반으로 추정한 Rk의 비대각 요소 중 0과 유의하게 다른 값이 있다면 해당 관찰변수들에서 지역독립성 가정이 위배되었다고 판단한다. 이때 지역독립성 가정의 위배 여부를 판단하는 상관계수 크기에 대한 기준은 연구자들마다 다르게 제시되어 왔다. 가정의 위배를 탐지하는 방법들의 정확성을 확인하기 위한 대부분의 시뮬레이션 연구들에서는 위배 기준을 0.2로 설정하였고(Lee et al., 2020; Oberski et al., 2013; Visser & Depaoli, 2022), 관행적으로 잠재계층 내 관찰변수 간 상관계수가 0.5 이상일 경우, 허위 잠재계층을 추출하거나 모형의 적합도를 잘못 추정하는 데 영향을 미칠 수 있다고 알려져 있다(Sinha et al., 2021). 다만, 해당 값은 절대적인 기준이 아니며, 연구자는 유의하다고 판단되는 상관계수가 관찰된 경우 가정의 위배 여부를 면밀히 검토할 필요가 있다.
베이지안 추정을 이용하는 지역독립성 가정 위배 탐지 방법
베이지안 추정은 최대우도 추정과 달리 모수를 상수가 아닌 변수로 가정하는 접근법으로, 모수들에 대한 사전 믿음을 반영하는 사전분포를 설정한 후 주어진 자료를 통해 이 분포를 반복적으로 갱신함으로써 사후분포를 추정하는 방법이다(Gelman, 2003; Kaplan, 2023; Silva & Ghahramani, 2009; van de Schoot et al., 2021). 베이지안 방법은 관찰변수의 유형에 관계없이 동일한 방법을 적용하여 지역독립성 가정의 위배 상황을 확인할 수 있다는 장점이 있으며, 뒤에서 더욱 자세히 다루겠지만 잠재계층별로 각기 다른 정보성을 가진 상관행렬에 대한 사전분포를 설정함으로써 가정의 위배 상황을 잠재계층마다 보다 쉽게 확인할 수 있다는 장점도 존재한다.
베이지안 추정을 이용하는 LCA와 LPA는 잠재계층 내 상관행렬 Rk가 항등행렬 Ik일 것이라는(식 4 참고) 사전 믿음을 완화한 사전분포를 지정함으로써 지역독립성 가정이 위배되었는지 확인한다. 참고로, 앞서 설명된 최대우도 추정 시 지역독립성 가정의 위배를 탐지하는 방법들은 관찰변수의 유형에 따라 빈도를 비교하는 방법(LCA)과 적합도를 비교하는 방법(LPA)으로 구분되었던 반면, 베이지안 추정을 이용하는 탐지 방법은 LCA와 LPA에 동일하게 적용될 수 있다. 이는 LCA의 상관행렬에 대한 사전분포 지정 시 이분형 관찰변수 대신 잠재반응변수에 대한 연속형 사전분포를 지정하는 원리를 이용함에 따라(Asparouhov & Muthén, 2011; Lee et al., 2020), 해당 방법이 연속형 관찰변수를 사용하는 LPA에 그대로 적용될 수 있기 때문이다(Asparouhov & Muthén, 2021).
베이지안 추정을 이용하는 LCA와 LPA에서 지역독립성 가정 위배 여부를 확인하기 위해 활용되는 방법은 탐색적 잠재계층분석(Exploratory LCA, ELCA; Asparouhov & Muthén, 2011)이다. ELCA는 잠재계층 내 상관행렬의 모든 요소를 탐색적으로 추정하는 방법으로, 해당 상관행렬이 항등행렬로 고정되어 있는 일반적인 LCA 및 LPA와는 차이가 있다. 즉, ELCA는 잠재계층 내 관찰변수 간 상관행렬을 고정하지 않고 추정하는 분석 방법이라고 볼 수 있다. 베이지안 추정을 이용하는 ELCA에서 잠재계층 내 상관행렬의 추정에는 제한적인 사전 정보 전략(restrictive prior strategy, Muthén & Asparouhov, 2012)이 이용된다. 제한적인 사전 정보 전략이란 베이지안 추정 시 아주 작은 분산을 갖는 사전분포를 이용하여 잠재계층 내 상관행렬을 항등행렬에 매우 가깝게 추정하는 접근법을 말한다. 이 방법을 이용할 때 가장 중요하게 고려해야 하는 것은 적절한 사전분포를 설정하는 것이다. 베이지안 추정에서 일반적으로 활용되는 상관행렬의 모수에 대한 사전분포로는 감마 분포, 역감마 분포, 위샤트 분포 등이 이용될 수 있으나(이지윤, 김수영, 2021), 그 중 ELCA는 역위샤트 분포를 주로 이용한다(Asparouhov & Muthén, 2011). 역위샤트 분포는 역감마 분포를 다변량으로 확장한 분포로, 상관행렬의 사전분포는 IW(I, f)로 정의된다. 여기에서 I는 사전분포의 평균으로 잠재계층 내 관찰변수 간 상관행렬이 항등행렬에 근사할 것이라는 사전 정보를 반영하고, f는 사전분포의 분산을 결정하는 자유도로 해당 정보가 얼마나 확실한가에 대한 믿음의 정도를 나타낸다. f가 큰 값일수록 분산의 크기는 작게 설정되므로, 연구자는 잠재계층 내 상관행렬에 대한 사전분포에서 f의 크기를 조절함으로써 사전 정보의 강도를 결정할 수 있다. 즉, f가 클수록 잠재계층 내 모든 관찰변수 간 상관계수는 0에 더 근사한 값으로 설정되며, 이는 곧 지역독립성이 만족될 것이라는 믿음의 정도(즉, 사전분포의 정보성)가 더 강해짐을 의미한다.
이와 같은 사전분포에 기반한 ELCA 모형은 잠재계층 내 관찰변수들이 모두 근사적으로 독립적(Asparouhov & Muthén, 2011)이라는 가정하에 추정된다. 따라서 해당 모형의 적합도가 양호하다면 모든 관찰변수들에 대해 지역독립성 가정이 만족되는 것으로 볼 수 있다. 모형의 적합도는 베이지안 추정에서 적합도로서 제공되는 PPP(posterior predictive p-value, Gelman et al., 1996)를 통해 확인할 수 있다. 일반적으로 PPP 값이 0.5에 가까운 값이면 좋은 적합도로, 0.1이나 1에 가까운 값이면 유의하게 문제가 발생한 적합도로 지역독립성 가정이 위배되었다고 판단한다(Muthén & Asparouhov, 2012).
베이지안 추정 기반의 ELCA 방법은 앞선 최대우도 추정 기반의 방법들과 구분되는 한 가지 강력한 장점을 갖는다. 이는 지역독립성 가정의 위배가 어떤 잠재계층에서 발생했는지를 쉽게 파악할 수 있다는 것이다. 앞서 소개한 최대우도 추정에서의 탐지 방법들은 일반적으로 지역독립성을 가정한 모형 기반의 기대빈도를 잠재계층별로 구하는 것이 아니라, 전체 빈도에 대해 구하여(식 8 참고) 관찰빈도와 비교하는 원리를 이용한다. 따라서 전반적인 지역독립성 가정의 위배에 대해서는 확인할 수 있지만, 구체적으로 어떤 잠재계층에서 가정이 위배되었는지 파악하기 힘들다. 이 경우, 잠재계층별 가정의 위배 여부를 탐지하기 위해서는 연구자가 직접 잠재계층별 기대빈도의 발생확률을 토대로 탐지에 필요한 수치(예를 들어, 로그 우도비 혹은 BVR)를 계산해야 한다는 번거로움이 있다. 반면, 베이지안 추정에서의 ELCA 방법은 잠재계층별 독립성에 대한 사전분포의 정보성을 다르게 반영할 수 있기 때문에 어떤 잠재계층에서 가정의 위배가 발생했는지 확인할 수 있다. 예를 들어, 만약 특정 잠재계층에 대해서 정보성이 더 높은 사전분포를 이용하도록 모형을 설정했을 때 산출되는 PPP가 여전히 양호하다면 해당 잠재계층에서는 지역독립성 가정이 만족되었다고 판단할 수 있다. 반면, PPP가 낮아짐과 동시에 해당 잠재계층 내 관찰변수 간 상관계수가 0과 크게 다르게 추정된다면 해당 잠재계층에서 지역독립성 가정이 위배되었을 가능성이 높다. 즉, ELCA 방법을 이용하면 산출된 PPP와 사후 추정된 각 잠재계층 내 관찰변수 간 상관계수를 통해 어떤 잠재계층에서 지역독립성 가정이 위배된 것인지 보다 효율적이고 정확하게 알 수 있다. 단, 해당 방법을 이용하는 경우에는 연구자가 설정한 사전분포의 믿음의 강도에 따라 추정 결과가 달라질 수 있으므로 연구자의 주관이 분석 결과에 영향을 미칠 가능성이 있으며, 부적절한 사전분포 설정 시 지역독립성 가정의 위배 상황에 대한 탐지의 민감도가 저하될 수 있음에 주의해야 한다(Depaoli et al., 2020; Lee et al., 2020).
시각화를 이용한 지역독립성 가정 위배 탐지 방법
지역독립성 가정의 위배 여부를 탐지하기 위한 방법에는 지금까지 다루었던 통계적 방법 외에 시각화를 이용하는 방법도 존재한다. 시각화 방법은 잠재계층 내 모든 관찰변수들 간 상관 정보를 하나의 도표로 제공하는 방법이다. 해당 방법은 지역독립성 가정의 위배 여부를 한눈에 파악할 수 있게 해주므로 LCA와 LPA를 이용하는 연구자들에게 효율적인 의사결정의 토대를 제공할 수 있다. 다만, 시각화 방법들은 주로 탐색적 목적에 의해 이용되는 방법이므로, 정량적 위배 정보를 확인하기 위해서는 다른 통계적 탐지 방법과 병행하여 사용하는 것이 바람직하다.
LCA와 LPA의 시각화 방법은 서로 구분되는데, 이는 관찰변수의 유형에 따라 이용되는 상관 정보가 다르기 때문이다. 이분형 관찰변수를 사용하는 LCA의 시각화 방법은 앞선 최대우도 추정을 이용한 지역독립성 가정의 위배 여부를 탐지하는 방법에서 사용되었던 관찰빈도와 기대빈도를 비교하는 원리를 기반으로 제안되었다. 즉, LCA의 시각화 방법은 빈도 분할표를 기반으로 산출된 잠재계층 내 관찰변수 쌍의 관련성에 대한 정보를 도표로 제공하는 방법이다. LCA의 시각화 방법에는 Qu 등(1996)이 제안한 잔차상관도표(residual correlation plot), Sepúlveda 등(2008)이 제안한 행렬도(biplot), Garrett과 Zeger(2000)가 제안한 LORC 도표(log ratio check plot)와 같은 방법들이 존재하나, 행렬도와 LORC 도표의 경우 그 절차가 수리적으로 매우 복잡하고 잘 사용되지 않는 방법이다. 따라서 본 연구는 실제 연구자들이 LCA 연구에서 가장 많이 활용하는 시각화 방법인 잔차상관도표에 대해 다룬다. 한편, 연속형 관찰변수를 사용하는 LPA에서는 연속형 변수 간 상관관계를 시각적으로 표현할 때 가장 많이 사용되는 산포도(scatter plot)를 모든 관찰변수 쌍에 대해 하나의 도표로 표현한 산포도 행렬을 이용할 수 있다.
LCA
잔차상관도표는 관찰빈도와 기대빈도의 잔차 상관계수 정보를 시각화하는 방법으로서 임의의 두 관찰변수 쌍과 그에 상응하는 잔차 상관계수의 정보를 시각적으로 표현한다. 이때 잔차 상관계수는 관찰빈도 분할표에서 계산된 상관계수와 기대빈도4) 분할표에서 계산된 상관계수의 차이로 정의된다. 그림 5는 5개 관찰변수에 대한 잔차상관도표의 예시이다. X축은 관찰변수 쌍을, Y축은 각 관찰변수 쌍에 상응하여 산출되는 잔차 상관계수를 나타내며, 다음의 식에 의해 계산된다.
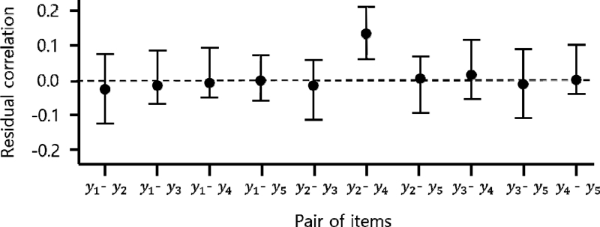
위 식에서 corrij는 두 관찰변수 yi와 yj의 잔차 상관계수를, P(yi = 1, yj = 1)는 관찰빈도표를 통해 계산되는 두 관찰변수에 대해 동시에 1로 응답할 확률을, 과 은 기대빈도표를 통해 계산되는 두 관찰변수에 대해 각각 1로 응답할 확률을 가리킨다. 즉, yi와 yj의 잔차 상관계수는 관찰된 확률과 기대되는 확률의 차이 값을 의 표준오차로 나누어줌으로써 구할 수 있다. 이때 Y축의 참조선(residual correlation=0)은 관찰확률과 기대확률의 차이가 없다는 의미이므로 지역독립성 가정의 만족을 의미하는데, 해당 참조선에서 많이 벗어날수록 지역독립성 가정의 위배 정도가 심해짐을 나타낸다. 따라서 그림 5의 예시에서는 관찰변수의 쌍 y2-y4에서 지역독립성 가정이 위배되었음을 알 수 있다. 보다 정확한 탐지를 위해, 그림의 실선 범위와 같이 95% 부스트래핑 신뢰구간 선을 추가로 그어 해당 범위 안에 참조선이 들어오는지 확인함으로써 위배 정도를 판단하기도 한다. 이때 부스트래핑 신뢰구간은 기대빈도 기반의 잔차 상관계수를 일정한 수(예를 들어 10,000)만큼 반복 추출하여 가상의 모집단 분포를 만들고, 이에 대한 평균과 표준오차 정보를 이용해서 계산할 수 있다. 이와 같은 정보들을 포함한 잔차상관도표는 하나의 도표를 통해 모든 관찰변수 쌍에 대한 지역독립성 가정의 위배 여부를 한눈에 확인할 수 있다는 장점이 있다.
LPA
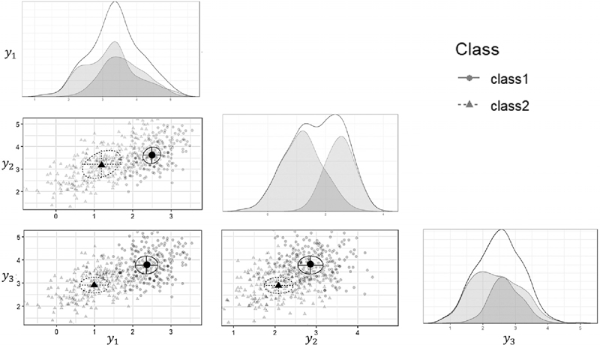
LPA에서 시각화를 통해 가정의 위배를 확인하기 위해서는 Van Lissa 등(2023)이 제안한 이변량 프로파일도표(Bivariate profile plot)를 이용할 수 있다. 이 방법은 잠재계층 내 관찰변수 간 상관 정보를 산포도 행렬로 표현하는 방법이다. 그림 6은 3개의 관찰변수에 대한 이변량 프로파일도표의 예시로, 대각 요소에는 각 잠재계층의 밀도 도표(density plot)가, 비대각 요소에는 잠재계층별로 모양이 다르게 구분된 모든 관찰변수들 간 산포도가 위치한다. 관찰변수들 간의 상관이 있을 경우 모든 점들의 분포는 대각선 방향의 선형적인 패턴을 보이므로, 연구자는 각 관찰변수 쌍에 해당하는 산포도의 모양을 보고 잠재계층 내 관찰변수 간 상관의 정보를 파악할 수 있다. 예를 들어, 그림 6의 관찰변수 y1과 y2에 대한 산포도에서 잠재계층 2의 분포는 잠재계층 1의 분포에 비해 대각선 방향의 선형적인 패턴을 가진다. 이 경우, 잠재계층 2의 관찰변수 쌍 y1-y2에서 지역독립성 가정이 위배되었다고 판단할 수 있다. 이처럼 이변량 프로파일도표는 산포도의 형태를 통해 각 잠재계층에서 관찰변수 간 상관의 부호와 유의미한 정도에 대한 정보를 시각적으로 제공하므로, 어떤 잠재계층과 관찰변수 쌍에서 지역독립성 가정이 위배되었는지 한눈에 탐지할 수 있다.
LCA와 LPA에서 지역독립성 가정의 위배를 모형화하는 방법
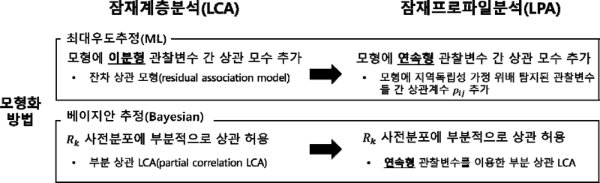
앞서 다룬 방법들을 통해 지역독립성 가정의 위배가 탐지될 경우, 모든 관찰변수가 독립임을 가정하는 기존의 LCA 및 LPA 모형을 사용하는 것은 적절하지 않다. 즉, 이는 식 3에서와 같이 특정 응답 패턴이 나타날 조건부확률을 각 문항에 응답할 확률의 단순 곱 형태로 계산하는 것이 편향된 추정 결과를 유발할 수 있음을 의미한다. 따라서, 이 경우 연구자는 모형의 일부를 수정하여 가정이 위배된 상황을 모형 안에 반영해야 한다. 이때 LCA 및 LPA에서 위배된 지역독립성 가정을 반영하는 모든 모형화 방식들은 공통적으로 잠재계층 내 관찰변수 간 상관의 제약을 풀어주는 과정을 포함한다. 즉, 기존의 모형에서 0으로 고정했던 잠재계층 내 관찰변수 간 상관을 0이 아닌 값으로 추정하게끔 모형을 수정하는 것이다. 그림 7에 제공된 다양한 모형화 방법들은 앞서 논의된 통계적인 탐지 방법들처럼 분석에 적용된 추정 방법에 따라 분류될 수 있다. 본 연구에서는 LCA의 최대우도 추정과 베이지안 추정 방법에서 각각 대표적으로 사용되는 모형화 방법인 잔차상관모형(residual association model, Asparouhov & Muthén, 2015)과 부분 상관 LCA(partial correlation LCA, Asparouhov & Muthén, 2011)를 주요하게 설명하고, 각 방법을 연속형 관찰변수를 이용하는 LPA에 적용하는 방안에 대해 구체적으로 논의한다.
최대우도 추정을 사용하는 지역독립성 가정 위배 모형화 방법
LCA
만약 연구자가 최대우도 추정을 사용한다면, 우도비 검정, BVR 등을 통해 LCA의 지역독립성 위배를 탐지할 수 있으며, 이 경우 잔차상관모형을 이용하여 모형을 수정할 수 있다. 잔차상관모형에 대한 논의를 위해서는 먼저 로그 선형화 모수표현 방식에 대한 이해가 필요하다. 이는 잔차상관모형이 해당 모수표현 방식에 기반하여 제안된 모형이기 때문이다. 로그 선형화 모수표현 방식이란 모형을 이분형 반응변수 자체가 아닌 그 기저에 존재하는 연속적인 잠재변수에 대해 표현한 것으로 정의된다. 이 모수표현 방식은 앞서 식 1에서 이용한 확률적 모수표현 방식과 모형을 기술하는 방법에 차이가 있으나, 통계적으로는 동치이다(Goodman, 1974). LCA에서 지역독립성 가정이 만족된 경우, 이를 로그 선형화 모수표현 방식으로 나타낸 것을 표준 로그 선형화 모형(standard log-linear model)이라고 한다. 해당 모형은 다음의 식과 같이 정의된다(Haberman, 1979).
위에서 lnP(c, y1, y2, ... ,yM)은 피험자가 잠재계층변수 c와 M개의 관찰변수에 대해 특정 응답 패턴을 가질 로그 확률, β0는 절편, βcc는 c의 주효과 항, 은 모든 ym들의 주효과 항, 는 c와 ym들에 대한 상호작용효과 항을 가리킨다. 식 12에서 보이듯이 지역독립성이 만족되면, 모형은 각 잠재계층변수의 주효과 항과 관찰변수들의 주효과 항, 그리고 각 관찰변수들과 잠재계층변수의 상호작용효과 항의 합으로만 구성된다.
잔차상관모형화는 위와 같은 표준 로그 선형화 모형에서 관찰변수 간 상관에 대한 제약을 풀어줌으로써 모형을 수정하는 방법이다. 지역독립성 가정이 위배되면, 연구자는 모든 관찰변수들이 서로 독립적(즉, 모든 관찰변수 간 상관은 0)이라는 기존의 제약을 풀고, 관찰변수 간 관련성에 대한 정보를 모형 안에 추가적으로 포함시킬 필요가 있다. 다시 말해, 기존의 표준 로그 선형화 모형(식 12)은 다음의 식과 같이 관찰변수 간 상호작용 효과 항을 추가하는 방식으로 수정된다.
위에서 βijyiyj는 관찰변수 yi와 yj의 상호작용효과 항을 가리킨다. 식 13은 식 12에 βijyiyj가 추가된 수식으로, 지역독립성 가정이 위배된 yi와 yj의 상관을 추가한 것이다. 즉, 표준 로그 선형화 모형에서 0으로 고정했던 관찰변수 간 상호작용항의 제약(즉, βij = 0)을 지역독립성 가정이 위배된 관찰변수에 한해 풀어주는 모형화 방법이다.
이처럼 잔차상관모형은 관찰변수 간 상호작용효과를 모형에 추가함으로써 지역독립성 의 위배 상황을 반영할 수 있다(Asparouhov & Muthén, 2015). 이를 통해 연구자는 해당 관찰변수 간 상호작용항이 실제로 0과 얼마나 다른 값인지 검토할 수 있을 뿐 아니라, 이와 같은 모형 수정으로 모형의 적합도가 나아지는지도 확인할 수 있다. 또한 이 모형화 방법은 모든 관찰변수 간 상호작용항을 모형에 포함시킴으로써 지역독립성 가정의 위배를 탐지하는 것도 가능하다. 다만, 모형 내에 너무 많은 상호작용항이 포함될 경우 계산과정이 복잡하고 추정에 걸리는 시간이 상대적으로 오래 소요된다는 단점이 있다.
LPA
잔차상관모형에 사용된 아이디어는 최대우도 추정을 이용하는 LPA에도 적용할 수 있다. 즉, 잔차상관모형에서 0으로 고정했던 관찰변수 간 상호작용에 대한 제약을 풀어주는 것처럼 LPA의 경우에도 잠재계층 내 상관행렬을 항등행렬로 제약하는 방식을 이용할 수 있다. 이때 모형의 간명성을 최대한 보존하기 위해 모든 비대각 요소가 아닌 지역독립성 가정이 위배되었다고 탐지된 관찰변수들의 상관계수에 한해 제약을 풀어줄 수 있다. 즉, 관찰변수 yi와 yj에 대한 지역독립성 가정이 위배되었다면, 모형의 잠재계층 내 상관행렬은 다음의 식과 같이 설정될 수 있다.
위에서 ρij는 잠재계층 k에 대한 연속형 관찰변수 yi와 yj의 Pearson 상관계수이다. 즉, 지역독립성을 가정한 모형에서 항등행렬 Ik로 제약했던(식 4 참고) 잠재계층 내 관찰변수 간 상관행렬 Rk를 식 14와 같이 yi와 yj의 상관계수에 한해 제약이 풀린 형태로 설정함으로써 지역독립성 가정이 위배된 상황을 반영하면서도 모형의 간명성을 최대한 높이는 방안을 사용한다.
베이지안 추정을 사용하는 LCA와 LPA의 지역독립성 가정 위배 모형화 방법
베이지안 추정을 이용하는 LCA에서는 앞서 언급되었던 ELCA의 맥락에서 잠재계층 내 상관행렬에 대한 사전 정보를 설정할 때 부분적으로만 지역독립성을 가정하는 부분 상관 LCA(Partial correlation LCA) 방법을 이용한다(Asparouhov & Muthén, 2011). 이 방법을 이용할 경우, 상관행렬의 베이지안 추정을 위한 사전분포의 평균은 더 이상 항등행렬이 아니며, 행렬의 일부 비대각 요소에 해당 변수들의 상관계수 값이 포함된다. 다시 말해, 일부 관찰변수 간 상관계수를 0이 아닌 사분 상관계수(tetrachoric correlation)에 근사한 값으로 추정하는 것이다. 이러한 방법은 연속형 관찰변수를 이용하는 LPA의 경우에도 거의 동일하게 적용할 수 있는데, 관찰변수 간 상관계수로 사분 상관계수를 이용하는 대신 Pearson 상관계수를 활용한다는 점에만 차이가 있다. 본 연구에서는 혼동을 피하기 위해 LCA와 LPA에 공통적으로 이용되는 해당 방법의 이름을 부분 상관 LCA로 통일한다.
부분 상관 LCA를 사용하는 데 있어서 한 가지 고려할 점은, 베이지안 추정을 이용하는 LCA 및 LPA에서 잠재계층 내 관찰변수 간 상관행렬의 사전분포는 MCMC 추정 이용 시 필요한 제약으로 인해 반드시 대각행렬이어야 한다는 사실이다(Asparouhov & Muthén, 2011). 따라서 일부 관찰변수 간 상관을 허용한 상관행렬을 그대로 베이지안 추정의 사전분포로 이용하는 것은 불가능하다. 이를 해결하기 위해 Asparouhov와 Muthén(2011)은 잠재계층 내 상관행렬 추정에 블록 대각행렬을 이용할 것을 제안하였다. 블록 대각행렬이란 대각 요소에 블록행렬(즉, 하위행렬)을, 비대각 요소에 0을 갖는 대각행렬로 정의되며 다음 식과 같이 표현될 수 있다.
위 식에서 M은 블록행렬의 개수, 그리고 Dm은 관찰변수들 간의 부분적인 하위 상관행렬로, 지역독립성이 위배된 변수들 간의 추정된 상관계수를 포함하는 블록행렬에 해당한다. 블록행렬을 구성하는 방법은 다음의 예시를 통해 이해할 수 있다. 만약, 5개의 관찰변수를 이용하는 LCA 및 LPA에서 일부 관찰변수들이 지역독립성 가정을 만족하지 않는 경우, 관찰변수에 대한 상관행렬은 다음과 같이 블록 대각행렬로 표현된다.
위에서 ρij는 잠재계층 내 i번째 관찰변수와 j번째 관찰변수 간의 상관계수, D1은 1, 4, 5번째 관찰변수들의 상관계수들 ρ41, ρ51, ρ54를 포함하는 블록 행렬, 그리고 D2는 2, 3번째 관찰변수들의 상관계수 ρ32를 포함하는 블록행렬이다. 예시에서와 같이 부분적인 상관이 허용된 관찰변수들에 대한 하위행렬을 블록행렬로 정의함으로써, 연구자는 일부 관찰변수 간 상관을 베이지안 방법을 이용하여 추정할 수 있다.
정리하면, 부분 상관 LCA는 지역독립성 가정의 위배가 탐지되었던 관찰변수 쌍에 대하여 상관계수 정보를 포함하는 블록행렬을 이용함으로써 변수들 간의 관련성을 모형에 추가하는 방법이다. 부분 상관 LCA를 이용한 모형화는 베이지안 방법의 장점을 모두 가지면서도 모형을 더 간명하게 만들 수 있다는 장점이 있다. 또한, 모형에 모든 관찰변수 간 상호작용항을 포함하지 않고도 일부 관찰변수들 간 상관만을 허용할 수 있기 때문에 보다 효율적인 추정이 가능해진다(Asparouhov & Muthén, 2011).
결론 및 논의
본 연구는 LCA와 LPA에서 지역독립성 가정과 관련된 개념을 종합하여 정리하고, 가정 위배의 탐지 및 모형화에 적용 가능한 다양한 방법들을 추정 방법에 따라 분류하여 논의하는 것을 목적으로 하였다. 최근 LCA와 LPA에 대한 관심이 높아짐에 따라 해당 방법을 이용한 연구가 계속 증가하는 추세임에도, 분석에 앞서 필수적으로 만족을 확인해야 하는 지역독립성 가정의 의미와 중요성이 많은 연구에서 간과되고 있다. 따라서 본 연구는 지역독립성 가정의 만족 여부를 확인하는 절차가 LCA와 LPA에서 매우 중요한 과정 중 하나임을 지적하고, 나아가 지역독립성 가정이 위배되었는지 직접 확인할 때 참고할 수 있는 방법을 제공하고자 하였다. 이러한 목적을 달성하기 위해, 본 연구는 지역독립성의 의미와 해당 가정의 위배가 모형 추정에 부정적인 영향을 미치는 원리를 탐색하였다. 뿐만 아니라, 최대우도 추정과 베이지안 추정을 사용하는 LCA와 LPA에서 각각 어떤 방법으로 지역독립성 가정의 위배 여부를 탐지하고, 이와 같은 위배 상황을 모형에 반영할 수 있는지 논의하였다.
LCA와 LPA에서 지역독립성 가정은 추정을 위한 수리적 절차를 효율적으로 만들고 모형의 간명성을 증가시키는 이점이 있기 때문에 대부분의 연구에서 일반적인 전제 조건으로 고려되고 있다. 따라서 해당 가정이 위배될 경우 잠재계층비율이나 조건부확률과 같은 LCA와 LPA의 주요한 모수 추정치들이 편향될 수 있으며, 이는 잠재계층에 대한 핵심적인 정보인 분포 모수의 편향을 유발한다. 이처럼 가정 위배시 발생하는 분포 모수의 편향은 분석의 정확성을 저해하고, 잠재계층의 의미를 왜곡하며, 나아가 모형의 적합도를 감소시키는 심각한 문제를 발생시킨다. 즉, 지역독립성 가정은 LCA와 LPA의 결과를 올바르게 도출하기 위해 필수적으로 고려되어야 하는 가정이다. 이에, 본 연구는 현재까지 제안된 지역독립성 가정의 위배 여부를 확인하는 다양한 탐지 방법들을 취합하고 분류함으로써 연구상황에 맞는 방법을 결정할 수 있는 정보를 제공하였다.
본 연구에서 소개된 지역독립성 가정 위배 탐지 방법은 크게 통계적 방법과 시각화 방법으로 구분되며, 통계적 방법의 경우 다시 분석에 대표적으로 이용되는 최대우도 추정 및 베이지안 추정에 기반한 방법으로 구분될 수 있다. 이와 같이 지역독립성 가정의 만족 여부를 확인하는 방식은 한 가지로 정해져 있는 것이 아니므로, 연구자는 자신의 연구 상황에 따라 다양한 방법을 활용하는 것이 가능하다. 나아가, 본 연구는 LCA와 LPA에서 여러 탐지 방법들을 통해 지역독립성 가정의 위배가 확인되었을 때 올바르게 모형을 수정할 수 있는 대표적인 모형화 방법들을 최대우도 추정 및 베이지안 추정 기반의 방법으로 구분하여 정리하였다. 이를 통해, 본 연구는 LCA와 LPA를 이용하고자 하는 연구자들이 지역독립성 가정의 위배를 확인할 수 있는 올바른 탐지 방법 뿐 아니라, 이와 같은 가정의 위배 상황에 적용할 수 있는 실질적인 해결 방법을 함께 제공하였다.
본 연구는 LCA와 LPA의 기본적인 전제 조건인 지역독립성 가정의 위배 여부를 확인하는 절차를 연구자들이 필수적으로 따르도록 가정의 중요성에 대한 이해를 높이고 구체적인 탐지 및 모형화 방법에 대한 정보를 제공한다는 소정의 목적을 달성했지만, 몇 가지 제한점이 있다. 먼저, 본 연구에서는 지역독립성 가정에 대한 논의를 진행함에 있어서 모형 내에 공변수가 없고 잠재계층변수와 관찰변수만이 존재하는 상대적으로 간단한 LCA 및 LPA 모형만을 다루었다. 사실, 본 연구에서 다룬 지역독립성 가정 위배 시 탐지 방법들은 공변수가 포함된 모형을 이용하는 경우에도 그대로 적용될 수 있는 것으로 알려져 있다(Vermunt, 2010). 다만 현재 많은 LCA 및 LPA 연구에서는 공변수뿐 아니라 측정모형(FMM; Yung, 1997) 혹은 구조방정식 모형을 포함하거나(SEMM; Dolan & van der Maas, 1998), 시간 변수를 포함하는(LTA; Lanza et al., 2003) 등 다양한 방식으로 확장된 혼합모형(mixture model)이 빈번히 이용되는 추세이다. 이를 고려하면, 후속 연구에서는 위와 같은 다양한 혼합 모형에서의 지역독립성 가정의 위배가 추정에 미치는 영향과 그 탐지 방법의 수행을 확인할 필요가 있다. 다음으로, 본 연구에서는 지역독립성 가정의 위배 상황에 대해 다룰 때, 이분형 변수를 이용하는 LCA와 연속형 변수를 이용하는 LPA의 지역독립성만을 논의하였다. 그러나 실제로 많은 내용영역 연구들에서는 이분형과 연속형 변수가 함께 포함되거나 순서형 또는 다분형 변수를 이용하는 LCA 역시 빈번하게 사용되고 있다(Formann, 1992). 이처럼 다양한 유형의 변수를 동시에 이용하는 LCA에서 지역독립성 가정의 위배 탐지 방법과 이에 적절한 모형화 방법에 대한 추가적인 논의가 필요하다.
이러한 제한점에도 불구하고, 본 연구는 국내에서 심도 있게 다루어진 바 없는 LCA 및 LPA에서의 지역독립성 가정의 의미와 중요성을 종합적으로 논의하였다는 데 의의가 있다. 더불어 본 연구에서는 다양한 지역독립성 가정 위배의 탐지 및 모형화 방법들을 LCA 및 LPA의 맥락에서 체계적으로 분류하고 정리함으로써 연구자가 실질적으로 참고할 수 있는 정보를 제공하였다. 실제로 심리학 및 교육학 분야에서는 문항 간 내용 중복이나 측정 오류로 인해 지역독립성 가정의 위배 상황이 빈번하게 발생될 수 있는데, 이때 연구자는 본 연구에서 제시한 탐지 및 모형화 방법을 적용함으로써 허위 잠재계층 추출 가능성을 사전에 점검하고, 모형 수정을 통한 적합도 개선 전략을 수립할 수 있다. 이러한 과정은 모형의 해석 타당성을 제고하고, 분석 결과의 일반화 가능성을 높이는 데 기여할 수 있다. 본 연구를 통해 많은 연구자들이 LCA 혹은 LPA를 이용하는 상황에서 지역독립성 가정 확인의 중요성을 이해하고, 적절한 탐지 및 모형화 방법을 적용할 수 있게 함으로써 올바른 방식으로 잠재계층을 추출하고 해석하는 데 기여할 것을 기대한다.
1) LCA는 원래 이분형 관찰변수에 대한 분석 방법으로 제안되었으나, 이후 순서형, 혼합형 관찰변수를 포함하는 다양한 유형의 관찰변수로 확장되어 적용되고 있다. 본 연구에서는 이분형 관찰변수를 다루는 LCA만을 논의한다.
2) 본 연구에서 소개된 χ2 독립성 검정의 원리에 기반한 방법들 외에도 최대우도 추정을 이용한 LCA에서 지역독립성 가정의 위배를 확인하는 방법들에는 수정 지수(modification index)를 이용하는 EPC(Expected Parameter Change, Oberski et al., 2013) 방법과 모형 내에 특정 관찰변수 쌍에 대한 직접효과를 추가함으로써 해당 효과가 유의한지 확인하는 Wald 검정 방법(Bakk, 2023) 등이 있으나, 지면의 한계로 인해 본 연구에서는 다루지 않았다.
3) 로그 우도비 검정은 전체 응답 반응 패턴에 대한 총괄 검정(overall test)으로도 사용될 수 있으나, 본 연구에서는 이변량 차원에서 지역독립성 가정의 위배 여부를 탐지하기 위한 방법만을 다룬다.
4) 일반적으로 기대빈도는 앞서 다룬 최대우도 추정에서의 탐지 방법들과 마찬가지로 모든 잠재계층에서의 통합적인 기대빈도를 사용한다(Sepúlveda et al., 2008). 따라서 잔차상관도표는 잠재계층별로 지역독립성 가정의 위배 여부를 구체적으로 파악하기보다는, 전체 모형 차원에서 지역독립성 가정의 위배 가능성을 탐색하기 위한 목적으로 사용된다.
참고문헌
Asparouhov, T., & Muthén, B. (2011). Using Bayesian priors for more flexible latent class analysis. In proceedings of the 2011 joint statistical meeting, Miami Beach, FL, USA. https://www.statmodel.com/download/BayesLCA.pdf
Asparouhov, T., & Muthén, B. (2021). Bayesian analysis of latent variable models using Mplus. Available online at https://www.statmodel.com/download/BayesAdvantages18.pdf
Lazarsfeld, P. F. (1950). The logical and mathematical foundation of latent structure analysis. In S. A. Stouffer, L. Guttman, E. A. Suchman, P. F. Lazarsfeld, S. A. Star, & J. A. Clausen, Studies in social psychology in World War II: Vol. 4. Measurement and prediction (pp. 362-412). Princeton, NJ: Princeton University Press.