구조방정식모형(structural equation modeling, SEM)은 잠재변수 간 관계를 정확하게 추정할 수 있는 방법으로, 심리학을 비롯한 여러 사회과학 분야에서 널리 활용되고 있다. SEM은 복잡한 이론적 모형을 검증하고, 다양한 변수 간의 직접 및 간접적 관계를 동시에 평가할 수 있는 장점을 지니고 있다(김수영, 2016; Bollen, 1989; Kline, 2016; Wang & Wang, 2019; Wang et al., 2022). 그러나 현실적인 제약으로 인해 모형의 추정이 불안정해지면서, 부적절한 결과가 도출되거나 추정이 실패하는 경우가 빈번하게 발생한다. 그 예로서 충분한 크기의 표본을 확보하기 어려운 경우, 변수 간 높은 다중공선성이 존재하는 경우, 연구모형에 대한 배경지식이 부족하여 모형을 잘못 설정하는 경우 등이 있다. 이러한 상황에서는 모형이 안정적으로 추정되지 않으며, 추정이 수렴하더라도 모형의 일반화 가능성과 예측력이 저하될 위험이 크다. 이러한 추정 조건의 결점으로 인해 발생하는 문제를 해결하기 위해 자료나 모형의 결함을 보완하는 방법이 있으나, 다른 한편으로 추정법을 변경하는 방법도 고려할 수 있다. 최근 추정법을 수정하는 방식으로 제안된 정규화 기법(regularization method)은 불완전한 추정 조건에서도 비교적 안정적인 추정을 제공하는 유용한 대안으로 주목받고 있다(김청택, 2019; Bollen et al., 2022; Van Lissa, 2023; Wang et al., 2022; Zhang et al., 2020). 정규화 기법은 회귀분석을 기반으로 연구가 시작되었으며, 추정 과정에서 수축 페널티 항(shrinkage penalty term)을 도입하여 약간의 편향(bias)을 허용하는 대신 추정치의 분산을 줄여 안정적인 결과를 도출하는 방법이다. 이를 SEM에 적용함으로써 자료나 모형 설정의 결함으로 인한 추정 문제를 해결하고 추정의 안정성을 높일 수 있음이 많은 연구에서 입증되었다(Deng et al., 2018; Finch & Miller, 2021; Huang, 2018; Jacobucci et al., 2019; Jung, 2013; Lindstrøm & Dahl, 2020; Marcoulides et al., 2023; Nestler, 2022; Niemelä-Nyrhinen & Leskinen, 2014; Rosseel, 2020; Scharf et al., 2021). 그럼에도 불구하고 기존 연구들은 대체로 구체적인 자료의 한계나 특정 모형의 설정 문제에 집중한 경향이 있어, 정규화 기법이 SEM에서 전반적으로 갖는 이점을 체계적으로 정리하지는 못했다. 이로 인해 대부분의 사회과학 연구자들은 여전히 정규화 기법을 충분히 이해하지 못하며, 이를 적극적으로 활용하지도 못하고 있다. 따라서 본 연구는 이러한 한계를 보완하고자 정규화 기법을 SEM의 추정에 적용하는 방법과 이를 통하여 해결할 수 있는 SEM의 추정 문제 및 작동 원리를 종합적으로 탐색하고 정리하는 것을 목적으로 한다. 이를 통해 향후 SEM 사용자들이 유사한 추정 문제에 직면했을 때 참고할 수 있는 실질적인 해결 방안을 제공하고자 한다.
정규화 기법은 모형이나 자료의 결함으로 인해 추정이 불안정할 때도 합리적인 추정 결과를 도출할 수 있는 통계 기법이다(Bickel et al., 2006). 일반적인 회귀분석에 비해 정규화된 회귀분석(regularized regression)은 더 간명한 모형을 제공하며(functional sparsity), 추정치의 분산을 줄이고(reduction of estimate’s variance), 모형 및 자료의 과적합을 방지하며(avoidance of overfitting), 예측변수의 수에 비해 표본크기가 작아도 분석이 가능하다는 장점을 갖는다(Hastle et al., 2015; Jacobucci et al., 2023; James et al., 2021). Jung(2013) 및 Jacobucci 등(2016)은 이러한 기법의 장점을 SEM에도 활용하기 위해 정규화 개념을 도입하여 정규화된 구조방정식모형(regularized structural equation modeling, RegSEM)을 제안하였다. 전통적인 SEM에 비해 RegSEM은 모형 또는 자료의 결함으로 인한 추정 불안정성을 완화할 수 있는 장점이 있다. 일반적으로 안정적인 SEM 추정을 위해서는 적절한 모형 설정과 신뢰할 수 있는 자료가 필수적이다(Bentler & Chou, 1987; Hau et al., 2004). 예를 들어, 자료 측면에서 충분히 큰 표본크기를 확보하고 변수 간에 높은 다중공선성이 존재하지 않는지 확인하는 것이 중요하다(Weston & Gore, 2006). 또한, SEM은 자료와 모형의 구조를 비교하면서 변수 간의 관계를 추정하는 과정이므로, 연구자가 설정한 모형은 선행 이론을 바탕으로 정확하게 설정되어야 한다. 이와 같은 기본적인 조건이 충족되지 않으면 추정 자체가 불가능하거나, 추정이 불안정해질 수 있다. SEM에서 추정의 불안정이란, 추정치가 자료나 모형의 작은 변동에 민감하게 반응하여 추정할 때마다 다른 값이 도출되며, 이로 인해 결과의 해석이 어렵고 일관성이 저하되는 현상을 의미한다. 일반적으로는 추정 과정에서 수렴에 실패하거나, 수렴하더라도 추정 결과에 매우 큰 표준오차, Heywood case와 같은 부적절한 해가 도출되는 경우, 추정이 불안정한 것으로 판단할 수 있다(김수영, 2016; Boomsma, 1985; Kline, 2016). 이러한 추정 문제를 해결하기 위해 불완전한 추정 조건을 보완하는 방법도 있지만, 현실적으로 조건들을 완벽하게 충족시키기는 어렵다. RegSEM은 추정 방법을 변경하여 자료 또는 모형의 결함으로 인한 추정 문제를 완화할 수 있는 유용한 도구로서, 최근 SEM 연구에서 중요한 위치를 차지하고 있다(Bollen et al., 2022; Brandmaier & Jacobucci, 2023; Van Lissa, 2023).
비록 RegSEM이 안정적인 추정에 기여할 수 있음에도 불구하고, 정규화 기법이 SEM 분야에 비교적 최근 도입되었기 때문에 많은 연구자에게 아직 익숙하지 않으며, 관련 연구들이 충분히 체계화되거나 정리되지 않아 이를 이해하고 적용하는 데 어려움이 있다. 현재까지 진행된 RegSEM 연구들은 주로 정규화 기법이 다양한 추정 방법에 어떻게 적용되는지를 소개하는 연구(Huang et al., 2017; Jacobucci et al., 2016; Nestler, 2022; Yang & Yuan, 2019; Yuan & Chan, 2008, 2016)와 각 추정 방법에 정규화 기법을 적용했을 때의 효용성을 확인하는 시뮬레이션 연구(Jacobucci et al., 2019; Li & Jacobucci, 2022; Orzek et al., 2023; Scharf et al., 2021)로 이루어져 있다. 각 연구를 통해 RegSEM이 특정 문제에 유용한 해결 방법임을 확인할 수 있었지만, 이를 체계적이고 통합적으로 정리한 연구는 찾아보기 어렵다. 베이지안 추정 관점에서 산발적인 RegSEM 연구들을 정리하는 연구는 있었지만(van Erp, 2023), 빈도주의 접근에서 최대우도(maximum likelihood, ML) 추정과 일반화 최소제곱(generalized least squares, GLS) 추정을 모두 포함하여 RegSEM을 종합적으로 다룬 연구는 드물다. 또한, 정규화 기법에는 Lasso나 Ridge 등 다양한 형태가 존재하고 그 활용 범위도 매우 넓은데, 대부분의 RegSEM 연구는 하나의 특정 형태에만 집중하는 경향이 있다. 예를 들어, Yuan과 동료들(Yang & Yuan, 2019; Yuan & Chan, 2008, 2016; Yuan et al., 2011)은 SEM에서 정규화 기법을 적용할 때 주로 Ridge를 중심으로 연구를 진행하였으며, 이를 Ridge SEM으로 명명하였다. 마지막으로, 정규화 기법은 SEM에서 추정의 안정성을 향상시킬 수 있는 해결책으로 제안되어 왔으나, 특정 상황에서 어떤 정규화 형태를 적용할 수 있는지에 대한 가이드라인이 부족하다. 실제 자료를 활용하고 구체적인 RegSEM 분석 과정을 보여주는 예시가 거의 없어, 연구자가 해당 기법을 실용적으로 응용하는 데 참고할 수 있는 자료도 부족하다. 따라서 SEM 사용자들이 정규화 기법의 원리를 명확히 이해하고, 필요시 적절히 활용할 수 있도록, SEM에서 정규화 기법의 적용 방법과 유용성을 체계적으로 정리하고, 응용 과정에 대한 실용적인 가이드라인을 제공하는 연구가 필요하다.
본 연구의 목적은 SEM 사용자들이 정규화 기법에 대한 전반적인 이해를 높이고, 추정 불안정 문제가 발생한 상황에서 이를 정확하게 활용할 수 있도록 돕는 데 있다. 이와 같은 목적을 달성하기 위해, 먼저 회귀분석을 기반으로 정규화 기법을 간단히 소개하고, 대표적인 정규화 형태와 이를 적용할 때의 유의점을 정리한다. 이어서, 빈도주의 추정 방법에 기반한 RegSEM을 정규화된 최대우도 추정(regularized ML)과 정규화된 최소제곱 추정(regularized GLS)으로 구분하여 각각 설명한다. 다음으로, SEM에서 발생할 수 있는 추정 불안정 문제를 잘못된 모형 설정, 작은 표본크기, 변수 간 다중공선성의 세 가지 경우로 나누어, 각 경우에 추정 불안정성을 유발하는 원인과 정규화 기법을 통해 추정을 안정화하는 원리를 논의한다. 마지막으로, 작은 표본크기로 인한 추정 불안정 문제를 예시로, 실제 자료를 활용하여 RegSEM의 분석 방법과 결과 확인 과정을 제공한다.
회귀분석에 기반한 정규화 기법
정규화된 구조방정식모형(RegSEM)은 기존의 SEM 추정 과정에 정규화 기법을 도입하여 구성된 것이다. 따라서 RegSEM을 정확하게 이해하기 위해서는 정규화 기법에 대한 배경지식이 필수적이다. 정규화 기법은 초창기 회귀분석을 바탕으로 발전해 왔으며, 먼저 보통최소제곱(ordinal least square, OLS) 추정을 통해 이를 살펴본다. OLS 추정에서 정규화 기법의 적용은 그림 1에 정리되어 있다.
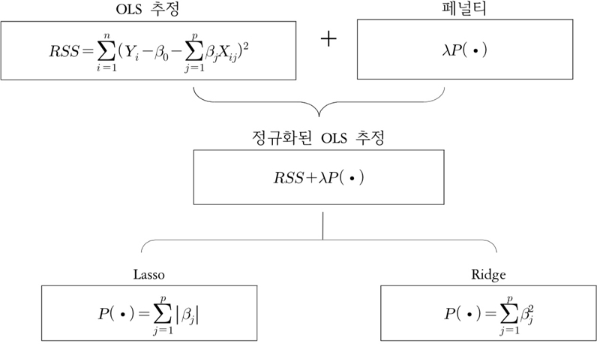
정규화 기법의 핵심적인 원리는 추정 과정에서 수축 페널티 항을 추가하여 추정의 안정성을 높이는 것이다(Bickel et al., 2006). 우선, 회귀분석에서 OLS 방법은 잔차 제곱합(residual sum of squares, RSS)을 최소화하는 회귀 계수를 추정하는데, 이는 일반적으로 다음의 식을 통해 수행된다.
위에서 Yi는 i번째 사례의 종속변수 점수, Xij는 i번째 사례의 i번째 예측변수 점수, β0는 회귀식의 절편 모수, βj는 j번째 예측변수의 기울기 모수를 의미한다. RSS를 최소화할 수 있는 회귀 계수 βj는 행렬의 관점에서 식 2의 계산을 통해 추정할 수 있다.
위에서 은 들로 구성한 추정된 회귀모수 벡터, X는 예측변수들의 값을 포함하는 설계행렬(design matrix), XX'은 공분산 행렬을 가리킨다.
정규화 기법을 적용한 OLS 추정은 기존 OLS 추정에 수축 페널티 항 λP(∙)을 추가하여 다음과 같은 식을 최소화하는 방법이다.
위에서 수축 페널티 항 λP(∙)은 페널티의 강도를 조율하는 모수(tuning parameter) λ와 페널티를 부여하고자 하는 모수 집합 P(∙)으로 구성된다. 조율 모수 λ는 0부터 무한대까지 적용할 수 있으며, λ가 0일 때는 페널티 강도가 0이므로 추정치를 축소하지 않아 식 3은 OLS 추정의 RSS와 동일해진다. λ가 커짐에 따라 페널티 강도가 증가하고, 모수 추정치가 일정 비율로 축소되어 점차 0에 가까워진다(Hastle et al., 2015; James et al, 2021). λ의 값은 연구자에 의해 교차타당화 지수나 AIC, BIC 등의 정보지수(information criterion)를 참고하여 결정할 수 있다(Hastle et al., 2015; Jacobucci et al., 2016; Jacobucci et al., 2023; James et al., 2021, Zhang et al., 2020).
다음으로 P(∙)은 정규화 기법의 형태, 즉 어떤 정규화 기법을 이용하는지를 나타낸다. 정규화 기법의 형태는 대표적으로 모수의 제곱합을 통해 페널티를 부과하는 Ridge(Hoerl & Kennard, 1970)와 모수의 절대값의 합을 통해 페널티를 부과하는 Lasso(least absolute shrinkage and selection operator; Tibshirani, 1996)가 있다. Ridge는 을 사용하여 페널티를 부과하는데, 이는 결국 추정에서 다음의 식을 최소화하게 된다.
위 식을 최소화하는 회귀 계수는 행렬의 관점에서 아래의 계산을 통해 추정할 수 있다.
위에서 I는 단위행렬을 의미한다.
일반적인 OLS는 모수 추정 과정에서 공분산 행렬의 역행렬을 요구하는데, 다양한 이유(예를 들어, 모형의 잘못된 설정, 작은 표본크기 등)로 공분산 행렬이 특이행렬(singular matrix)인 경우에는 역행렬을 계산할 수 없으므로 추정에 문제가 발생한다. Ridge는 공분산 행렬 XX'에 양의 값(λI)을 더함으로써, XX'이 특이행렬일 때도 XX'+λI는 역행렬이 존재하는 비특이행렬(non-singular matrix)이 될 수 있다. 이러한 이유로 Ridge는 높은 다중공선성으로 인한 추정 문제를 해결하는 데 사용될 수 있다.
Ridge는 모수들의 제곱합을 사용하여 페널티를 부과하므로, 모수 추정치를 0에 가깝게 축소할 수 있지만 완전히 0으로 만들 수는 없다(James et al., 2021). 이와 달리, Lasso는 을 이용하여 페널티를 부과하는 방식으로 모수를 축소한 방법이기 때문에, 특정 모수 추정치를 완전히 0으로 축소할 수 있다. Lasso는 아래 식을 최소화하여 모수를 추정한다.
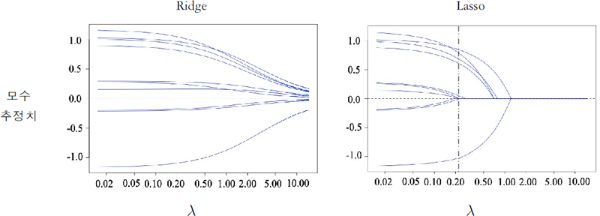
위와 같이 Lasso를 사용할 경우, λ가 증가함에 따라 모수 추정치가 점차적으로 0으로 축소되며, 특히 예측변수의 영향력이 낮을수록 해당 모수 추정치가 더 쉽게 0으로 수렴하는 경향이 있다. 예를 들어, 그림 2에 보이는 것처럼 Ridge를 사용한 경우 λ가 증가하더라도 모수 추정치가 0에 무한 접근할 뿐 완전히 0이 되지는 않는 반면, Lasso를 사용한 경우에는 λ가 대략 0.2일 때 일부 모수 추정치가 0으로 축소되며, λ가 커질수록 더 많은 모수 추정치가 0으로 축소된다. 이는 회귀모형에서 기여도가 낮은 예측변수가 자동으로 제외됨을 의미하며, 결과적으로 모형의 간명성이 향상되는 효과를 가져온다. 이러한 특성으로 인해 Lasso는 다수의 예측변수를 포함하는 경우에도 모형의 과적합을 방지하면서 간명하고 해석 가능한 모형을 탐색하고 구축하는 데 유용한 방법이다.
정규화 기법에서는 Ridge와 Lasso 외에도 다양한 형태가 함께 발전해 왔다. 예를 들어, Elastic net(Enet; Zou & Hastie, 2005)은 Ridge와 Lasso의 장점을 결합한 형태로, 다중공선성의 문제를 해결하면서도 동시에 변수 선택을 수행할 수 있다. Adaptive Lasso(Zou, 2006)는 그 이름처럼 Lasso에 기반하고 있으며, 가중치를 추가하여 각 모수에 서로 다른 강도의 페널티를 부여함으로써 변수 선택의 유연성을 제공한다. 각 정규화 형태가 가지고 있는 기능과 그 원리는 서로 다르기 때문에 연구자가 정규화 기법을 사용할 때 연구 목적에 맞는 적절한 형태를 선택해야 한다. 또한, 정규화 기법을 적용할 때, 연구자는 편향-분산 균형(bias-variance trade-off)을 고려하여 적절한 값을 결정해야 한다(Jacobucci et al., 2016; Jacobucci et al., 2023; James et al., 2021; McNeish, 2015). 어떤 정규화 형태를 사용하더라도 추정치는 편향될 수 있으며, 페널티 강도가 증가할수록 편향이 심화되는 경향이 있다. 추정치가 편향되는 반면, 추정치의 분산은 감소하는 양상을 보인다(Jacobucci et al., 2019). 다시 말해, 추정치 편향의 크기와 분산의 크기를 동시에 작게 만들 수는 없으므로 적절한 수준에서 값을 결정해야 한다는 의미이다.
구조방정식모형에서 정규화 기법의 적용: 빈도주의 추정 방법
구조방정식모형에 적용된 Ridge와 Lasso
최근까지 SEM에서 정규화 기법의 적용은 정규화 형태 및 추정 방법에 따라 다양하게 연구되어 왔다(표 1). Jöreskog(1989)는 구조방정식 프로그램인 LISREL 7에 최초로 Ridge 옵션을 추가하여, SEM에서 다중공선성으로 인한 추정 문제의 해결 가능성을 제시하였다. 이후 Ridge 추정을 활용한 SEM 연구가 활발히 이루어졌으며, Yuan과 Chan(2008)은 SEM에서 특이행렬에 근접한 행렬(near-singular matrix)의 존재로 인한 추정 문제를 Ridge로 해결할 수 있는지를 탐색하였다. Yuan 등(2011)은 이를 상관행렬 기반 SEM에 적용할 가능성을 검토하였고, 더 나아가 순서형 자료(ordinal data)에도 적용 가능한지 확인하였다. 기존 연구들이 대부분 ML에 기반한 Ridge 연구에 집중한 반면, Jung(2013)은 이단계 최소제곱(two-stage least squares, 2SLS) 추정에서 Ridge를 적용하여 작은 표본 문제의 해결 가능성을 탐구하였으며,이러한 모수 추정 방법에 정규화 기법을 결합한 모형을 ‘regularized structural equation models with latent variables(RSEMs)’로 명명하고, 정규화된 구조방정식 모형이라는 개념을 처음으로 제시하였다. 또한, Yuan과 Chan(2016)은 GLS 추정에서 Ridge의 적용을 시도하였으며, Yang과 Yuan(2019)은 Ridge를 이용한 GLS 추정의 최적화 방안을 연구하였다.
표 1.
RegSEM 관련 연구의 특성
| 저자 | 추정 방법 | 변수 유형 | 특징 | 명명 | 정규화 유형 |
|---|---|---|---|---|---|
| Yuan과 Chan (2008) | ML | 연속형 | LISREL에서 제공하는 Ridge 옵션 개선, 조율 모수를 p/N의 값으로 정의 | - | Ridge |
| Yuan 등 (2011) | 연속형 범주형 | 상관행렬로 진행한 Ridge SEM 분석 소개 | Ridge SEM | ||
| Yuan과 Chan (2016) | GLS | 연속형 | GLS 추정에서 Ridge의 적용 방법 소개 | Ridge GLS | |
| Yang과 Yuan (2019) | 연속형 | Ridge GLS의 최적화 연구, 조율 모수의 값을 이단계 계산에 따라 결정하는 방법 제안 | |||
| Jacobucci 등 (2016) | ML | 연속형 | RAM을 통해 정규화된 ML 추정의 원리 설명 R 패키지 regsem 제공 | RegSEM | Lasso Ridge |
| Huang 등 (2017) | LISREL 모형을 통해 정규화된 ML 추정의 원리 설명 R 패키지 lslx 제공 |
penalized likelihood | |||
| Jung (2013) | 2SLS | 연속형 | SEM에서 작은 표본크기로 인한 추정 불안정 문제에 대한 Ridge의 해결 가능성 탐색 | regularized 2SLS | Ridge |
| Nestler (2022) | 정규화된 2SLS 추정의 원리를 원자료 및 요약 자료 접근 방식에 따라 각각 설명 | Lasso Ridge |
|||
| Huang (2022) | 3SLS | 순서형 | 순서형 자료를 사용한 SEM에서 Lasso를 통해 간명한 모형을 구축하는 3SLS 방법 소개 | penalized least squares | Lasso |
Ridge 외에도, SEM에서 Lasso의 적용이 Jacobucci 등(2016)에 의해 소개되었으며, 이를 실행할 수 있는 R 패키지인 regsem도 개발되었다(Jacobucci, 2017; Jacobucci et al., 2023). 한편, Huang 등(2017)은 SEM에서 정규화 기법의 적용을 LISREL 모형을 통해 설명하고 이를 ‘penalized likelihood method for SEM’이라고 명명하였다. 최근 Nestler(2022)는 Ridge와 Lasso를 2SLS 추정에서 적용하는 방법을 원자료 사용 경우와 요약 자료 사용 경우로 나누어 각각 설명하였고, Huang(2022)은 순서형 자료를 사용한 SEM에서 Lasso를 활용하여 삼단계 최소제곱(three-stage least squares, 3SLS) 추정을 통해 간명한 모형을 구축하였다.
SEM에서 정규화 기법의 적용에 관한 다양한 연구가 활발하게 진행되어 있지만, 각 연구에서 이를 서로 다른 방식으로 명명하고 있다. 예를 들어, Jacobucci 등(2016)은 ML 추정을 사용하는 SEM에서 정규화 기법을 적용한 모형을 ‘regularized structural equation modeling’이라고 명명하였고, Huang 등(2017)은 이를 ‘penalized likelihood method for SEM’이라고 명명하였다. 통계적으로 regularization과 penalization이 모두 정규화를 의미하는 용어이므로, 두 연구자가 사실상 동일한 모형을 지칭한다고 볼 수 있다. 한편, Yuan과 Chan(2008) 및 Yuan 등(2011)은 Ridge에 초점을 맞추어 이를 ‘Ridge SEM’이라고 명명하였으며, Jacobucci 등(2016)은 Ridge 페널티를 적용한 RegSEM이 Ridge SEM의 확장임을 언급하였다. 또한, GLS 추정에 Ridge가 적용된 경우, Yuan과 Chan(2016)은 이를 ‘Ridge generalized least squares(Ridge GLS)’로 명명하였다. 이러한 명칭의 혼용은 연구자들에게 혼란을 초래할 수 있으므로, 본 연구에서는 Jacobucci 등(2016)의 명명 방식을 따르기로 하며, 모든 정규화 기법이 적용된 구조방정식모형은 ‘regularized SEM(RegSEM)’으로 통칭하고, 이는 추정 방법에 따라 ‘regularized ML’ 또는 ‘regularized GLS’로 세분화할 수 있음을 제안한다.
정규화된 빈도주의 추정법
Regualrized ML. ML은 대표적인 빈도주의 추정 방법으로 SEM의 추정에 널리 사용되고 있으며(Hoyle, 2000), ML 추정에서 정규화 기법의 적용이 그림 3에 정리되어 있다. ML 추정의 합치함수(fitting function)는 다음과 같이 정의된다.
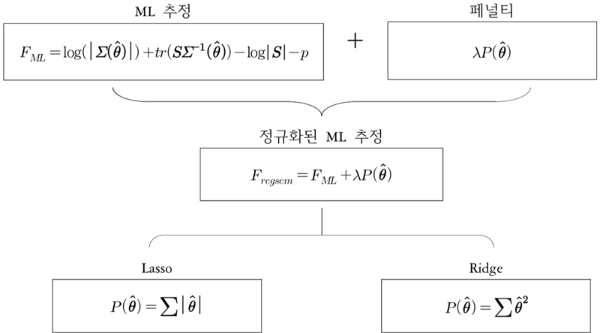
위에서 S는 표본 공분산 행렬, 은 추정치의 집합, 은 추정치에 기반한 모형함의 공분산 행렬을 의미한다. 또한, tr(trace)는 행렬의 대각 요소들의 합을 나타내며, p는 관찰 변수의 개수를 나타낸다. ML 추정의 합치함수는 모형과 자료 간의 적합성을 평가하는 요소로서 사용되며, 이를 최소화하는 모형의 모수가 추정된다.
정규화된 ML 추정(regularized ML)은 기존의 ML 합치함수에 페널티 항을 추가하여 특정 모수에 제약을 부과하는 방식으로 이루어진다(Jacobucci et al., 2016). 따라서 정규화된 ML 추정은 다음과 같이 표현될 수 있다.
식 7과 8을 비교하면, 정규화된 ML 추정의 합치함수(Fregsem)는 기존 ML 추정 방법에 수축 페널티 항 을 추가한 것으로 이해할 수 있다. 연구자의 목적에 따라, Lasso를 적용할 때는 , Ridge를 적용할 때는 을 사용한다.
앞서 설명한 바와 같이, Ridge는 공분산 행렬에 특정한 값을 더하여 추정에 사용되는 공분산 행렬을 비특이행렬로 만드는 방법이다. Jöreskog(1989)는 LISREL 7에 Ridge 옵션을 추가하여 추정의 과정에 표본 공분산 행렬 S 대신 아래처럼 S의 대각 요소에 분산을 더한 행렬 Sa를 사용하는 방법을 제안하였다.
위에서 k1)는 조율 모수이며, sp는 p번째 예측변수의 분산을 의미한다. 이 방법은 행렬의 대각요소에 값을 추가할 때 각 변수의 분산 값을 사용하기 때문에 대각요소마다 추가된 값이 달라서 행렬 자체가 여전히 불안정한 상태이다. 이를 추정에 사용하면 표준오차와 적합도 통계치를 왜곡시킬 가능성이 크므로, McQuitty(1997)는 비표준화 추정치를 얻는 것이 목적이 아니라면, 이 방법의 사용을 추천하지 않았다. 이러한 문제를 해결하기 위해 Yuan과 Chan(2008)은 더 안정적인 Ridge 방법을 제안하였다. 변수의 분산 값 대신, 단위행렬 I를 이용하여 표본 공분산 행렬 S의 대각 요소에 모두 동일한 상수를 더하여 Sa = S + I를 사용하는 방법이다. 여기서 a2)는 조율 모수로서 관찰변수의 수와 표본크기의 비율 p/N에 따라 결정된다. 이를 통해 추정 과정에서 공분산 행렬이 비특이행렬이 되도록 할 수 있으며, ML 추정에서 피셔스코어링(Fisher-scoring) 계산 과정의 속도와 수렴률을 향상시킬 수 있음이 확인되었다(Deng et al., 2018; Yuan & Bentler, 2017).
Regularized GLS. ML 추정 외에도, 최소제곱 추정법에 정규화 기법을 적용할 수 있다. GLS 추정을 기반으로 한 RegSEM은 아직 Lasso와 Ridge를 모두 다루고 있지 않으므로,, 본 연구에서는 Ridge GLS(Yang & Yuan, 2019; Yuan & Chan, 2016)의 예로 정규화된 GLS 추정을 소개한다. 우선, GLS 추정의 합치함수는 다음과 같이 표현된다.
위에서 W는 가중치 행렬, 은 잔차 행렬(residual matrix)을 의미한다. GLS 추정은 가중치를 고려하여 잔차 행렬의 요소 제곱합을 최소화함으로써 모수 추정치를 도출한다.
가중치 행렬 W는 그림 4에 제시된 바와 같이, 고정된 정치 가중치 행렬(fixed positive definite weight matrix)과 자료 기반 가중치 행렬(data-dependent weight matrix)로 구분할 수 있다(Deng et al., 2018). 고정된 정치 가중치 행렬을 사용할 경우, 단위행렬 I가 사용되며, 이를 비가중 최소제곱추정(unweighted least squares, ULS)이라고 한다. ULS는 가중치를 사용하지 않으므로 추정 과정이 매우 안정적이지만, 잔차 행렬의 모든 요소에 동일한 공분산을 가정하기 때문에 오차 변동성을 설명하는 데 한계가 있다. 반면, 자료 기반 가중치 행렬을 사용할 경우, 일반적으로 표본 공분산 행렬 S가 사용되며, 이를 일반화 최소제곱추정(generalized least squares, GLS)이라고 한다. 또한, 자료 기반 가중치 행렬로 표본의 4차 모멘트 행렬(fourth-order moment matrix) Γ를 선택할 수도 있으며, 이 방법은 점근적 분포무관(asymptotically distribution-free, ADF, Browne, 1984) 추정이라고 한다. GLS 추정에서 표본의 정규성에 대한 가정이 필수적이지는 않으나, 비정규성으로 인해 GLS 추정치의 정확성이 저하되는 것이 일반적이다(Huang & Bentler, 2015; Marcoulides et al., 2023). ADF 추정은 GLS의 확장된 방식으로, 표본이 정규성을 만족하지 않는 경우에도 보다 안정적인 추정치를 제공할 수 있는 강건한(robust) 방법이다. 다만, GLS와 ADF 추정 모두 표본크기가 충분히 클 때 좋은 추정 성능을 보이며, 표본크기가 상대적으로 작을 경우 표본 공분산 행렬 S 또는 표본의 4차 모멘트 행렬 Γ가 특이행렬이 되거나 특이행렬에 매우 근접하게 될 가능성이 크다.
그림 4.
최소제곱 추정에서 가중치 행렬의 선택
주. ULS=unweighted least squares; GLS=generalized least squares; ADF=asymptotically distribution-free; Ridge GLSD=WD 를 가중치 행렬로 사용한 Ridge GLS; Ridge GLSI=WI 를 가중치 행렬로 사용한 Ridge GLS.
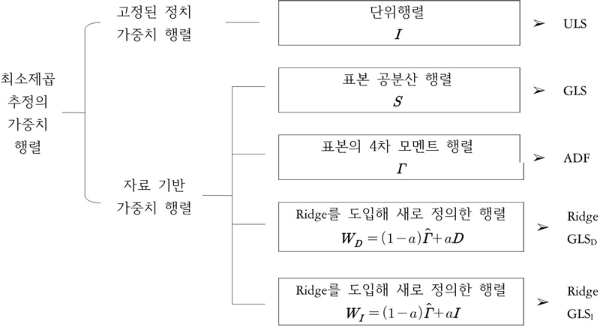
Yuan과 Chan(2016)은 GLS 추정에 Ridge를 도입해 보다 안정적인 추정을 수행할 수 있는 Ridge GLS를 제안하였다. Ridge GLS는 Γ의 대각행렬 D(식 11) 및 단위행렬 I(식 12)를 이용하여 가중치 행렬 W를 새롭게 정의한다.
위에서 a3)는 조율 모수로, 0과 1 사이에서 결정한다. Yuan과 Chan(2016)은 WI를 사용한 Ridge GLSI가 WD를 사용한 Ridge GLSD보다 더 안정적인 추정 결과를 보인다고 보고하였다. 또한, Yang과 Yuan(2019)은 자료의 분포에 따라 적절한 a값을 결정할 것을 권장하며, 두 단계를 거쳐 a값을 계산하는 방법도 제안하였다. 연구 결과에 따르면, 적절한 a값을 사용할 경우 Ridge GLS는 정규 분포 자료에서 일반적인 ML 추정과 비슷한 결과를 보였으며, 특정한 비정규 분포 자료에서는 일반적인 ML 추정 및 ADF 추정보다 더 우수한 성능을 보였다. 특히, ADF 추정이 적용될 수 없는 작은 표본크기의 경우에서도 Ridge GLS는 안정적인 추정 결과를 제공하였다. 이러한 결과는 Ridge GLS가 정규화된 GLS 방법으로서, 표본크기가 작거나 정규성 가정이 위배된 상황에서 보다 강건한 대안이 될 수 있음을 시사한다.
구조방정식모형의 추정 불안정 문제 해결을 위한 정규화 기법의 적용 가능성
구조방정식모형에서 발생 가능한 추정 불안정 문제
SEM의 추정 불안정 문제는 그림 5에 정리된 바와 같이, 보통 특이행렬의 존재로 인해 발생한다(Bentler & Chou, 1987; Hau et al., 2004). ML 또는 GLS 추정을 사용한 SEM 추정 과정에는 공분산 행렬의 역행렬 계산이 포함되므로, 공분산 행렬은 비특이행렬이어야 한다. 만약 특이행렬 형태로 나타날 경우, 역행렬이 계산 가능하지 않으므로 추정은 불가능해진다. 또한, 완전한 특이행렬이 아니어도 이에 근접한 형태(near-singular matrix)인 경우, 이는 수치적으로 매우 불안정한 행렬이다. 행렬이 특이행렬에 근접할 때 역행렬은 존재하지만, 계산이 매우 복잡해지고, 이를 사용할 경우 추정의 불안정성이 증가되며, 결과의 변동성도 매우 높다. ML 추정에서는 수렴에 도달하지 못하거나, 수렴 과정이 길어질 수 있으며, GLS 추정에서는 불안정한 역행렬 계산으로 인해 추정 결과의 신뢰성이 저하될 수 있다.
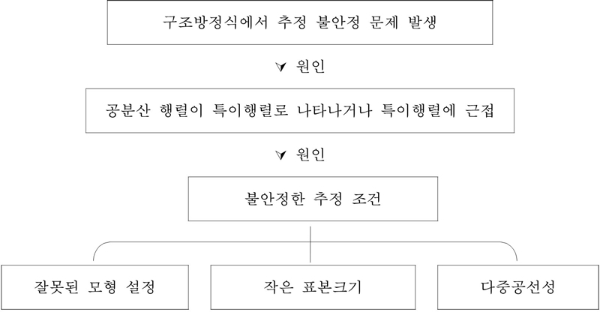
공분산 행렬이 특이행렬이거나 이에 근접한 형태로 보이는 주요 원인은 크게 세 가지로 구분할 수 있다. 첫째, 잘못된 모형 설정(model specification)으로 인해 모형함의 공분산 행렬이 특이행렬로 나타날 수 있다(Hoyle, 2012). SEM 분석의 첫 단계인 모형 설정은 연구자가 기존 문헌과 본인의 이론에 근거하여 변수 간 관계를 정립하는 과정이다. 연구 주제에 대한 배경지식이 충분할수록 연구자는 설정한 모형에 대한 확신을 갖고 분석을 더 안정적으로 진행할 수 있다. 그러나 이론적인 배경이 부족한 경우, 모형 설정에 대한 확신이 떨어질 수 있으며, 이는 모형 설정 오류가 나타날 가능성을 높인다. 모집단의 변수 간 관계를 정확히 반영하지 못하는 모형은 잘못 설정된 모형(misspecified model)으로 간주된다. 예를 들어, 실제 모집단에 존재하는 잠재변수 간 상호작용 또는 교차요인부하가 누락된 경우(underspecification), 일부 변수 간 관계가 충분히 설명되지 않아 모형함의 공분산 행렬 이 특이행렬로 나타날 수 있다. 반대로, 모집단에 존재하지 않는 경로를 과도하게 설정한 경우(overspecification), 설정된 모수들 간의 선형적 종속성으로 인해 동일한 문제가 나타날 가능성이 높다(Finch & Miller, 2021). 심리학 분야에서는 인간의 잠재적 특성 간 복잡한 관계를 연구하기 위해 경로가 많고 복잡한 모형이 자주 사용된다. 진정한 모형(true model)이 복잡할수록 특정 경로를 누락할 가능성이 높아지며, 특히 배경지식이 부족할 때 모형 설정 오류의 발생 가능성이 높아진다.
둘째, 작은 표본크기로 인해 표본 공분산 행렬이 특이행렬로 나타날 수 있다. SEM 분석에서 충분히 큰 표본크기와 다변량 정규성 등의 전제가 충족될 때만 ML 추정법이 추정치의 불편향성(unbiasedness), 일관성(consistency), 효율성(efficiency)을 보장할 수 있다. 일반적으로 표본크기는 최소 100에서 200이 요구되지만(Chou & Bentler, 1995; Hoyle & Kenny, 1999), 모형의 복잡성 또는 사용된 변수의 개수에 따라 달라질 수 있다. 특히 모형에 많은 변수와 모수가 포함될 경우, 표본크기가 200 이상이라 하더라도 상대적으로 작은 것으로 간주될 수 있으며, 이로 인해 표본 공분산 행렬 S가 특이행렬 또는 이에 매우 근접한 형태로 나타날 수 있으므로 불안정한 추정을 초래한다(Deng et al., 2018; Moshagen, 2012; Shi et al., 2018).
셋째, 변수 간의 높은 다중공선성으로 인해 충분한 표본크기에도 불구하고 표본 공분산 행렬이 특이행렬로 나타날 수 있다. 회귀분석에서 다중공선성은 여러 독립변수 간 높은 상관관계를 의미하며, 일부 변수들이 다른 변수들의 선형 결합과 높은 상관을 보이는 경우도 포함한다. 높은 다중공선성은 추정치의 크기와 부호를 왜곡시키며, 신뢰구간을 넓혀 모수의 유의성 검정에 문제를 초래할 수 있다. SEM 분석에서도 변수 간 높은 다중공선성이 존재할 경우, 표본 공분산 행렬이 특이행렬에 근접하게 되어 추정의 정확성이 저해될 수 있다(Wothke, 1993; Yuan & Chan, 2008). 또한, 이러한 다중공선성은 표준오차의 과대추정을 초래할 수 있으며, 반복 추정 시 결과의 일관성이 떨어져 신뢰성을 저하시키는 요인이 된다. 특히 매개모형에 다중공선성이 존재할 경우, 경로계수에 대한 통계적 검정력이 저하될 수 있으며, 변수들 간 간접효과 추정의 정확성과 유의성도 왜곡될 수 있다(Beasley, 2014; Kline, 2015; Thompson et al., 2017). 또한 매개변수가 여러 개인 경우, 각 변수의 설명력이 중복되어 고유한 간접효과를 구분하기 어려워 결과 해석에 난항을 초래할 수 있다(Niemelä-Nyrhinen & Leskinen, 2014). 심각한 다중공선성이 존재할 경우, 표본 공분산 행렬이 특이행렬로 나타나 역행렬 계산이 불가능해지며, 이로 인해 ML 추정과 GLS 추정을 모두 수행할 수 없게 된다.
안정적인 추정을 위한 정규화 기법의 적용 가능성
설명한 것처럼 특이행렬의 존재로 인해 추정 불안정이 발생하는 경우, 정규화 기법은 보다 안정적인 추정을 위한 해결책으로 활용할 수 있다(Neumaier, 1998). 이는 SEM 분석에서 공분산 행렬이 특이행렬로 나타날 경우, 특이행렬을 교정하여 신뢰할 수 있는 추정을 가능하게 한다. 각 추정 문제 해결 시 정규화 기법의 작동 원리와 관련 연구가 표 2에 정리되어 있다.
표 2.
추정 불안정 상황별 정규화 기법의 선택 및 작동 원리
| 불완전한 추정 조건 | 적용 가능한 정규화 형태 | 작동 원리 | 관련 연구 |
|---|---|---|---|
| 잘못된 모형 설정 | Lasso | 변수 선택 기능을 통해 모형에서 영향력이 낮은 경로의 계수를 0으로 축소하여 모형에서 제거함으로써 단순하고 적절한 모형 구축 | Jacobucci 등(2019) Lindstrøm과 Dahl(2020) Finch와 Miller(2021) Nestler(2022) |
| 작은 표본크기 | Lasso | 변수 선택 기능을 통해 작은 표본으로도 안정적인 추정을 가능한 단순한 모형으로 수정 | Deng 등 (2018) Rosseel(2020) Finch와 Miller(2021) |
| Ridge | 모든 변수를 유지한 상태에서 표본 공분산 행렬에 페널티를 부과하여 이를 추정 가능한 비특이행렬로 교정 | Jung(2013) Arruda와Bentler(2017) Deng 등 (2018) Finch와 Miller(2021) Marcoulides 등(2023) |
|
| 다중공선성 | Ridge | 공분산 행렬에 페널티를 부과하여 이를 추정 가능한 비특이행렬로 교정 | Niemelä-Nyrhinen과 Leskinen(2014) Scharf 등(2021) |
잘못된 모형 설정. 모형 설정의 오류가 발생할 경우, 일반적으로 수정 지수(modification indexes, MI)를 활용하여 모형을 수정하고, 수정 전후의 모형을 χ2차이검정으로 비교하여 더 적합한 모형을 확인할 수 있다. 그러나 이때 비교하는 모형들은 서로 내재적 관계를 가져야 한다는 한계가 존재한다. 내재적이지 않은 모형들은 AIC나 BIC와 같은 정보지수를 통해 비교할 수 있으나, 두 정보지수 값이 상반될 경우 통계적 판단이 어렵고, 연구자는 이론적 근거를 재검토해야 하는 한계가 있다. 또한, 모형 설정 오류가 경미할 경우 MI를 통해 비교적 적합한 모형을 찾아낼 수 있으나, 설정 오류가 심각한 경우 MI만으로는 적절한 모형을 찾기 어렵다(Pan et al., 2017). 모형 설정의 오류를 수정하고 평가하는 과정은 이론적 배경이 충분하고 오류가 크지 않다는 전제가 충족되지 않는다면 매우 번거롭고 비효율적일 수 있다.
정규화 기법 중 Lasso는 변수 선택 기능을 통해 모형을 효율적으로 구축할 수 있는 장점을 가지고 있다. Huang 등(2017)은 RegSEM을 확인적 부분(confirmatory part)과 탐색적 부분(exploratory part)을 동시에 포함하는 부분 확인적 접근법(semi-confirmatory approach)으로 규정하였다. 확인적 부분은 선행 이론에 근거한(theory-driven) 구조를 의미하며, 연구자가 보유한 배경지식에 따라 추정할 모수를 설정한다. 반면, 탐색적 부분은 자료에 의존하는(data-driven) 구조로, 정규화 기법을 활용하여 배경지식이 부족한 상황에서도 변수 간 관계를 탐색할 수 있도록 지원한다. RegSEM은 탐색적 구조방정식모형(exploratory SEM, ESEM)과 달리, 모형의 모든 모수를 추정할 필요 없이 연구자의 배경지식 수준에 따라 모수를 고정하거나 추정할 수 있다는 장점이 있다. 이를 통해, RegSEM은 선행 이론이 부족한 상황에서도 복잡한 절차 없이 효율적으로 적절한 모형을 찾아낼 수 있으며, 결국 최종 모형의 일반화 가능성도 높아진다(Huang et al., 2017). Jacobucci 등(2019)은 MIMIC(multiple indicators multiple causes) 모형에서 Lasso를 활용하여 잠재변수에 영향을 미치는 공변수를 정확하게 선택할 가능성을 검토하였다. 연구 결과, Lasso를 이용한 RegSEM은 표본크기가 작은 경우에도 일반적인 ML 추정보다 효과적으로 중요한 공변수를 선택할 수 있었으며, 통계적 검정력이 더 높은 것으로 나타났다. Lindstrøm과 Dahl(2020)은 다집단 구조방정식모형 분석에서 Lasso를 적용하여 집단 간 경로계수 차이를 검정하였다. 연구 결과, Lasso를 적용한 추정은 일반적인 ML 추정보다 집단 간 경로계수 차이를 확인하는 데 더 우수한 성능을 보였다. 특히, 모형이 잘못 설정된 경우, Lasso를 적용한 ML 추정(ML-Lasso)에서도 일정의 편향이 존재하였으나, 일반적인 ML 추정보다 상대적으로 작은 것으로 나타났다. 또한, Finch와 Miller(2021) 및 Nestler(2022)의 연구에 따르면, RegSEM에서 추정치에 일부 편향이 발생할 수 있으나, 이는 정규화 과정에서 특정 계수가 축소되거나 0으로 조정되는 영향으로 인한 것이다. 이러한 편향의 정도는 기본 SEM의 추정 조건이 충족되지 않은 상황에서 일반적인 ML 추정이 초래하는 심각한 편향보다 상대적으로 작은 것으로 보고되었다. 즉, RegSEM을 사용할 경우 일정 수준의 편향이 존재하더라도, 모형이 지나치게 복잡해지거나 불안정한 추정을 초래하는 것을 방지하고 안정적인 추정을 제공하는 장점이 있다.
작은 표본크기. 작은 표본크기로 인해 추정의 불안정성이 나타날 때, Lasso 및 Ridge와 같은 정규화 기법이 이를 해결할 방안으로 제안되었다(Deng et al., 2018). 앞서 소개한 Lasso와 Ridge의 원리에 따라, Lasso는 변수 선택을 통해 모형에서 상대적으로 덜 중요한 변수를 제외함으로써 모형을 단순화하여 작은 표본에서도 안정적인 추정을 가능하게 한다(Rosseel, 2020). 한편, Ridge는 모든 변수를 유지한 상태에서 표본 공분산 행렬에 페널티를 부가하여 안정적인 추정을 가능하게 한다(Marcoulides et al., 2023). Arruda와 Bentler(2017)의 연구에 따르면, Ridge GLS는 작은 표본크기나 비정규 분포 자료에서도 SEM 분석의 적합도와 추정의 안정성을 향상시킬 수 있었다. 또한, Jung (2013)은 Ridge를 적용한 2SLS(Regularized 2SLS)가 작은 표본에서도 일반적인 2SLS 추정보다 더 정확한 추정치를 제공할 수 있음을 밝혔다. Finch와 Miller(2021)는 작은 표본크기에서 정규화된 ML 추정(ML-Lasso, ML-Ridge)과 정규화된 2SLS 추정(2SLS-Lasso, 2SLS-Ridge)을 비교한 결과, 정규화된 ML 또는 2SLS 추정이 일반적인 ML 또는 2SLS 추정보다 편향과 분산이 더 작았으며, 특히 작은 요인부하를 가진 경우에 더 우수한 성능을 나타낸다고 보고하였다. 따라서, Lasso와 Ridge는 모두 작은 표본크기로 인한 추정 문제를 해결하는 데 유용하다. 이들은 문제를 해결하는 원리가 다르므로 연구자는 각 정규화 형태의 원리를 충분히 이해하고 연구 목적에 맞게 정규화 기법을 적용하는 것이 중요하다.
다중공선성. 정규화 기법 중 Ridge는 SEM의 추정에서 다중공선성을 조정할 방안으로 연구되어 왔다. Ridge는 공분산 행렬에 양의 값(positive value)을 추가함으로써, 이를 안정적이고 추정 가능한 비특이행렬로 만든다. 따라서 다중공선성으로 인한 추정의 불안정이 나타날 때, Ridge를 적용하여 특이행렬인 공분산 행렬을 계산 가능한 비특이행렬로 변환할 수 있으며, 이와 같은 이유로 도출된 추정치는 근사치로 간주할 수 있다. Niemelä-Nyrhinen과 Leskinen(2014)은 다중 매개모형에서 매개변수 간 다중공선성을 조정하기 위해 두 가지 방식으로 Ridge를 적용하였다. 연구 결과, 모든 잠재변수를 포함한 공분산 행렬의 대각요소에 값을 더하는 방법(Method A)보다, 결과변수를 제외한 예측변수와 매개변수만 포함하는 공분산 행렬의 대각요소에 값을 더하는 방법(Method B)이 상대적으로 더 작은 표준오차와 높은 통계적 검정력을 나타냈다. 또한, 원래 유의하지 않았던 직접효과가 Method B를 적용했을 때 유의한 결과로 나타났다. Scharf 등(2021)은 Ridge와 Enet을 적용한 RegSEM의 다중공선성 조정 가능성을 시뮬레이션 연구를 통해 확인하였다. 연구 결과, 일반적인 SEM보다 RegSEM은 잠재변수 간에 다중공선성이 존재하는 상황에서 더 안정적인 추정 결과와 높은 통계적 검정력을 보여주었다. 또한, Ridge와 Enet의 성능을 비교한 결과, Enet은 Ridge와 Lasso의 결합체로서 Ridge의 기능을 포함하면서 유사한 추정 결과를 제공하였으며, 제1종 오류도 상대적으로 낮게 나타났다.
실제 자료를 적용한 RegSEM 분석 예시
RegSEM을 활용하여 불완전한 추정 조건에서 안정적인 추정을 진행하는 과정을 작은 표본을 사용한 실제 예제를 통해 설명한다. 이를 위해, 먼저 R 프로그램에서 RegSEM 분석을 실행할 수 있도록 하는 주요 패키지와 핵심 함수들을 간략히 소개한다. 다음으로 예제 분석에 사용된 자료의 특성, 연구모형의 구성, RegSEM 분석 절차를 구체적으로 제공하며, 마지막으로 RegSEM 분석 결과를 확인하고, 이를 ML 추정을 사용한 일반적인 SEM 분석 결과와 비교함으로써 RegSEM의 추정 안정성을 평가한다.
소프트웨어
본 연구의 모든 분석은 R 4.4.2를 사용하여 수행하였다. RegSEM 분석은 regsem 패키지(Jacobucci et al., 2023) 혹은 lslx 패키지(Huang, 2020)를 이용하여 실행할 수 있다. 두 패키지는 R 프로그램에서 정규화 기법이 적용된 구조방정식 분석을 지원하며, regsem 패키지는 lavaan(Rosseel, 2012) 패키지를 기반으로 확장된 도구로, 기존 SEM 분석에 정규화 추정을 적용할 수 있는 기능을 제공하며 cv_regsem() 함수를 통해 실행할 수 있다(Jacobucci, 2017; Li et al., 2021). 이는 Lasso 등 변수 선택 기능이 있는 페널티 함수를 통해 간명한 모형을 탐색할 때, 변수 선택 결과에 따라 재구성된 모형에 대해 최종적으로 lavaan을 사용해 추정하는 추가 단계가 필요하다. 또한, regsem은 경로계수 추정치를 제공하지만, 추정치의 유의성 검정이나 분산과 관련된 결과는 제공하지 않는 한계가 있다. 반면, lslx 패키지는 일반적인 SEM 분석과 RegSEM 분석을 모두 지원하며, 추가적인 패키지 없이 모형 설정부터 분석까지 모든 과정을 하나의 환경에서 완성할 수 있다. lslx는 ML 또는 GLS 추정을 기반으로 한 RegSEM 분석을 지원하며, lslx() 함수를 사용하여 분석을 수행할 수 있다(Huang, 2020). lslx는 regsem에 비해 적용 범위가 넓고 제공되는 옵션이 다양하며, 보다 포괄적인 분석 도구로 활용될 수 있다. 따라서, 본 연구에서는 lslx 패키지를 활용하여 일반적인 SEM 추정과 RegSEM 분석을 수행하고, 두 분석 결과를 비교하였다. lslx에서 ML 추정이 기본(default) 설정이며, 동일 패키지 내에서 GLS 추정을 기반한 RegSEM 분석과 비교할 때 분석 절차상 큰 차이가 없다. 이에 따라 본 예시의 모든 추정 과정은 SEM의 대표적인 추정법인 ML 추정을 기반으로 진행하였다. GLS 추정을 기반으로 RegSEM 분석이 필요한 경우, lslx() 함수의 ‘loss’옵션을 통해 최소제곱 추정법을 지정할 수 있다4).
연구 자료 및 모형과 분석 방법
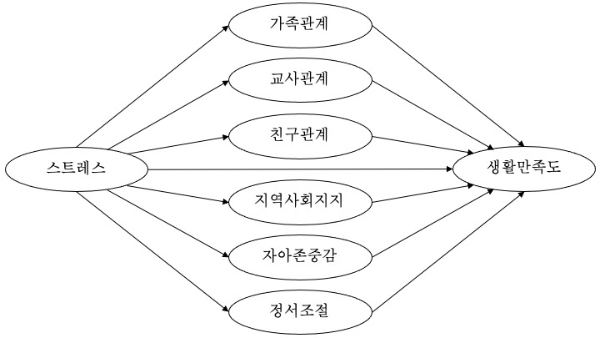
예시 분석에는 한국청소년정책연구원(2013)의 한국 아동․청소년 정신건강 실태조사 제3차 자료가 활용되었다. 총 9,755명 중 결측치를 제거한 후 최종적으로 9,205명의 응답이 분석에 고려되었는데, 분석 예시를 위해 무작위 추출(random sampling) 방법을 이용하여 표본크기가 150과 300인 소표본을 구성하였다. 분석에 사용된 잠재변수는 아동․청소년이 지각한 스트레스, 생활만족도, 가족관계, 교사관계, 친구관계, 지역사회지지, 자아존중감, 정서조절 총 8개였다. 각 잠재변수는 Likert 4점 척도(1=전혀 그렇지 않다, 2=그렇지 않다, 3=그렇다, 4=매우 그렇다) 문항을 사용하여 측정되었다. 자아존중감과 가족관계는 각각 5문항으로 측정하였으며, 교사관계, 친구관계, 정서조절은 각각 3문항으로 측정하였다. 스트레스를 측정하는 12문항은 요인 알고리즘을 활용하여 문항묶음(item parceling)을 통해 4개의 관찰변수로 변환하였다(이지현, 김수영, 2016). 생활만족도를 측정하는 8문항도 문항묶음을 통해 4개의 관찰변수로 변환하였으며, 지역사회지지를 측정하는 6문항은 3개의 관찰변수로 변환하여 분석에 사용하였다.
본 연구에서 사용된 모형은 그림 6에 제시된 바와 같이 설정되어 있다. 이 모형은 아동․청소년이 지각한 스트레스가 생활만족도에 영향을 미치는 과정에서 가족관계, 교사관계, 친구관계, 지역사회지지, 자아존중감, 정서조절의 다중 매개효과를 확인하는 구조를 갖는다(문도원, 신명옥, 이정미, 2017; 박병선, 2015; 신명옥, 장덕희, 2017). 해당 모형에서는 30개의 지표변수를 사용하여 8개의 잠재변수를 측정하였으며, 모형에서 추정하고자 하는 자유모수의 개수는 총 103개였다. 이러한 모형에서, 표본크기가 150 또는 300인 경우는 모형의 복잡성에 비해 상대적으로 꽤 작은 표본으로 간주될 수 있다.
RegSEM 분석의 절차와 불완전한 추정 조건에서 안정적인 추정 결과를 확인하기 위해, 우선 일반적인 SEM 분석을 통해 표본크기가 150과 300일 때 연구모형의 적합도와 추정 결과를 검토하였다. 다음으로, 작은 표본으로 인한 추정 불안정성을 개선하기 위해 Lasso 페널티와 Ridge 페널티를 각각 적용한 RegSEM 분석을 진행하였다. 각 RegSEM 분석의 적합도와 추정 결과를 일반적인 SEM의 추정 결과와 비교함으로써, RegSEM이 추정의 안정성을 개선하는지 확인하였다.
분석 결과
모형 적합도. 표 3에는 일반적인 ML 추정을 사용한 SEM과 Lasso 및 Ridge와 같은 정규화 기법이 적용된 RegSEM의 적합도 지수가 제시되어 있다. 먼저, 기존 SEM 모형의 적합도를 살펴보면, 표본크기가 150일 때 CFI 값이 0.9 미만이며, RMSEA와 SRMR 값이 각각 0.1에 근접하여 전반적으로 모형과 자료 간의 적합도가 양호하지 않은 것으로 나타났다. 표본크기가 300일 경우, CFI는 0.905, RMSEA는 0.076, SRMR은 0.066으로, 표본크기가 150일 때보다 적합도가 다소 개선된 것으로 보였지만, 매우 좋은 수준의 적합도를 보인다고 보기는 어렵다.
표 3.
표본크기에 따라 SEM 및 RegSEM의 적합도 결과와 각 RegSEM에 적용한 λ값
| 표본크기 | 모형 | λ | CFI | RMSEA | SRMR |
|---|---|---|---|---|---|
| 150 | SEM | - | 0.850 | 0.093 | 0.091 |
| RegSEM-Lasso | 0.104 | 0.848 | 0.093 | 0.116 | |
| RegSEM-Ridge | 0.041 | 0.886 | 0.071 | 0.101 | |
| 300 | SEM | - | 0.901 | 0.076 | 0.066 |
| RegSEM-Lasso | 0.065 | 0.900 | 0.076 | 0.078 | |
| RegSEM-Ridge | 0.020 | 0.917 | 0.062 | 0.071 |
다음으로, 정규화 기법이 적용된 RegSEM 모형의 적합도를 살펴보면, Lasso를 적용한 경우 SEM 모형과 비교했을 때 적합도 지수가 큰 폭으로 개선되지는 않은 것으로 나타났다. 이는 Lasso 페널티가 모형과 자료의 적합도를 획기적으로 향상시키는 데에는 한계가 있음을 시사한다. 한편, Ridge를 적용한 경우 SEM 모형보다 CFI 값이 상승되고 RMSEA 값이 감소하는 등 모형 적합도가 전반적으로 개선된 것으로 나타났다. 일반적인 SEM 모형에 비해 SRMR 지수에서는 큰 개선이 관찰되지 않았으나, CFI와 RMSEA 지수의 향상을 통해 Ridge가 작은 표본크기를 사용하는 SEM 분석에서 모형 적합도를 향상시키는 데 기여할 수 있는 가능성을 확인할 수 있었다.
추정치의 안정성. 표 4에는 페널티 없이 일반적인 ML 추정을 사용한 SEM 모형 및 정규화 기법이 적용된 RegSEM 모형의 추정 결과가 제시되어 있다. 먼저, SEM 모형의 추정 결과를 살펴보면, 표본크기와 상관없이 스트레스가 매개변수들에 미치는 영향은 모두 유의한 부적 관계로 나타났으며, 매개변수들이 생활만족도에 미치는 영향은 모두 통계적으로 유의하지 않은 것으로 나타났다. 또한 SEM 모형의 추정 결과 전반적으로 표준오차가 크게 나타났으며, 특히 표본크기가 150일 때 대부분의 추정치에서 표준오차가 0.1 이상이었다. 더욱이, 표본크기가 300일 경우에 스트레스가 정서조절에 미치는 영향이 p < .001 수준에서 유의하였으나, 해당 추정치의 표준오차는 0.2 이상으로 나타나 모수 추정치의 변동성이 크고 신뢰성이 낮을 가능성이 있음을 시사하였다. 즉, 연구모형의 복잡성으로 인해 표본크기가 150 또는 300인 경우에 추정지의 표준오차가 크게 나타나 해당 결과 해석의 신뢰성이 저하될 수 있다.
표 4.
표본크기에 따른 SEM 및 RegSEM의 추정 결과
| 경로 | SEM | RegSEM-Lasso | RegSEM-Ridge | |||||
|---|---|---|---|---|---|---|---|---|
| 비표준화 추정치 | 표준 오차 | 비표준화 추정치 | 표준 오차 | 비표준화 추정치 | 표준 오차 | |||
| N=150 | ||||||||
| 스트레스 | → | 가족관계 | -0.626*** | 0.130 | -0.478*** | 0.093 | -0.536*** | 0.093 |
| 교사관계 | -0.729*** | 0.101 | -0.578*** | 0.079 | -0.637*** | 0.077 | ||
| 친구관계 | -0.476*** | 0.108 | -0.343*** | 0.082 | -0.403*** | 0.081 | ||
| 지역사회지지 | -0.392** | 0.120 | -0.287** | 0.085 | -0.340*** | 0.096 | ||
| 자아존중감 | -0.863*** | 0.173 | -0.655*** | 0.117 | -0.730*** | 0.114 | ||
| 정서조절 | -1.050*** | 0.198 | -0.813*** | 0.135 | -0.892*** | 0.131 | ||
| 스트레스 | → | 생활만족도 | -0.407 | 0.475 | -0.179 | 0.246 | -0.283 | 0.230 |
| 가족관계 | 0.168 | 0.127 | 0.147 | 0.124 | 0.180 | 0.110 | ||
| 교사관계 | -0.076 | 0.112 | - | - | -0.055 | 0.097 | ||
| 친구관계 | -0.178 | 0.134 | - | - | -0.142 | 0.118 | ||
| 지역사회지지 | 0.007 | 0.131 | - | - | 0.015 | 0.115 | ||
| 자아존중감 | 0.135 | 0.134 | 0.142 | 0.132 | 0.157 | 0.119 | ||
| 정서조절 | 0.269 | 0.284 | 0.283 | 0.213 | 0.289 | 0.160 | ||
| N=300 | ||||||||
| 스트레스 | → | 가족관계 | -0.751*** | 0.081 | -0.635*** | 0.058 | -0.685*** | 0.064 |
| 교사관계 | -0.735*** | 0.094 | -0.603*** | 0.071 | -0.665*** | 0.077 | ||
| 친구관계 | -0.520*** | 0.073 | -0.426*** | 0.057 | -0.471*** | 0.062 | ||
| 지역사회지지 | -0.500*** | 0.077 | -0.401*** | 0.062 | -0.451*** | 0.066 | ||
| 자아존중감 | -0.941*** | 0.093 | -0.786*** | 0.065 | -0.853*** | 0.071 | ||
| 정서조절 | -0.941*** | 0.087 | -0.778*** | 0.063 | -0.851*** | 0.067 | ||
| 스트레스 | → | 생활만족도 | -0.988*** | 0.271 | -0.567*** | 0.090 | -0.749*** | 0.176 |
| 가족관계 | 0.007 | 0.082 | 0.052 | 0.066 | 0.046 | 0.069 | ||
| 교사관계 | -0.071 | 0.061 | - | - | -0.047 | 0.056 | ||
| 친구관계 | 0.177 | 0.061 | 0.172** | 0.057 | 0.185** | 0.057 | ||
| 지역사회지지 | -0.007 | 0.067 | - | - | 0.013 | 0.064 | ||
| 자아존중감 | -0.046 | 0.082 | - | - | -0.013 | 0.070 | ||
| 정서조절 | -0.165 | 0.116 | - | - | -0.100 | 0.092 | ||
이러한 문제를 해결하기 위해, 본 연구에서는 Lasso 및 Ridge와 같은 정규화 방법을 사용하여 분석을 진행하였다. 표 4의 결과에 따라, Lasso를 적용할 때 경로계수의 유의성 검정 결과는 SEM 모형과 대체로 유사한 경향을 보였다. 표본크기가 150인 경우, 조율 모수 λ5)값이 0.104일 때 해당 모형이 간결성과 해석 가능성을 고려하여 가장 적절한 모형으로 선택되었다. 이때, 매개변수인 교사관계, 친구관계, 지역사회지지가 생활만족도에 미치는 경로의 계수가 0으로 축소되어 모형에서 제거되었으며, 다른 매개변수들이 생활만족도에 미치는 경로는 유지되었으나 통계적으로 유의하지 않았다. 즉, RegSEM-Lasso를 적용한 결과, 표본크기가 150인 경우 원래 연구모형에서 매개변수인 교사관계, 친구관계, 지역사회지지를 제외하고, 스트레스가 가족관계, 자아존중감, 정서조절을 통하여 생활만족도에 영향을 주는 모형으로 수정할 때, 보다 안정적인 분석 결과를 도출할 수 있음을 확인하였다. 표본크기가 300인 경우, 조율 모수 λ값이 0.065일 때 해당 모형이 간결성과 해석 가능성을 고려하여 가장 적절한 모형으로 선택되었다. 이때, 대부분의 매개변수가 생활만족도에 미치는 경로의 계수가 0으로 축소되어 모형에서 제거되었으며, 가족관계가 생활만족도에 영향을 미치는 경로는 유지되었으나 통계적으로 유의하지 않았다. 그러나 기존 SEM 모형에서는 유의하지 않았던 친구관계가 생활만족도에 미치는 영향이 p < .01 수준에서 유의하게 나타났다. 따라서, 표본크기가 300인 경우에 RegSEM-Lasso를 적용하면 원래 연구모형에서 매개변수인 교사관계, 지역사회지지, 자아존중감, 정서조절을 제외하고, 스트레스가 친구관계 및 가족관계를 통하여 생활만족도에 영향을 미치는 모형으로 수정할 때, 보다 안정적인 분석 결과를 얻을 수 있음을 확인하였다. 또한, SEM 모형과 비교했을 때 전반적으로 표준오차가 감소한 것으로 확인되었다. 이는 SEM 모형이 모든 모수를 추정하면서 불필요한 경로까지 포함하여 모형이 복잡했기 때문이다. 반면, Lasso를 적용하면 연구자가 선택한 λ 기준에 따라 결과변수에 대한 영향력이 낮은 일부 변수의 경로계수가 0으로 축소되고, 해당 경로는 모형에서 과대 설정된 불필요한 것으로 간주되어 제거될 수 있다. 이 과정에서 모형이 단순해지고 자유도도 증가하고, 모형 추정의 안정성이 향상되는 효과가 나타났다.
한편, Ridge를 적용한 결과, 표본크기가 150인 경우 조율 모수 λ값이 0.041일 때 해당 모형이 가장 적절한 모형으로 선택되었으며, 표본크기가 300인 경우에는 조율 모수 λ값이 0.020일 때 최적 모형으로 선정되었다. 경로계수의 유의성 검정 결과는 전반적으로 기존 SEM 모형과 유사하게 나타났다. 표본크기가 300일 때 친구관계가 생활만족도에 미치는 영향이 p < .01 수준에서 유의하게 나타났으며, 표준오차의 크기는 여전히 큰 편이었지만, SEM 모형에 비해 감소한 것으로 확인되었다. 이는 연구모형의 복잡성과 표본크기의 한계로 인해 Ridge를 적용하더라도 표준오차를 낮추는 데 한계가 있을 수 있음을 의미한다. 그럼에도 불구하고, 동일한 모형 및 자료 조건 하에서 Ridge를 적용한 RegSEM은 기존 SEM 모형보다 전반적으로 더 작은 표준오차를 나타냈으며, 이는 Ridge가 보다 안정적인 추정 결과를 제공할 수 있음을 보여준다.
마지막으로, Lasso 및 Ridge 정규화 기법이 적용된 RegSEM 결과를 종합적으로 검토해 보면, 기존 SEM 모형에서 유의하지 않았던 친구관계가 생활만족도에 미치는 경로가 RegSEM 분석에서는 유의한 것으로 나타났다. 이는 스트레스와 생활만족도 간의 관계에서 친구관계가 매개 역할을 할 가능성이 높으며, SEM 모형에서 이를 확인하지 못한 이유는 모형의 복잡성과 작은 표본크기로 인한 제한 때문일 수 있음을 시사한다.
결론 및 논의
최근 구조방정식 분야에서 Lasso 및 Ridge와 같은 정규화 기법에 대한 관심이 증가하고 관련 연구도 점차 늘어나고 있다. 이는 불안정한 추정 상황에서 정규화 기법이 강건한 대안으로 활용될 수 있다는 장점을 가지고 있기 때문이다. 심리학을 비롯한 사회과학 분야에서는 정규화 회귀분석이 일부 활용되고 있음에도, SEM에서 정규화 기법을 적용한 연구는 여전히 제한적이다. 이는 대부분의 연구자들이 정규화 기법의 개념을 충분히 이해하지 못하거나, SEM에서 이를 적용하는 구체적인 절차와 적절한 활용 방안에 익숙하지 않기 때문이다. 따라서, 본 연구는 SEM에서 발생할 수 있는 다양한 추정 불안정 상황에서 정규화 기법이 대안적 접근법으로 사용할 가능성을 탐색하였고, 연구자들이 정규화 기법을 실질적으로 활용하는 데 도움이 될 수 있도록 가이드라인을 제시하였다.
정규화 기법이 적용된 구조방정식모형, 즉 RegSEM은 정규화 회귀분석을 바탕으로 확장된 방법이다. 본 연구에서는 회귀분석을 통하여 정규화의 개념을 포괄적으로 설명하였고, 이를 SEM 분야로 확장하는 과정을 정리하였다. SEM 분석에서 특정한 추정 불안정 상황에 따라 적절한 정규화 형태를 선택하고 추정에 적용하는 과정이 RegSEM 활용의 핵심적인 문제이며, 연구자가 신중하게 고려해야 할 사항이다. 이에 본 연구에서는 RegSEM의 이해를 돕기 위해 추정 방법에 따른 정규화 기법의 적용과 SEM의 불안정한 추정을 완화하기 위한 정규화 기법의 활용이라는 두 가지 측면에서 RegSEM을 소개하였다. 추정 방법과 관련하여서는 정규화된 빈도주의 추정법인 정규화된 ML 추정과 정규화된 GLS 추정을 살펴보았다. 또한, SEM에서 발생 가능한 추정 불안정 문제를 정리하며, 이를 완화하기 위한 정규화 기법의 적용 방안으로 모형이 잘못 설정된 경우 Lasso를, 변수 간 다중공선성이 높은 경우 Ridge를, 표본크기가 작은 경우 Lasso 또는 Ridge를 적용하여 문제를 해결할 수 있음을 제안하였다. 나아가, 실제 자료를 활용하여 작은 표본크기에서 Lasso 및 Ridge를 적용한 RegSEM 분석 사례를 제시하였다. 이를 통해, R 프로그램에서 RegSEM을 수행할 수 있는 패키지를 간략히 소개하고, RegSEM의 실제 분석 과정을 구체적으로 설명하였다. 또한, 일반적인 ML 추정을 사용한 SEM 추정 결과와 비교하여 RegSEM이 추정의 안정성을 향상시킬 수 있음을 확인하였다.
본 연구는 RegSEM에 대해 전반적인 지식을 정리하고, 이를 SEM의 추정 조건이 충족되지 못한 상황에서 적용할 수 있는 대안적 접근법으로 소개하는 목적을 달성하였지만, 여전히 몇 가지 제한점이 있다. 첫째, 본 연구는 빈도주의 추정법의 맥락에서 대표적인 정규화 기법인 Lasso와 Ridge에 초점을 맞추어 논의하였다. 베이지안 추정법을 바탕으로 정규화 기법에 대한 논의를 진행한 RegSEM 관련 연구로는 Jacobucci와 Grimm(2018), Pan 등(2017), van Erp(2023), Zhang과 Liang(2024)의 연구를 참고할 수 있다. 최소제곱 추정의 경우, 본 연구에서는 GLS 추정만 예시로 들어 Regularized GLS를 소개하였으며, 2SLS 추정과 정규화 기법의 결합인 Regularized 2SLS는 Jung(2013), Finch와 Miller(2021), Nestler(2022)의 연구를 참고할 수 있다. 또한, 본 연구에서 언급하였듯이 정규화 기법은 Lasso와 Ridge를 기반으로 확장하고 발전된 다양한 형태가 존재한다. 이와 같은 발전된 정규화 형태는 Lasso 혹은 Ridge의 단점을 보완하여 더욱 안정적인 추정을 제공하거나, 두 방법의 장점을 결합하여 보다 효율적인 추정을 가능하게 한다. 다만, 이처럼 발전된 정규화 형태들은 Lasso나 Ridge보다 계산 과정이 복잡하며, SEM 분석에서 적용 및 응용하는 데 추가적인 어려움이 따를 수 있다. 둘째, 본 연구에서는 작은 표본크기로 인한 추정 불안정 문제만 RegSEM의 적용 사례로서 제시하였다. 그러나 추정의 불안정성이 발생하는 다양한 상황에서도 Lasso와 Ridge의 적용 원리 및 분석 과정은 근본적으로 동일하다. 따라서 본 연구에서는 모든 추정 불안정 상황을 개별적으로 다루기보다, Lasso와 Ridge가 모두 적용 가능한 대표적인 사례로 작은 표본크기 문제를 선정하여 RegSEM 분석 과정을 제시하였다. 셋째, 본 연구에서 제안한 정규화 기법의 선택이 절대적인 것이 아니라는 점을 유의해야 한다. 다양한 선행 연구를 종합적으로 고려했을 때, 특정한 정규화 기법이 특정한 문제 해결에 더 적합할 가능성이 있지만, 다른 정규화 기법이 적용되지 못하는 것이 아니다. 이를 고려하면, 후속 연구에서는 본 연구에서 제안한 해결 방안 외에도, 동일한 추정 문제를 해결하기 위한 대체 정규화 형태의 가능성을 탐색하는 연구가 필요할 것이다.
이러한 제한점에도 불구하고, 본 연구는 현재 SEM 분야에서 상대적으로 새로운 접근법인 정규화 기법에 대한 전반적인 이해를 높이고, 이를 활용하여 SEM의 추정 안정성을 향상시키는 방안을 논의하였다는 점에서 의의가 있다. 더불어, 다양한 추정 불안정 상황에 따른 정규화 기법의 적용 가이드를 정리함으로써 연구자들이 실질적으로 참고할 수 있는 정보를 제공하였다. 이를 통해, 연구자들이 RegSEM 분석을 수행할 때 적절한 정규화 형태를 선택하고 정확하게 적용하여, 보다 안정적이고 신뢰성 높은 분석이 이루어질 수 있기를 기대한다.
각주
1) Jöreskog(1989)의 LISREL 7에는 조율 모수가 k로 표기되어 있으며, 앞서 소개한 조율 모수 λ와 같은 의미를 지니고 있다. LISREL 7에서 k의 디폴트 값은 0.01로 설정되어 있으며, 공분산 행렬이 비특이행렬로 될 때까지 10배씩 증가한다(McQuitty, 1997).
2) Yuan과 Chan(2008) 및 Yuan 등(2011)의 논문에는 조율 모수가 a로 표기되어 있으며, 앞서 소개한 조율 모수 λ와 같은 의미를 지니고 있다. 정규화된 ML 추정에서 a값이 p/N에 따라 결정된다.
3) Yuan과 Chan(2016) 및 Yang과 Yuan(2019)의 논문에는 조율 모수가 a로 표기되어 있으며, 앞서 소개한 조율 모수 λ와 같은 의미를 지니고 있다. 정규화된 GLS 추정에서 a값은 0과 1 사이에서 결정되거나, 이단계 계산법에 따라 결정될 수 있다.
4) lslx를 사용 시 lslx() 함수의 ‘loss’옵션을 통해 기존 추정 방법을 지정할 수 있으며, 지원되는 추정 방법은 ‘ml’, ‘uls’, ‘dwls’, ‘wls’의 네 가지가 있다. 이 중 ML 추정은 사용된 모든 변수가 연속형일 때에만 적절하며, 자료에 순서형 변수가 포함된 경우에는 DWLS(diagonal weighted least squares) 추정을 사용하는 것이 권장된다(Huang, 2020).
5) 본 연구에서는 Jacobucci 등(2016)의 연구와 정규화 기법을 다룬 교과서들(Jacobucci et al., 2023; James et al., 2021)에 따라 조율 모수를 λ로 표기한다.
참고문헌
Jacobucci, R., Grimm, K. J., Brandmaier, A. M., Serang, S., Kievit, R. A., Scharf, F., Li, X., & Ye, A. (2023). regsem: Regularized structural equation modeling. Retrieved from https://CRAN.R-project.org/package=regsem.