같은 대상을 반복 측정하여 시간에 따른 변화와 관계의 양상을 탐색하는 종단 연구는 행동과학에서 매우 중요한 연구방법이다. 종단 연구에서 수집된 자료의 분석에는 다층모형, 일반화추정방정식, 생존분석, 시계열분석 등 다양한 절차가 활용되는데, 이 중 심리학 분야에서 가장 널리 사용되는 절차의 하나로 구조방정식모형(Structural Equation Modeling, SEM)을 들 수 있다. 구조방정식모형은 측정모형과 구조모형의 결합을 통해 종단 자료에 내재된 여러 변수 사이의 복잡한 관계를 측정오차를 통제한 상태에서 분석할 수 있게 한다.
전형적인 종단 SEM에서는 여러 개의 측정지표가 하나의 공통요인을 반영하는 단일 차원의 측정모형이 사용된다. 그러나 측정모형이 다차원 구조를 가지면 종단 분석의 복잡성이 크게 증가한다. 다차원 구조의 측정모형에서는 측정지표들이 복수의 공통요인과 맺는 시점 내 관계와 시점 간 관계가 모두 정의되어야 한다. 또한 지표-요인 사이의 측정적 속성이 시점에 따라 일관적으로 유지되는지도 다차원에서 검토되어야 한다. 예를 들어 다양한 개별 정서 경험에 대한 응답을 결정하는 공통요인을 긍정정서와 부정정서의 이차원 구조로 정의한다고 가정해 보자. 복수의 시점에서 측정된 정서 경험 응답의 측정모형을 설정할 때, 연구자는 개별 문항의 응답이 각 시점에서 긍정정서와 부정정서를 각각 어떻게 반영하는지, 서로 다른 시점 간에는 관련되는지, 이차원 측정모형의 종단적 동일성은 어느 정도인지를 모두 탐색하고 결정해야 한다.
일반적으로 다차원 요인구조의 분석에는 각 측정지표가 오직 하나의 공통요인과 연결되고 나머지 공통요인과는 직접 관련되지 않도록 강제되는 독립군집모형 확인적 요인분석(Independent Cluster Model - Confirmatory Factor Analysis, ICM-CFA)이 사용된다. 그러나 ICM-CFA에서 가정하는 단순구조는 실제 자료의 특성과 부합하지 않는 과도한 제약일 때가 많다. 특히 정서와 같이 복합적인 대상의 측정이 다차원적 중첩을 포함할 경우, 개별 지표가 주요인 외의 요인과 가지는 추가적 관련성은 대상의 본질적 속성일 수 있다(Alamer & Marsh, 2022). 이러한 경우 단순구조를 위한 ICM-CFA의 엄격한 제약은 자료에 대한 적합도를 낮추고 모수 추정에도 심각한 편향(bias)을 초래할 수 있다(Asparouhov & Muthén, 2009; Marsh et al., 2014).
ICM-CFA 제약의 단점은 종단 모형의 설정, 특히 시점 간 측정동일성 제약과 결합할 때 더 두드러진다. 즉, ICM-CFA에 종단 측정동일성 제약이 추가되면 모형 적합도가 적절한 수준에 도달하기가 더욱 어려워진다. 따라서 종단 다차원 요인구조를 분석할 때는 교차부하량을 체계적으로 추정하여 단순구조 가정을 완화하는, 원칙적이면서도 유연한 접근 방식이 요구된다. 이를 위한 방법의 하나로 탐색적 구조방정식모형(Exploratory SEM, ESEM)을 적용할 수 있다(Asparouhov & Muthén, 2009).
ESEM은 탐색적 요인분석(EFA)의 장점(모수 추정에서의 유연성)과 확인적 요인분석(CFA)의 장점(모형 설정에서의 유연성)을 결합하여, 다수의 교차부하를 포함하는 복잡한 요인모형에 대해 요인부하량과 요인 간 상관 및 구조 경로를 더 정확하게 추정할 수 있다. 특히 목표회전(target rotation)을 이용해 특정 요인부하량이 0에 가까운 값을 산출하도록 유도하면 자료 주도적 EFA 모형이 가지는 표본 특수성을 최소화하면서도 유연한 다차원 구조를 탐색할 수 있다. 또한 CFA에서 사용되는 동일성 제약이나 잔차 공분산 설정 등을 활용하여 모형의 간명성과 유연성을 균형 있게 확보할 수 있다.
Asparouhov와 Muthén(2024, 2025)은 종단 다차원 요인모형을 유연하게 설정할 수 있는 또 다른 방법으로 벌점 구조방정식모형(Penalized SEM, PSEM)을 제안하였다. PSEM은 우도 함수에 벌점 제약을 결합하여 모형의 일부 모수를 0에 가깝게 수축시킴으로써 표준적인 SEM 추정법으로는 식별할 수 없는 복잡한 모형을 식별한다. 특히 벌점 부여의 방식과 대상을 조정할 수 있어 목적에 맞게 다양한 변용이 가능하다. 예를 들어 다차원 요인모형에서 교차부하량에만 벌점을 부여하면 ESEM의 목표회전과 유사한 기능을 수행한다. 이와 동시에 동일성 제약과 같이 SEM에서 사용되는 대부분의 설정도 그대로 적용할 수 있다.
본 연구는 종단 다차원 요인모형에 대한 유연한 분석 절차로서 ESEM과 PSEM 적용의 유용성을 검토하고 실제 연구에 참고할 수 있는 분석 사례를 제시하였다. 구체적으로는 먼저 ESEM의 목표회전과 측정동일성 제약의 결합을 통해, 교차부하량을 허용하면서도 구조적 일관성을 갖는 현실적인 요인구조의 도출 절차를 탐색하였다. 이어서 PSEM의 벌점 제약을 통해 ESEM의 목표회전과 유사한 요인구조를 얻으면서도 측정동일성 설정에서는 더 유연한 모형 설정의 가능성을 검토하였다. 마지막으로 실제 자료의 분석을 통해 두 절차의 유사점과 차이점을 확인하고, 다차원 요인구조의 종단 분석을 위한 도구로서의 적절성을 평가하였다. 이를 통해 연구자들이 자신의 연구에서 다차원 척도의 종단 자료를 분석할 때 ESEM과 PSEM을 적절히 활용할 수 있는 실용적 지침을 제공하고자 하였다.
종단 다차원 요인분석의 모형 설정
다차원 요인분석은 복수의 잠재 요인에 대해 각 요인이 개별 측정변수에 미치는 영향을 측정모형으로 명시한다(McArdle & Nesselroade, 2014). 확인적 요인분석에서는 보통 하나의 측정변수가 하나의 요인에만 부하되는 단순구조를 가정하는 독립 군집 설정을 사용하는데 종단 자료에 대한 요인모형에서는 두 가지 사항이 추가로 고려된다. 첫째는 종단 측정동일성이다. 예를 들어 두 시점에서 측정된 요인의 상관계수를 추정하기 위해서는 측정모형의 구조(형태)와 요인부하량(측정단위)에 대한 시점 간 동일성이 전제된다(Putnick & Bornstein, 2016; Liu et al., 2017). 둘째는 잔차 공분산이다. 종단 CFA에서는 다른 시점에 측정된 동일 문항 간에는 잔차 공분산을 허용하고, 다른 문항 간에는 잔차 공분산을 설정하지 않는 것이 표준이다(Little et al., 2007). 이는 각 문항의 고유한 측정 특성이 시간에 걸쳐 일관되게 유지된다는 가정을 반영한 것이다.
그러나 이 두 가지 표준적 설정이 ICM-CFA의 단순구조 가정과 결합하면 실제 자료에 대해 적절한 수준의 모형 적합도를 얻기가 어렵고 모수 추정에 체계적인 편향을 초래할 위험이 있다(Guo et al., 2019). Konold 등 (2025)은 시뮬레이션을 통해 다집단 분석에서 단순구조 제약이 교차부하와 잠재변수 간 상관을 체계적으로 왜곡시킬 수 있음을 보였다. 또한 종단 연구에서 측정모형의 오설정(misspecification)은 측정 오차와 실제 변화를 구별하는 능력을 약화시켜 변화 탐지에 요구되는 통계적 검정력을 현저히 떨어뜨린다(Kwok et al., 2007). 구조방정식모형에서 구조모형의 타당성은 측정모형의 올바른 설정에 의존한다는 점을 고려하면, 측정모형의 오설정이 전체 모형에 대한 추론의 타당성을 위협하는 것은 당연하다(Cole & Maxwell, 2003; Jarvis et al., 2003). 따라서 종단 다차원 요인분석에서 SEM의 확장성을 유지하면서도 데이터의 복잡성을 적절히 반영하기 위해서는 단순구조 제약을 풀어 측정모형에 유연성을 부여할 필요가 있다. 측정모형의 오설정에는 잔차 공분산의 누락, 요인 수의 오설정 등도 포함되지만 단순구조 제약과 관련한 대표적인 오설정은 교차부하의 누락이다.
탐색적 구조방정식모형(ESEM)
Asparouhov와 Muthén(2009)이 제안한 ESEM은 측정모형에 대한 EFA의 유연성과 SEM의 확장된 분석 체계를 유기적으로 통합한 방법이다. ESEM의 가장 큰 특징은 구조모형에 복잡한 요인구조를 반영하는 측정모형을 결합한다는 점이다. ESEM의 측정모형은 EFA에서처럼 모든 지표의 모든 요인에 대한 요인부하를 허용하면서도, CFA에서 설정할 수 있는 잔차 공분산이나 측정동일성 제약 등을 적용함으로써 요인구조를 유연하게 다룰 수 있다(Marsh et al., 2009).
ESEM은 구조모형의 일부를 구성하는 측정모형에서 하나의 지표가 오직 하나의 요인만을 반영한다는 가정이 비현실적일 때 지표에서 가용한 모든 정보를 사용함으로써 요인 관련 모수를 더 정확하게 추정할 수 있다(Mai et al., 2018). 이러한 장점으로 ESEM은 요인구조의 탐색뿐 아니라, 이론 검증을 위한 확인적 분석에도 널리 활용된다(Marsh et al., 2014). 종단 연구에 ESEM을 적용하면 현실적인 요인구조를 반영하면서 측정동일성 제약을 부과할 수 있기 때문에 ICM-CFA 모형보다 측정동일성 가정을 더 잘 충족시킬 수 있다(Swami et al., 2023).
EFA나 ESEM에서 추정된 요인의 해석 가능성을 높이기 위해서는 적절한 회전이 필요하다(Osborne, 2015). 회전 방법이 달라지면 요인부하량과 요인 상관은 달라지지만, 요인들이 설명하는 설명분산의 총합은 변하지 않는다. 즉, 모형 적합도의 관점에서 모두 동일한 모형으로 간주된다. 따라서 회전 방법은 요인 해석의 측면에서 이론적 맥락이나 연구 목적에 따라 선택할 수 있다. ESEM에서는 지오민(Geomin) 회전과 목표회전이 주로 사용된다. 지오민은 요인구조에 대한 사전정보가 없거나 탐색이 필요한 상황에서 사용하는 기계적 회전 방식으로, 가능한 한 많은 부하량을 0에 가깝게 만들어 단순구조에 근접한 해를 도출하도록 설계되었다(Marsh et al., 2009).
이에 반해 목표회전은 이론적 가정을 회전 과정에 통합하는 준이론적 접근이다(Morin et al., 2020). 전형적인 목표회전에서는 특정 요인부하의 목표값을 0으로 설정한 후 회전을 수행한다. 이때 목표값 0은 엄격한 제약이 아니라 회전의 방향을 안내하는 기준으로 작용하며, 주로 이론적으로 약하거나 존재하지 않으리라고 예상되는 교차부하에 적용된다. 목표회전을 통해 연구자는 이론적 구조를 반영하면서도 자료의 복잡성을 수용할 수 있으며, 이는 탐색적 방법과 확인적 방법의 효과적인 절충으로 평가된다(임경민, 김수영, 2019).
ESEM의 유용성은 다수의 실증 및 시뮬레이션 연구를 통해 일관되게 확인된다(Marsh et al., 2020; Morin et al., 2020; Swami et al., 2023; Marsh & Alamer, 2024). 특히 Asparouhov 등 (2015)의 시뮬레이션 연구에서 교차부하량을 0으로 고정한 CFA는 수정지수를 반복하여 적용해도 요인구조를 복구하는 데 실패했지만, ESEM은 초기 분석 단계에서 실제 요인구조를 정확히 복구할 수 있었다. 이러한 결과는 ESEM이 측정 도구의 복잡한 구조를 효과적으로 모형화할 수 있음을 보여준다. 최근 보고된 메타분석 연구에서도 다차원 구성개념 측정에서 ESEM이 일관되게 우수한 성능을 보인다는 점이 확인되었다(Gegenfurtner, 2022).
ESEM에서는 CFA에서 가능한 모형 수정을 EFA 요인구조에 적용할 수도 있다. 예를 들어 지표변수 간에 잔차 공분산을 설정할 수 있고, 전체 요인부하량이나 절편에 동일성 제약을 부여할 수도 있다. 종단 다차원 요인모형에서는 다른 시점에 측정된 동일 문항들 사이에 시점 간 잔차 공분산을 허용하거나 종단 측정동일성 제약을 부여할 수 있다. 이러한 설정은 종단 자료의 특성을 적절히 반영할 수 있도록 모형에 유연성과 간명성을 동시에 제공한다. 특히 목표회전과 잔차 공분산 설정, 측정동일성 제약을 결합하면 종단 다차원 요인구조 분석에서 EFA와 CFA가 가지는 단점을 줄이고 장점을 살리는 분석이 가능하다.
벌점 구조방정식모형(PSEM)
PSEM도 ESEM과 마찬가지로 더 복잡한 측정모형을 모델링할 수 있도록 SEM에 유연성을 제공한다(Asparouhov & Muthén, 2024). 벌점(penalty)을 이용한 SEM의 추정은 정칙화 구조방정식모형(Regularized SEM, RegSEM)이라는 이름으로 Jacobucci 등(2016)에 의해 먼저 제안되었다.
정칙화(regularization)란 통계 모형의 미식별이나 과적합을 방지하고 모수 추정의 안정성을 높이기 위해 추정 과정에 인위적인 제약을 부여하는 기법을 지칭한다. 정칙화는 전형적으로 일부 모수에 벌점을 부여하여 추정치를 0에 가깝게 수축시킴으로써, 약간의 편향을 감수하더라도 추정 결과의 안정성을 높인다. 벌점의 크기(가중치)는 자료 적합도와 모형의 간명성 사이의 균형을 결정하는데 최적 가중치의 선택에는 AIC, BIC 등의 정보 기준이 사용된다. RegSEM은 이러한 정칙화 기법을 잠재변수 모형에 적용한 것이다.
Asparouhov와 Muthén(2024)은 모형 식별의 도구로서 벌점 추정에 주목하고, 미식별 상태인 SEM 모형을 식별할 수 있도록 하는 절차로서 PSEM을 제안하였다. RegSEM과 PSEM은 벌점 추정을 공유하지만, 분석 목적에서 분명한 차이를 가진다(Jacobucci et al., 2016; Asparouhov & Muthén, 2024). RegSEM은 적절한 벌점을 통해 불필요한 경로를 축소함으로써 간명하면서 안정적인 모형을 탐색한다. 반면, PSEM은 최소한의 벌점으로 미식별 모형을 식별 가능하게 만드는 데 초점을 둔다. PSEM에서 벌점의 부여는 탐색적 요인분석에서 회전 기준의 설정과 유사한 역할을 한다. 요인회전 제약이 무수히 많은 해를 갖는 미식별 요인모형의 본질적 속성을 유지하면서 특정한 기준을 충족하는 모형을 선택할 수 있게 하듯이, PSEM의 벌점 함수는 미식별 SEM 모형의 본질적 속성을 유지하면서 특정한 방식으로 유도된 모형이 식별될 수 있게 한다.
PSEM으로 식별된 모형은 임의로 식별된 영모형(예, EFA 모형)과 충분한 근접성을 보일 때 동등한 모형으로 간주된다(Asparouhov & Muthén, 2009; 2024). 벌점 최대우도(Penalized Maximum Likelihood, PML) 추정의 경우 ‘충분한 근접성’은 최대우도 추정에서 얻은 로그우도(log-likelihood, LL) 값의 차이로 평가할 수 있다. Asparouhov와 Muthén(2024)는 벌점이 부여되지 않은 기저모형(영모형)과 벌점이 부여된 모형 간의 로그우도 차이가 1을 넘지 않을 것을 권장하였다. Asparouhov(2023)는 예시분석에서 두 모형 간 로그우도의 차이가 0.11(EFA: -1303.45/PSEM: -1303.56)인 경우를 기저모형에 충분히 가까운(sufficiently close) 수준으로 해석한 바 있다.
일반적으로 구조방정식모형은 ML(최대우도법) 또는 WLS(가중최소제곱법)를 사용하여 적합함수 F(θ)를 최소화하는 모수 벡터 θ를 구한다. 벌점을 적용하는 구조방정식모형은 적합함수에 가중된 벌점을 추가하여 다음과 같은 식을 최소화하는 θ를 구한다.
여기서 w는 벌점에 대한 가중치이고 P는 벌점 함수를 의미한다.
적합함수 F(θ)만을 최소화하는 SEM에서는 식별되지 않는 기저모형(PSEM의 영모형)을 추정하는 원리는 다음과 같다. 가중치가 충분히 작을 때, F1(θ)를 최적화하는 것은 F(θ)를 최적화하는 것과 동등하며, F(θ)가 최적화되는 θ의 부분공간에서 벌점항 P(θ)가 다음으로 최적화된다. 이때, 영모형은 가중치 w를 벌점항 P(θ)에 곱하여 일부 θ 모수를 명시적으로 제약함으로써 식별된다. 즉, 가중치 w는 PSEM과 영모형에 대해 사실상 동일한 로그우도 값을 산출하는 충분히 작은 값을 선택한다. Mplus에서는 가중치의 적정 수준을 판단할 수 있도록 벌점 비율을 제공하는데 이 값이 0.01에서 0.1 사이에 있을 것을 권장한다.
현재 PSEM을 수행할 수 있는 소프트웨어는 Mplus가 유일하다. Mplus를 이용한 분석에서는 가중치 w가 아니라 벌점 함수의 척도 모수 v로 벌점의 강도를 조정한다(Asparouhov & Muthén, 2024). 척도 모수는 베이지안 추정에서 사전분포의 분산과 같은 역할을 하는데 분산이 클수록 벌점 제약이 약하고 분산이 작을수록 벌점 제약이 강하게 작용한다. 즉, 척도 모수의 값은 가중치 w와 역수 관계이다.
ESEM과 PSEM의 관계
ESEM과 PSEM은 모두 전형적인 CFA의 엄격한 단순구조 가정을 완화하여 교차부하량을 체계적으로 추정할 수 있다는 공통점이 있지만 이론적 포괄성과 구현 방식에서 차이가 있다. 이론적으로 PSEM은 기존의 ESEM, 베이지안 SEM, 다집단 정렬(Alignment) 분석을 확장하고 일반화한 넓은 범주의 분석 체계로 이해할 수 있다(Asparouhov & Muthén, 2024). PSEM 관점에서는 EFA 모형과 ESEM은 회전 기준을 벌점 함수로 사용하는 PSEM의 특수한 형태로 간주된다(Asparouhov & Muthén, 2025).
EFA의 기저모형은 요인 미결정성 또는 회전 미결정성으로 인해 실제로는 해가 특정되지 않는 미식별모형이다. 실제 회전 전 또는 회전 후의 EFA 요인부하량의 조합은 무수한 동치모형 중 임의의 제약을 부여하여 식별한 하나의 가능한 해를 의미한다. EFA에서 사용되는 다양한 회전 방식은 해석을 위해 특정하게 부여된 식별 제약의 여러 형태라고 할 수 있다. PSEM은 벌점을 이용하여 EFA 모형을 식별할 수 있는데 EFA 기저모형에 특정한 방식으로 벌점을 부여하면 EFA의 회전후 해에 상응하는 결과를 얻을 수 있다. 예를 들어 PSEM에서 요인부하량 전체에 지오민 벌점을 부여하면 EFA의 지오민 회전과 거의 동일한 결과를 산출한다. 다차원 요인모형에서 지표-요인 관계가 약한 교차부하량 세트에 라쏘(LASSO) 또는 ALF 벌점을 부여하면 EFA의 목표회전에 상응하는 유사 목표회전의 결과를 얻을 수 있다(Asparouhov & Muthén, 2024).
PSEM에서는 잔차 공분산 설정이나 동일성 제약과 같이 SEM에서 사용하는 설정을 대부분 사용할 수 있다. 따라서 ESEM과 마찬가지로 종단 다차원 요인모형에서 시점 간 잔차 공분산을 허용하고 요인부하량 동일성 제약을 부여할 수 있다. 이를 통해 PSEM은 종단 자료의 특성을 적절히 반영할 수 있도록 모형에 유연성과 간명성을 동시에 제공할 수 있다. 벌점에 의한 유사 목표회전과 잔차 공분산 설정, 측정동일성 제약을 결합하면 PSEM은 ESEM과 마찬가지로 종단 다차원 요인구조 분석에서 EFA와 CFA가 가지는 단점을 줄이고 장점을 살리는 분석을 제공한다.
다행스럽게도 PSEM에서는 추정 방식의 유연성 덕분에 ESEM으로는 구현 불가능한 요인 모형의 설정도 가능하다(Asparouhov & Muthén, 2024). 예를 들어 ESEM에서는 일부 요인부하량에만 동일성 제약을 부여하는 부분 측정동일성 모형의 설정이 불가능하지만 PSEM에서는 가능하다. 종단 요인모형에서 모든 문항에 대한 시점 간 측정동일성이 성립하지 않는다면 일부 문항에 대해서만 동일성 제약을 부여하는 부분 측정동일성 모형을 검토해야 한다. 목표회전을 적용한 다차원 탐색적 요인모형에서 부분 측정동일성 모형을 검토한다면 주부하량에만 동일성을 부여하거나 교차부하량에만 동일성을 부여하는 방법을 생각할 수 있다. PSEM에서는 이러한 분석이 가능하다.
방 법
목표회전을 이용한 다차원 요인구조의 탐색, 종단 요인모형에 대한 시점 간 잔차 공분산의 허용, 시점 간 측정동일성 제약 등이 복합된 모형을 분석해야 할 때 ESEM과 PSEM이 어떻게 활용될 수 있는지 예시하기 위해 실제 자료를 이용한 종단 요인모형의 분석을 수행하였다. 비교를 위해 교차부하를 포함하지 않는 확인적 요인분석 모형인 ICM-CFA에 대한 분석도 함께 수행하였다.
분석 자료
분석에 사용한 자료는 미국 건강과 은퇴 연구(Health and Retirement Study, HRS)에서 수집된 정서 문항에 대한 응답이다(Health and Retirement Study, 2008; 2020). 심리사회적 변인이 최초로 측정된 2008년과 가장 최근에 후속 측정된 2020년 두 시점에 모든 정서 문항에 응답한 1,796명(평균 연령 63.73세, SD=7.8; 여성 62.2%)의 자료가 분석에 사용되었다. 정서 측정은 지난 30일간의 경험에 대해 5점 리커트 척도(1: 매우 그렇다 - 5: 전혀 아니다)로 평정하였으며, 본 연구에서는 해석의 편의를 위해 역코딩하였다. 따라서 높은 점수는 해당 정서를 더 강하게 경험했음을 의미한다.
정서 구조에 대한 가장 일반적인 모형은 긍정정서와 부정정서의 2차원 모형인데 이를 측정하기 위한 대표적인 도구가 긍정정서 및 부정정서 척도(Positive Affect and Negative Affect Schedule, PANAS)다(Watson & Tellegen, 1985; 이현희, 김은정, 이민규, 2003). HRS에서는 총 25개의 정서 문항이 측정되었는데, 이 중 22문항은 확장판 PANAS(PANAS-X)에 포함된 것이다(Watson & Clark, 1994). PANAS는 고각성 정서를 중심으로 문항이 구성되었는데 그 결과 고각성 긍정정서와 부정정서가 서로 직교하는 ICM-CFA의 단순구조 가정에 비교적 잘 부합한다(Watson & Tellegen, 1985; Crawford & Henry, 2004). 그러나 각성의 수준이 높지 않은 일반적인 정서 측정 상황에서는 긍정정서와 부정정서 간 독립성이 약화되고, 부적 상관의 경향이 뚜렷해진다(Russell & Carroll, 1999).
본 연구에서는 HRS에서 측정된 정서 문항을 사용하여, 높은 요인상관과 잠재적인 교차부하량을 포함할 것으로 예상되는 요인구조를 검토하였다. 측정적 다차원성이 존재하는 자료에서 ESEM과 PSEM이 어떻게 작동하는지를 확인하고자, 25개 정서 문항 중 Kercher(1992)가 구분한 고각성 정서 10개 문항을 제외하고 다양한 각성 수준의 정서가 포함된 15개 문항을 분석에 사용하였다. 이 중 긍정정서는 8문항[활기찬(Active), 자랑스러운(Proud), 흥미진진한(Interested), 행복한(Happy), 주의깊은(Attentive), 만족스러운(Content), 차분한(Calm), 희망찬(Hopeful)]이었고 부정정서는 7문항[죄책감 드는(Guilty), 적대적인(Hostile), 조마조마하는(Jittery), 부끄러운(Ashamed), 슬픈(Sad), 좌절한(Frustrated), 지루한(Bored)]이었다.
기본 모형 설정
분석을 위해 설정한 공통모형은 그림 1과 같이 두 시점에 걸친 정서경험의 잠재 구조를 분석하기 위한 다차원 종단 요인모형이다. 정서의 2차원 구조를 반영하기 위해 각 시점마다 긍정정서와 부정정서를 측정하는 두 개의 잠재요인을 설정하였다. 긍정정서 요인과 부정정서 요인이 각각 8개와 7개 문항으로 측정되었다.
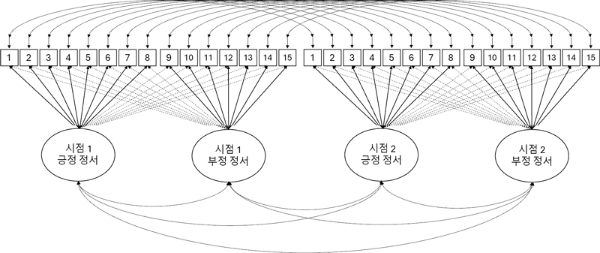
모든 분석 모형에 공통으로 적용한 기본 설정은 다음과 같다. 시점 내 및 시점 간 요인공분산은 모두 자유추정되도록 설정하였다. 잔차구조는 종단 측정모형의 표준적인 방식에 따라, 동일 문항의 시점 간 잔차 공분산만을 자유모수로 설정하였다(Little, 2024). 이를 통해 각 문항의 고유한 측정 특성이 시간에 따라 안정적으로 유지되도록 허용하였다. 나머지 잔차 공분산은 모두 0으로 제약하여, 교차문항 간 공유된 오차 구조는 없다고 가정하였다.
모형 식별을 위해 ICM-CFA와 PSEM에서 각 요인에서 기준변수의 주부하량을 1로 고정하였다. 기준변수는 요인분산 고정법으로 추정한 ICM-CFA 결과 추정치를 살펴보고, 두 시점에서 비표준화 회귀계수 값이 큰 문항 가운데 비교적 잔차분산이 낮은 문항을 선정하였다(Newsom, 2024). 긍정정서 요인에서는 ‘행복한’ 문항(λ= 0.736/0.756; θ= 0.353/0.356)을, 부정정서 요인에서는 ‘슬픈’ 문항(λ= 0.624/0.690; θ= 0.470/ 0.483)을 기준변수로 선택하였다.
본 분석에서는 측정동일성 모형에서 측정단위 동일성을 가정하여, 동일 문항의 요인부하량이 시점 간에 동일하다는 제약을 설정하였다. 다차원 종단 요인분석의 주된 목적은 시간 경과에 따른 요인구조의 일관성을 검증하고, 잠재변수들의 구조적 관계(공분산 및 상관관계)와 시간에 따른 안정성을 규명하는 데 있다. 요인부하량의 동일성을 검증하는 측정단위 동일성이 확보될 경우 잠재변수의 척도가 고정되므로, 절편의 동일성 여부와 무관하게 변수 간의 영향력이나 관계의 강도를 비교하는 데는 충분한 조건이 된다(Grimm et al., 2016; Little, 2024).
ICM-CFA와 ESEM, PSEM 간의 핵심적인 차이는 요인구조를 어떻게 설정하느냐에 있다. ICM-CFA는 각 문항이 오직 하나의 요인에만 부하되는 단순구조로 모델링한다. ESEM과 PSEM은 지표변수의 측정적 다차원성을 반영하여 모든 교차부하를 허용한다. 그림 1은 본 연구의 종단 다차원 요인구조의 모형도이다.
측정모형의 실선은 각 문항이 주요인과 맺는 일차적 관계를 나타내며, 이는 모든 분석 방법에서 공통적으로 추정되는 주부하량이다. 측정모형의 점선은 같은 시점 내에서 문항이 다른 요인과 맺는 교차부하량을 의미한다. ICM-CFA는 실선으로 표시된 경로만 추정하여 엄격한 단순구조가 적용되는 반면, ESEM과 PSEM에서는 실선으로 표시된 주부하량과 점선으로 표시된 교차부하량이 함께 추정된다. 목표회전을 적용한 ESEM은 교차부하량이 0에 가깝도록 유도되며, PSEM은 교차부하량에 벌점 함수가 적용된다. 측정동일성 제약 적용에도 방법 간 차이가 있다. ESEM에서는 실선과 점선 모두에 대해 시점 간 동일성 제약이 부여되지만, PSEM에서는 실선의 주부하량에만 동일성 제약을 부여하는 부분 측정동일성 분석이 가능하다.
분석
요인모형의 분석에는 Mplus 9.0이 사용되었다(Muthén & Muthén, 2025). ICM-CFA는 다차원 요인구조 분석의 기저선 역할을 한다. 긍정정서 8문항은 해당 시점의 긍정정서 요인에만, 부정정서 7문항은 부정정서 요인에만 부하되도록 설정하였다.
ESEM은 목표회전을 적용하여 주부하량과 교차부하량을 구분하였다. 목표회전은 완전히 탐색적인 지오민 회전과 달리, 요인구조에 대한 이론적 지식을 회전 과정에 통합하는 접근이다. 탐색적 구조방정식모형 분석에 사용된 Mplus 명령문은 부록 1에 제시되어 있다. 명령문에서 PA1과 NA1은 각각 시점 1의 긍정정서 요인과 부정정서 요인을, PA2와 NA2는 시점 2의 긍정정서 요인과 부정정서 요인을 나타낸다. 긍정정서 문항들은 긍정정서 요인의 주부하량으로 자유추정되며, 부정정서 문항들의 교차부하량은 ‘~0’으로 표기된다. 여기서 ‘~0’은 해당 부하량이 0에 가까운 값을 가지도록 회전을 유도하는 목표값(target value)이다. 데이터가 실질적인 교차부하량을 지지한다면, 해당 모수는 0이 아닌 값으로 추정될 수 있다.
ESEM의 측정동일성은 ‘(*t1 1)’, ‘(*t2 1)’과 같은 묶음 제약 라벨로 설정할 수 있다. 17행에서, PA2의 묶음 제약을 ‘(*t2 3)’으로 설정하면 PA1의 ‘(*t1 1)’ 묶음과 다른 라벨이 부여되어 형태동일 모형이 추정되고, ‘(*t2 1)’로 동일한 라벨을 설정하면 PA1과 PA2 간에 측정단위동일 모형이 추정된다. 이는 Mplus에서 요인 내 모든 요인부하량을 하나의 집단으로 묶어 동일하게 제약하는 표기법이다. 이때, 묶음 제약 방식에서는 일부 부하량을 선택적으로 제약할 수 없다. 따라서 주부하량뿐만 아니라 모든 교차부하량도 시점 간에 동일하게 제약하게 된다.
PSEM은 ICM-CFA와 동일하게 모든 요인부하량을 명시적으로 추정하되, 교차부하량에 벌점 함수를 적용하여 0의 방향으로 벌점을 주는 접근법이다. ESEM의 목표회전이 회전 과정에서 간접적으로 교차부하량을 최소화한다면, PSEM은 적합함수에 직접 벌점항을 추가하여 이를 달성한다.
PSEM의 벌점항은 불필요한 변수를 제거하거나 사전정보(prior)를 강하게 반영하는 것보다, 모형의 식별이 주요 목적이다(Asparouhov & Muthén, 2024). 따라서 이상적인 PSEM 추정치는 벌점이 없는 영모형의 로그우도와 벌점이 포함된 모형의 로그우도 간에 실질적인 차이가 없어야 한다. 본 분석에서는 ESEM의 결과를 영모형으로 사용하였는데, 이는 EFA/ESEM이 PSEM의 영모형과 수학적 쌍대(dual) 관계를 형성하기 때문이다(Asparouhov & Muthén, 2024). ESEM의 목표회전은 수많은 수학적으로 동등한 해 가운데 연구자가 설정한 회전 기준에 가장 부합하는 해를 선택하는 과정이며, 회전 전의 미식별 모형과 동일한 로그우도 값 및 적합도를 산출한다(Osborne, 2015). 이 미식별 모형은 PSEM의 영모형이기도 하다(Asparouhov, 2023). ESEM은 회전 기준을 통해, PSEM은 약한 벌점을 통해 각각 적합도 손실 없이 식별 가능한 해를 도출한다. 따라서 쌍대성(duality)의 원리에 의해 ESEM의 로그우도 값을 PSEM 추정의 적절성을 판단하는 기준점으로 활용할 수 있다(Asparouhov, 2023).
벌점 구조방정식모형 분석에 사용된 Mplus 명령문은 부록 2에 제시되어 있다. 부록 2의 31-34행에서 ‘MODEL PRIORS’ 영역의 ‘ALF(0, v)’ 설정은 정렬 손실 함수(Alignment Loss Function)의 벌점을 의미한다. 벌점의 강도를 조정하는 척도 모수 v 값은 로그우도 값을 확인하여 교차부하량 모수들(PA1N_1-PA1N7, NA1P_1-NA1P_8 등)에 0의 방향으로 최소한의 압력을 가하는 수준으로 설정하여야 한다(Asparouhov & Muthén, 2024). 본 연구에서는 형태동일 PSEM에는 2, 측정단위동일 PSEM에는 1의 v 값을 설정하였다(Asparouhov, 2023 참조). 이 값은 모든 교차부하량을 동시추정하면서도 로그우도 상의 손실은 거의 없는(ΔLL=0.009) 지점을 탐색하여 결정하였다. 기준 적합도를 확인할 수 없는 부분동일 PSEM에는 v 값을 0.1로 설정하였는데, 이는 해석 가능한 요인구조를 도출하면서도 로그우도 손실을 최소화할 수 있는 벌점 수준이다. 이 선택의 근거는 이후 결과 부분에서 후술하였다.
PSEM의 측정동일성은 다음과 같이 설정할 수 있다. 전체 단위동일 모형은 주부하량과 교차부하량 모두에 시점 간 동일성 제약을 부과한다. 반면 부분동일 모형은 ESEM에서 설정할 수 없지만, PSEM은 가능하다. 구체적으로, 주부하량에는 시점 간 동일한 라벨을 부여하여 동일성을 제약하고, 교차부하량은 시점별로 독립 추정한다. 부록 2에서 13행과 19행은 주부하량에 해당하므로 시점 간 동일한 라벨(PA1P_1-PA1P8)을 부여하였고, 14행과 20행은 교차부하량에 해당하므로 시점 간 다른 라벨(PA1N_1-PA1N7 및 PA2N_1-PA2N7)을 부여하였다. 이러한 부분동일 모형은 이론적으로 중요한 주부하량의 시간적 안정성을 검증하면서도, 상대적으로 덜 중요한 교차부하량에는 불필요한 제약을 가하지 않는 유연성을 제공한다는 점에서 종단 연구에 특히 유용하다.
분석에는 Mplus 9.0(Muthén & Muthén 2025)과 R의 MplusAutomation 패키지(Hallquist & Wiley, 2018)를 사용하였다. 모든 분석에는 최대우도추정이 적용되었다. 모형의 적합도는 적합도 지수인 CFI(Comparative Fit Index), TLI(Tucker- Lewis Index) 및 RMSEA(Root Mean Squared Error of Approximation) 값과 정보기준인 AIC, BIC를 종합적으로 검토하였다. CFI와 TLI는 .90 이상, RMSEA는 .08 이하일 때 양호한 적합도로, 각각 .95 이상과 .06 이하일 때 우수한 적합도로 해석한다(Hu & Bentler, 1999; Marsh et al., 2005).
결 과
모형 적합도
표 1은 종단 요인분석에서 세 가지 분석 방법(ICM-CFA, ESEM, PSEM)과 측정동일성 수준에 따른 모형 적합도 지수를 제시한다. 형태동일 모형과 단위동일 모형 모두에서 CFA는 상대적으로 적합도가 낮았다(형태동일: χ2 = 2886.9, p < .001, CFI = .891, TLI = .876, RMSEA = .060; 단위동일: χ2 = 2932.5, p < .001, CFI = .890, TLI = .879, RMSEA = .060). 이는 CFA가 모든 교차부하량을 0으로 고정함으로써 데이터의 복잡한 요인구조를 충분히 반영하지 못했기 때문으로 판단된다. 반면, 교차부하량을 허용하는 ESEM과 PSEM의 결과는 CFA보다 적합도가 상당히 개선되었다(형태동일 조건: ΔCFI = .035, ΔTLI = .035, ΔRMSEA = -.009; 단위동일 조건: ΔCFI = .035, ΔTLI = .036, ΔRMSEA = -.010).
표 1.
분석 모형별 모형 적합도 지수
| 모형 | 로그우도 | χ2 | df | AIC | BIC | CFI | TLI | RMSEA [90% C.I.] |
|---|---|---|---|---|---|---|---|---|
| 형태동일성 | ||||||||
| CFA | -62290.9 | 2886.9*** | 384 | 124803.9 | 125413.6 | 0.891 | 0.876 | 0.060 [0.058, 0.062] |
| ESEM | -61870.1 | 2045.2*** | 358 | 124014.2 | 124766.7 | 0.926 | 0.911 | 0.051 [0.049, 0.053] |
| PSEM | -61870.1 | 2045.2*** | 358 | 124014.2 | 124766.8 | 0.926 | 0.911 | 0.051 [0.049, 0.053] |
| 측정단위동일성 | ||||||||
| CFA | -62313.7 | 2932.5*** | 397 | 124823.5 | 125361.8 | 0.890 | 0.879 | 0.060 [0.058, 0.062] |
| ESEM | -61901.6 | 2108.2*** | 384 | 124025.1 | 124634.9 | 0.925 | 0.915 | 0.050 [0.048, 0.052] |
| PSEM(전체동일) | -61901.6 | 2108.2*** | 384 | 124025.1 | 124634.9 | 0.925 | 0.915 | 0.050 [0.048, 0.052] |
| PSEM(부분동일) | -61885.9 | 2076.9*** | 367 | 124027.8 | 124731 | 0.925 | 0.912 | 0.051 [0.049, 0.053] |
형태동일성과 전체 단위동일성 모형에서, ESEM과 PSEM의 결과는 실질적으로 동일한 모형 적합도를 보였다. 각 동일성 수준에서 산출된 로그 우도 차이(ΔLL)가 모두 0.009로 매우 작았으며, 다른 모든 적합도 지수 역시 모형 간 차이가 거의 없었다. 이는 PSEM이 약한 벌점을 적용하여 로그우도 상의 손실없이 ESEM과 동일한 적합도를 유지함을 보여준다.
부분동일 PSEM 모형은 형태동일 모형과 전체단위동일 모형의 중간에 위치한다. 모형의 간명성은 부분동일 PSEM(df = 367)이 형태동일 PSEM(df = 358)보다 높고 전체 단위동일 PSEM(df = 384)보다 낮다. 모형-자료 간 불일치를 반영하는 로그우도와 카이제곱 값은 부분동일 PSEM(LL=-61885.9, χ2=2076.9)이 형태동일 모형(LL=-61870.1, χ2=2045.2)과 전체 단위동일 모형(LL=-61901.6, χ2=2108.2)의 중간에 위치하였다. 부분동일 PSEM은 두 모형 중간에 위치한 모형으로서 양호한 적합도를 보였다(CFI = .926, TLI = .912, RMSEA = .051).
부분동일 모형은 ESEM 추정이 불가능하므로 PSEM의 정확한 로그우도 손실량을 특정할 수 없다. 벌점항 가중치를 결정하는 v 값을 0.1보다 크게 설정하여도 모형 추정은 가능하였으나 요인구조의 해석에 문제가 있었다. 긍정정서를 측정하는 문항이 부정정서 요인에 대해 높은 정적 요인부하량(표준화 λ>.30)을 보이거나, 주부하량과 교차부하량이 뚜렷하게 구분되지 않았다. 따라서 v 값을 0.1로 설정하여 해석 가능한 요인구조를 추정하였다.
정보기준의 관점에서 흥미로운 패턴이 관찰되었다. AIC 기준으로는 형태동일 ESEM 및 PSEM이 더 우수하였으나, 추정 모수 증가에 더 큰 패널티를 부과하는 BIC 기준으로는 측정단위동일 ESEM과 PSEM이 선호되었다. 이때, 부분동일 PSEM은 형태동일 모형과 비교하여 AIC 기준에서 더 불리한 값을 산출했다. 그러나 추정 모수 증가에 더 큰 벌점을 부과하는 BIC 기준에서는 형태동일 모형보다 양호한 값을 산출했다.
요인구조의 모수 추정값
표 2는 정서 경험의 잠재요인 간 상관계수 추정값을 제시한다. 시점 내의 교차부하량을 허용하여 동일 시점 내 긍정정서-부정정서 간 상관이 CFA 대비 ESEM과 PSEM에서 감소하였음을 확인할 수 있다.
표 2.
분석 모형별 정서 요인 간 상관계수
| 형태동일성 모형 | 측정단위동일성 모형 | ||||||
|---|---|---|---|---|---|---|---|
| CFA | ESEM | PSEM | CFA | ESEM | PSEM (전체동일) |
PSEM (부분동일) |
|
| 시점 내 교차 상관 | |||||||
| 시점1 긍정정서↔시점1 부정정서 | -0.612 | -0.517 | -0.446 | -0.592 | -0.527 | -0.401 | -0.362 |
| 시점2 긍정정서↔시점2 부정정서 | -0.543 | -0.464 | -0.351 | -0.517 | -0.461 | -0.329 | -0.500 |
| 시점 간 자기 상관 | |||||||
| 시점1 긍정정서↔시점2 긍정정서 | 0.547 | 0.542 | 0.530 | 0.548 | 0.540 | 0.528 | 0.534 |
| 시점1 부정정서↔시점2 부정정서 | 0.546 | 0.540 | 0.540 | 0.537 | 0.544 | 0.541 | 0.542 |
| 시점 간 교차 상관 | |||||||
| 시점1 긍정정서↔시점2 부정정서 | -0.366 | -0.331 | -0.296 | -0.355 | -0.331 | -0.265 | -0.265 |
| 시점1 부정정서↔시점2 긍정정서 | -0.341 | -0.286 | -0.226 | -0.327 | -0.289 | -0.221 | -0.291 |
표 3과 표 4는 분석 방법별 측정동일성 조건에 따른 요인부하량 추정값을 보여준다. ESEM과 나머지 분석 방법의 척도 설정이 달라 비교가 용이하도록 표준화 계수를 제시하였다. 비표준화 계수는 부록 3과 부록 4에 수록하였다.
표 3.
분석 모형별 정서 요인의 주부하량 표준화계수 추정값
| 형태동일성 모형 | 측정단위동일성 모형+ | |||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 정서 문항 | CFA | ESEM | PSEM | CFA | ESEM | PSEM (전체동일) |
PSEM (부분동일) |
|||||||
| 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | |
| 긍정정서 요인 | ||||||||||||||
| 활기찬 | .632 | .625 | .666 | .688 | .640 | .652 | .630 | .627 | .675 | .677 | .634 | .644 | .624 | .691 |
| 자랑스러운 | .649 | .686 | .749 | .742 | .719 | .704 | .658 | .678 | .731 | .749 | .685 | .710 | .682 | .756 |
| 흥미진진한 | .739 | .751 | .864 | .860 | .829 | .815 | .737 | .753 | .850 | .864 | .796 | .819 | .786 | .879 |
| 행복한 | .778 | .785 | .651 | .675 | .628 | .642 | .774 | .789 | .641 | .665 | .610 | .639 | .605 | .688 |
| 주의깊은 | .600 | .638 | .688 | .721 | .660 | .683 | .615 | .624 | .700 | .710 | .655 | .672 | .647 | .716 |
| 만족스러운 | .747 | .788 | .633 | .691 | .610 | .658 | .744 | .790 | .630 | .680 | .598 | .653 | .591 | .700 |
| 차분한 | .666 | .689 | .488 | .556 | .472 | .530 | .661 | .693 | .500 | .530 | .478 | .513 | .469 | .553 |
| 희망찬 | .686 | .704 | .659 | .686 | .635 | .651 | .688 | .702 | .658 | .676 | .621 | .645 | .618 | .695 |
| 부정정서 요인 | ||||||||||||||
| 죄책감드는 | .538 | .483 | .588 | .525 | .579 | .515 | .466 | .534 | .517 | .579 | .502 | .563 | .499 | .580 |
| 적대적인 | .562 | .589 | .577 | .591 | .573 | .588 | .568 | .585 | .587 | .591 | .577 | .582 | .572 | .588 |
| 조마조마하는 | .643 | .663 | .646 | .672 | .643 | .667 | .648 | .658 | .665 | .664 | .655 | .655 | .650 | .663 |
| 부끄러운 | .586 | .540 | .608 | .577 | .601 | .566 | .550 | .570 | .588 | .599 | .572 | .584 | .566 | .600 |
| 슬픈 | .673 | .704 | .576 | .629 | .588 | .646 | .688 | .691 | .617 | .611 | .629 | .624 | .635 | .635 |
| 좌절한 | .625 | .668 | .599 | .666 | .603 | .667 | .635 | .660 | .638 | .650 | .635 | .647 | .635 | .663 |
| 지루한 | .475 | .517 | .345 | .385 | .359 | .410 | .503 | .489 | .377 | .362 | .397 | .382 | .393 | .377 |
표 4.
분석 모형별 정서 요인의 교차부하량 표준화계수 추정값
| 형태동일성 모형 | 측정단위동일성 모형+ | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 정서 문항 | ESEM | PSEM | ESEM | PSEM (전체동일) |
PSEM (부분동일) |
|||||
| 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | |
| 긍정정서 요인 | ||||||||||
| 죄책감드는 | .076** | .068** | .066 | .060* | .070*** | .081*** | .051* | .060* | .015 | .103** |
| 적대적인 | .018 | .008 | .011 | .003 | .023 | .024 | .006 | .006 | .006 | .010 |
| 조마조마하는 | .003 | .020 | -.004 | .014 | .024 | .025 | .005 | .005 | -.001 | .018 |
| 부끄러운 | .047* | .074** | .038 | .065* | .067*** | .071*** | .047* | .050* | .012 | .090* |
| 슬픈 | -.172*** | -.141*** | -.171*** | -.138*** | -.138*** | -.142*** | -.146*** | -.152*** | -.141** | -.123*** |
| 좌절한 | -.068** | -.020 | -.071 | -.024 | -.026 | -.028 | -.041 | -.044 | -.044 | -.008 |
| 지루한 | -.182*** | -.202*** | -.178*** | -.195*** | -.183*** | -.183*** | -.182*** | -.184*** | -.155*** | -.196*** |
| 부정정서 요인 | ||||||||||
| 활기찬 | .040 | .091*** | -.013 | .004 | .060*** | .058*** | -.027 | -.026 | -.061 | .098 |
| 자랑스러운 | .137*** | .084*** | .076 | -.009 | .099*** | .097*** | .003 | .003 | .000 | .101 |
| 흥미진진한 | .165*** | .158*** | .095 | .049 | .151*** | .148*** | .04 | .039 | .005 | .183 |
| 행복한 | -.207*** | -.197*** | -.257* | -.281*** | -.216*** | -.215*** | -.296*** | -.295*** | -.317*** | -.171* |
| 주의깊은 | .147*** | .140*** | .091 | .049 | .139*** | .135*** | .047 | .046 | .027 | .140 |
| 만족스러운 | -.172*** | -.163*** | -.222* | -.249*** | -.175*** | -.182*** | -.254*** | -.264*** | -.276*** | -.140* |
| 차분한 | -.291*** | -.232*** | -.328*** | -.301*** | -.267*** | -.272*** | -.328*** | -.335*** | -.362*** | -.220*** |
| 희망찬 | -.041 | -.028 | -.093 | -.113*** | -.045** | -.045** | -.129*** | -.128*** | -.144** | -.005 |
표 3에서 모든 주부하량은 유의수준 .001에서 통계적으로 유의하였으며, 모든 모형이 전반적으로 안정적인 요인구조를 보여주었다. 같은 동일성 조건에서 ESEM과 PSEM 두 모형의 주요인구조가 상당히 유사하였으므로 PSEM이 ESEM에 준하는 결과로 판단할 수 있다. 반면 표 4의 교차부하량의 구조를 비교할 때, PSEM이 ESEM보다 전반적으로 보수적인 추정 경향을 보였다. 부정정서 문항이 긍정정서 요인에 보이는 교차부하에서 형태동일 ESEM은 시점별로 5개와 4개의 유의한 교차부하를 산출한 반면, 형태동일 PSEM은 2개와 4개로 더 적었다. 예를 들어 시점1의 ‘부끄러운’ 문항은 형태동일 ESEM에서 표준화 교차부하량이 .047(p < .05)로 유의했으나, PSEM에서 .038로 유의하지 않았다(p = .286). 긍정정서 문항이 부정정서 요인에 보이는 교차부하에서는 이러한 차이가 더욱 두드러졌는데, 단위동일 ESEM이 8개 문항 모두에서 유의한 교차부하가 추정된 반면 전체 단위동일 PSEM은 4개 문항이 유의하였다.
부분동일 PSEM은 주부하량에만 측정동일성 제약을 부과하고 교차부하량은 시점별로 독립 추정하므로, 시점 간 차이가 있는 교차부하량이 추정될 수 있다. 일부 시점에서만 유의한 문항의 경우 ‘죄책감드는’, ‘부끄러운’ 문항은 시점 2에서만 유의하였고, ‘희망찬’ 문항은 시점 1에서만 유의하였다. ‘행복한’, ‘만족스러운’, ‘차분한’ 세 문항은 모든 시점에서 유의하게 추정되었다.
벌점 구조방정식과 탐색적 구조방정식모형의 추정 요인구조 비교
종단 다차원 요인분석에서 PSEM과 ESEM은 각각 고유한 특성을 보여주었다. 주부하량 측면에서 두 방법론은 거의 동일한 요인구조를 산출했다. 교차부하량 추정에서는 같은 측정동일 조건이라도 PSEM과 ESEM 간 차이가 있었다. 측정단위동일 ESEM은 모든 모형에서 가장 많은 교차부하를 유의하다고 추정하였는데, 특히 긍정정서 문항의 부정정서 요인에 대한 교차부하량은 8개 문항 모두 유의하였다. 반면 전체 단위동일 PSEM은 약한 벌점을 통해 4개 문항에서만 유의한 교차부하를 보였다. 이때, 형태동일 조건의 시점 2 ‘희망찬’ 1개 교차부하량(ESEM : -.028, p = .172 ; PSEM : -.113, p < .001)을 제외하고는 PSEM에서 유의한 모든 교차부하가 동일한 단위동일성 조건의 ESEM에서도 유의하였다. 즉, 예시분석에서 PSEM은 ESEM과 동일한 적합도를 유지하면서 유사한 주부하량 구조를 추정하되, 교차부하량은 ESEM보다 소폭 축소되어 산출되었다.
부분동일 벌점 구조방정식과 전체동일 벌점 구조방정식모형의 비교
로그우도 손실이 없는 전체 단위동일 PSEM과 달리, 부분동일 PSEM은 요인구조의 해석을 위해 벌점을 더 강하게 부여한 모형이다. 분석 결과, 부분 단위동일 PSEM에서 도출된 유의한 교차부하량은 모두 전체 단위동일 PSEM의 결과와 일치하였다. 그러나 전체 단위동일 모형에서 동일성 제약으로 모든 시점이 유의했던 것과 달리, 3개 문항은 부분동일 모형의 특정 시점에서만 유의한 교차부하량이 산출되었다. 이러한 결과는 정칙화의 특성이 일부분 반영된 것으로 해석할 수 있다.
논 의
본 연구는 종단 다차원 요인분석에서 ICM-CFA의 엄격한 단순구조 가정의 한계를 극복하기 위해 ESEM과 PSEM의 적용 가능성을 검토하고 실제 자료를 이용한 예시분석을 통해 이를 확인하였다. HRS 정서경험 자료의 분석 결과, 교차부하량을 허용하는 두 대안적 접근법 모두 ICM-CFA와 유사하게 해석될 수 있는 요인구조를 산출하면서도 우수한 모형 적합도를 보였다. ESEM이 일반적인 SEM/CFA의 측정모형의 제약을 완화하는 데 초점을 두었다면, PSEM은 식별의 문제로 추정할 수 없었던, 여러 모수가 추가된 모형을 추정할 수 있도록 통계적 모델링의 영역을 확장하였다.
확인적 요인분석과 요인모형의 확장
본 연구는 다차원 종단 자료 분석에서 ESEM과 PSEM의 유용성에 집중하고 있으나, 두 분석 방법이 ICM-CFA의 모든 역할을 대체할 수는 없다. ICM-CFA는 ‘단순구조’를 강제함으로써 잠재요인의 의미를 주부하량 중심으로 명확히 정의하고, 해석의 간명성을 제공한다(Thurstone, 1947; McArdle & Nesselroade, 2014). 만약 ESEM과 CFA가 유사한 적합도와 모수 추정치를 보인다면 더 간명한 모형인 CFA를 선택해야 한다(Alamer & Marsh, 2022). 특히, 연구자가 개발한 측정도구가 개념적으로 완벽하게 독립적이며, 문항이 다른 요인과 섞이지 않아야 한다는 강력한 이론적 근거가 있을 때는 ICM-CFA가 이를 검증하는 엄격한 기준이 된다(Asparouhov & Muthén, 2009).
반면 심리측정적 다차원성이 존재하는 척도의 경우, 문항들이 본질적으로 여러 요인과 관련됨에도 교차부하량을 생략하면 설명되지 못한 변량이 요인 간 공분산으로 전이된다(Marsh et al., 2009; Morin, 2023). 이는 요인상관을 과대추정하여 요인의 정의를 왜곡하고 판별타당도를 저해한다(Marsh et al., 2009). 이때에는 ESEM과 PSEM이 교차부하량을 모형에 포함시킴으로써 요인 간 관계의 왜곡을 바로잡고, 보다 현실적인 구조적 관계를 추정할 수 있다(Alamer & Marsh, 2022; Asparouhov & Muthén, 2024). 따라서 연구자는 ICM-CFA를 1차적으로 적용하여 요인구조를 살피되, 구성개념의 다차원성이 존재하면서 모형 적합도가 부족한 상황에서는 교차부하량 허용을 통해 측정모형에 유연성을 부여하는 ESEM이나 PSEM으로의 확장을 고려해야 한다.
벌점 구조방정식모형과 가중치 설정
Asparouhov와 Muthén(2024)은 PSEM 추정치가 로그우도 값의 변화가 없는 범위 내에서는 가중치의 크기에 상당히 독립적이라고 설명한다. 즉, 로그우도 값이 변하지 않는 선에서 가중치를 조절하여도 모수 추정치에 미치는 영향이 크지 않다. 이는 형태동일 PSEM과 전체 단위동일 PSEM 분석에서 확인할 수 있었다. 반면 부분동일 PSEM에서는 가중치 조절의 범위가 이를 넘어섰다. 따라서 가중치 조절에 따른 로그우도 손실이 불가피하거나 이를 판단하기 어려운 복잡한 PSEM의 경우, 연구자가 고려한 가중치 범위와 선택의 근거를 명확히 보고할 필요가 있다.
PSEM 분석 시 권장되는 방법은 척도 모수 v의 시작 값을 1로 설정하여 추정하는 것이다(Asparouhov & Muthén, 2025). 이 값에서 모형이 성공적으로 추정되고 요인구조가 명확히 해석 가능하다면, 벌점을 점진적으로 약화(v=2, 5, 10 등)하여 추정의 안정성을 재확인한다. 반대로 초기 추정에서 요인구조가 불명확하거나 수렴 문제가 발생한다면, 벌점을 단계적으로 강화(v=0.5, 0.1, 0.05, 0.01 등)하여 안정적인 추정이 가능한 최적점을 탐색한다. 이러한 반복 탐색을 통해 모형 적합도의 손실이 없거나 적으면서 해석 가능성을 최대화하는 지점의 벌점 가중치를 결정할 수 있다.
EFA의 측정동일성 제약과 부분동일성 모형
EFA/ESEM 모형을 측정동일성 판단에 사용하면, 측정단위 동일성의 위반을 판단할 때 교차부하량의 차이도 함께 감지하게 된다(Sterner et al., 2025). 이는 더 넓은 범위의 동일성을 확인할 수 있다는 장점이 있으나, 다음의 통계적 특성을 함께 고려할 필요가 있다. 우선, 동일성 검정에서 표본 크기가 매우 클 경우, 실질적으로는 무시해도 될 만큼 미미한 차이라도 통계적으로 유의미한 비동일성으로 감지될 수 있다. 이때 교차부하량의 차이가 함께 검정되면, 핵심적인 주부하량의 차이에 집중하는 것을 방해하거나 모형 전체가 비동일하다는 잘못된 결론을 내릴 수 있다(Sterner et al., 2025).
또한, EFA/ESEM은 요인 행렬 전체를 회전하여 추정하기 때문에 주부하량과 교차부하량을 구분하여 동일성을 제약할 수 없다. 이로 인해 요인의 의미를 구성하는 주요 구조(주부하량)와 그 주변(교차부하량)의 동일성이 함께 반영되어, 주부하량에 포함된 핵심적인 측정 속성의 동일성 판단에 대한 명확성을 떨어뜨릴 수 있다(Cao & Liang, 2022). 특히, 잠재요인의 의미는 이론적으로 설정된 주요 지표들과의 관계에 의해 정의된다. 요인동일성의 핵심은 모든 지표에 대한 완전한 동일성보다는, 요인의 척도와 의미를 고정할 수 있는 기준점(anchor) 역할을 수행할 충분한 지표가 존재하여 잠재 변수의 변화를 타당하게 비교할 수 있느냐에 있다(Little, 2024). 즉, 주부하량이 시점 간 불변한다면 교차부하량의 일부 차이가 요인의 정의를 훼손한다고 보기 어렵다.
부분동일 PSEM은 요인의 핵심 정의를 담당하는 주부하량에 동일성 제약을 가함으로써, 시점에 상관없이 동일한 구성개념이 측정되고 있음을 담보한다. 주부하량이 불변한다면, 교차부하량이 다소 변동하더라도 요인의 핵심적 의미는 변하지 않았다고 해석할 수 있다. 예시분석에서는 전체 단위동일성이 위배되지 않았지만 그러한 경우에는 부분동일 PSEM을 대안으로 사용할 수 있을 것이다.
영모형이 없는 PSEM의 벌점 가중치 선택
부분동일 PSEM은 CFA나 ESEM으로는 추정할 수 없기 때문에 로그우도를 확인하여 최소 식별 지점을 판단하거나 최종 모형을 선택하는 것이 어렵다. 따라서 벌점항의 가중치를 조정해가며 모수 추정치와 로그우도 값을 확인하여야 한다. 예시분석에서는 벌점항 가중치의 강도를 0.1보다 약하게 설정하여도 추정이 가능하였지만, 요인구조의 해석 가능성을 위해 벌점 가중치를 0.1로 두었다. 즉, 요인구조의 해석을 위해 최소 식별 지점보다 교차부하량을 더 축소하였다. 이 방식은 식별 목적을 달성하면서도 사전정보를 비교적 강하게 반영하는 것으로, 베이지안 분석에서 정보적 사전분포를 부여하는 것과 유사하게 이해할 수 있다(Asparouhov, 2023).
이러한 벌점 가중치 조정 과정은 RegSEM의 정칙화 강도 탐색과 유사해 보일 수 있으나, 두 접근은 본질적으로 다르다. RegSEM은 축소하고자 하는 파라미터에 상당한 벌점을 부여하여 가장 단순하고 모형-자료 간 불일치가 적은 모형을 도출하는 것이 목적이며, AIC나 BIC를 기준으로 최적의 정칙화 강도를 탐색한다(Jacobucci et al., 2016). 반면 부분동일 PSEM에서 사용된 벌점 조정은 식별과 해석이 가능한 해를 도출하는 것이 목적이다(Asparouhov & Muthén, 2024; 2025).
ESEM과 PSEM의 다른 적용
PSEM 분석 체계의 가장 큰 특징은 SEM에서 식별 문제로 추정할 수 없었던 모수를 모형에 포함할 수 있다는 점이다. PSEM을 사용하면 모든 잔차 공분산 및 교차부하량을 추정할 수 있다. 성장 모형에서는 시점별 절편 편차를 추정함으로써 절편동일성 검정도 수행할 수 있다(Asparouhov & Muthén, 2024; Putnick & Bornstein, 2016; Liu et al., 2017).
본 연구에서는 ESEM과 PSEM을 종단 다차원 요인모형에 적용한 방법을 살펴보았으나, 이들의 이점은 횡단 자료 분석에도 동일하게 적용된다. 종단 분석에서 시점 간 동일성을 검증하는 과정은 횡단 분석에서 성별이나 문화권 등 집단 간 차이를 검증하는 다집단 분석과 논리적으로 동일하다(Liu et al., 2017). Marsh 등(2009)이 지적한 바와 같이, ICM-CFA의 엄격한 단순구조 가정은 다집단 분석에서도 집단 간 비교 가능성을 저해하는 주요 원인이 된다. 예를 들어 다집단 ESEM은 집단 간 측정동일성을 유지하면서도 교차부하량을 허용하여 구성개념의 차이를 보다 정밀하게 탐색할 수 있다(Guo et al., 2019). PSEM은 근사측정동일성 모형으로도 확장 가능하며(주영신, 2025) 미식별 MIMIC 모형의 추정에도 적용할 수 있다(Asparouhov & Muthén, 2024). 연구자들은 연구 목적과 자료의 특성에 따라 횡단 자료 분석에서도 본 연구에서 제시한 ESEM과 PSEM 프레임워크를 유연하게 적용할 수 있을 것이다.
참고문헌
Asparouhov, T. (2023, June 25). New Features in Mplus. [Workshop slides]. https://www.statmodel.com/download/M3TeachingSlides.pdf
Marsh, H. W., Muthén, B., Asparouhov, T., Lüdtke, O., Robitzsch, A., Morin, A. J., & Trautwein, U. (2009). Exploratory Structural Equation Modeling, Integrating CFA and EFA: Application to Students’ Evaluations of University Teaching. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 439-476.
Morin, A. J., Myers, N. D., & Lee, S. (2020). Modern Factor Analytic Techniques: Bifactor Models, Exploratory Structural Equation Modeling (ESEM), and Bifactor-ESEM. In G. Tenenbaum, R. C. Eklund, & N. Boiangin (Eds.), Handbook of Sport Psychology: Exercise, Methodologies, & Special Topics (4th ed.), 1044-1073. John Wiley & Sons.
부 록
부록 1. 탐색적 구조방정식모형 분석에 사용된 Mplus 명령문
| 1 | DATA: FILE = data.csv; |
| 2 | |
| 3 | VARIABLE: |
| 4 | NAMES = |
| 5 | T1P_1 T1P_2 T1P_3 T1P_4 T1P_5 T1P_6 T1P_7 T1P_8 |
| 6 | T2P_1 T2P_2 T2P_3 T2P_4 T2P_5 T2P_6 T2P_7 T2P_8 |
| 7 | T1N_1 T1N_2 T1N_3 T1N_4 T1N_5 T1N_6 T1N_7 |
| 8 | T2N_1 T2N_2 T2N_3 T2N_4 T2N_5 T2N_6 T2N_7; |
| 9 | |
| 10 | ANALYSIS: ESTIMATOR = ML; ROTATION = TARGET (OBLIQUE); |
| 11 | |
| 12 | MODEL: |
| 13 | ! 시점 1 (T1): PA1 = 긍정정서, NA1 = 부정정서 |
| 14 | PA1 BY T1P_1-T1P_8 T1N_1-T1N_7~0 (*t1 1); |
| 15 | NA1 BY T1N_1-T1N_7 T1P_1-T1P_8~0 (*t1 2); |
| 16 | ! 시점 2 (T2): PA2 = 긍정정서, NA2 = 부정정서 |
| 17 | PA2 BY T2P_1-T2P_8 T2N_1-T2N_7~0 (*t2 3);!(*t2 1) |
| 18 | NA2 BY T2N_1-T2N_7 T2P_1-T2P_8~0 (*t2 4);!(*t2 2) |
| 19 | |
| 20 | ! 요인 간 상관 |
| 21 | PA1 NA1 PA2 NA2 WITH PA1 NA1 PA2 NA2; |
| 22 | |
| 23 | ! 동일 문항의 시점 간 잔차 공분산 설정 |
| 24 | T1P_1-T1P_8 T1N_1-T1N_7 PWITH T2P_1-T2P_8 T2N_1-T2N_7; |
| 25 | |
| 26 | OUTPUT: STANDARDIZED; |
부록 2. 부분동일 벌점화 구조방정식모형 분석에 사용된 Mplus 명령문
| 1 | DATA: FILE = data.csv; | |
| 2 | ||
| 3 | VARIABLE: | |
| 4 | NAMES = | |
| 5 | T1P_1 T1P_2 T1P_3 T1P_4 T1P_5 T1P_6 T1P_7 T1P_8 | |
| 6 | T2P_1 T2P_2 T2P_3 T2P_4 T2P_5 T2P_6 T2P_7 T2P_8 | |
| 7 | T1N_1 T1N_2 T1N_3 T1N_4 T1N_5 T1N_6 T1N_7 | |
| 8 | T2N_1 T2N_2 T2N_3 T2N_4 T2N_5 T2N_6 T2N_7; | |
| 9 | ||
| 10 | ANALYSIS: ESTIMATOR = ML; ROTATION = TARGET (OBLIQUE); | |
| 11 | ||
| 12 | MODEL: | |
| 13 | PA1 BY T1P_1* T1P_2-T1P_8 (PA1P_1-PA1P_8) | !주부하량 |
| 14 | T1N_1-T1N_7 (PA1N_1-PA1N_7) | !교차부하량 |
| 15 | T1P_4@1; | |
| 16 | NA1 BY T1N_1* T1N_2-T1N_7 (NA1N_1-NA1N_7) | !주부하량 |
| 17 | T1P_1-T1P_8 (NA1P_1-NA1P_8) | !교차부하량 |
| 18 | T1N_5@1; | |
| 19 | PA2 BY T2P_1* T2P_2-T2P_8 (PA1P_1-PA1P_8) | !주부하량 |
| 20 | T2N_1-T2N_7 (PA2N_1-PA2N_7) | !교차부하량 |
| 21 | T2P_4@1; | |
| 22 | NA2 BY T2N_1* T2N_2-T2N_7 (NA1N_1-NA1N_7) | !주부하량 |
| 23 | T2P_1-T2P_8 (NA2P_1-NA2P_8) | !교차부하량 |
| 24 | T2N_5@1; | |
| 25 | ||
| 26 | PA1 NA1 PA2 NA2 WITH PA1 NA1 PA2 NA2; | |
| 27 | ||
| 28 | T1P_1-T1P_8 T1N_1-T1N_7 PWITH T2P_1-T2P_8 T2N_1-T2N_7; | |
| 29 | ||
| 30 | MODEL PRIORS: !교차부하량에 ALF 벌점화 부여 | |
| 31 | PA1N_1-PA1N_7 ~ ALF(0, 0.1); | |
| 32 | NA1P_1-NA1P_8 ~ ALF(0, 0.1); | |
| 33 | PA2N_1-PA2N_7 ~ ALF(0, 0.1); | |
| 34 | NA2P_1-NA2P_8 ~ ALF(0, 0.1); | |
| 35 | ||
| 36 | OUTPUT: STANDARDIZED; | |
부록 3. 분석 모형별 정서 요인의 주부하량 비표준화계수 추정값
| 형태동일성 모형 | 측정단위동일성 모형 | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 정서 문항 | CFA | ESEM | PSEM | CFA | ESEM | PSEM (전체동일) |
PSEM (부분동일) |
|||
| 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | |||||
| 긍정정서 요인 | ||||||||||
| 활기찬 | .932 | .943 | .723 | .785 | 1.168 | 1.202 | .938 | .731 | 1.192 | 1.184 |
| 자랑스러운 | 1.016 | 1.082 | .864 | .887 | 1.393 | 1.361 | 1.051 | .843 | 1.373 | 1.366 |
| 흥미진진한 | 1.028 | 1.037 | .883 | .899 | 1.424 | 1.377 | 1.033 | .860 | 1.398 | 1.392 |
| 행복한 | 1.000 | 1.000 | .616 | .650 | 1.000 | 1.000 | 1.000 | .606 | 1.000 | 1.000 |
| 주의깊은 | .822 | .901 | .691 | .769 | 1.114 | 1.178 | .863 | .709 | 1.152 | 1.142 |
| 만족스러운 | 1.074 | 1.081 | .671 | .717 | 1.087 | 1.102 | 1.077 | .666 | 1.098 | 1.093 |
| 차분한 | .882 | .882 | .476 | .538 | .775 | .829 | .882 | .486 | .807 | .801 |
| 희망찬 | .941 | .970 | .665 | .714 | 1.076 | 1.096 | .956 | .664 | 1.088 | 1.089 |
| 부정정서 요인 | ||||||||||
| 죄책감드는 | .650 | .456 | .443 | .342 | .799 | .531 | .532 | .379 | .624 | .620 |
| 적대적인 | .630 | .612 | .404 | .423 | .736 | .666 | .621 | .413 | .688 | .676 |
| 조마조마하는 | .826 | .798 | .518 | .557 | .945 | .875 | .810 | .537 | .895 | .880 |
| 부끄러운 | .576 | .468 | .373 | .345 | .675 | .535 | .516 | .356 | .586 | .580 |
| 슬픈 | 1.000 | 1.000 | .534 | .616 | 1.000 | 1.000 | 1.000 | .580 | 1.000 | 1.000 |
| 좌절한 | 1.014 | .992 | .607 | .683 | 1.118 | 1.081 | 1.004 | .650 | 1.094 | 1.087 |
| 지루한 | .738 | .798 | .335 | .410 | .637 | .690 | .766 | .372 | .662 | .642 |
부록 4. 분석 모형별 정서 요인의 교차부하량 비표준화계수 추정값
| 형태동일성 모형 | 측정단위동일성 모형 | |||||||
|---|---|---|---|---|---|---|---|---|
| 정서 문항 | ESEM | PSEM | ESEM | PSEM (전체동일) |
PSEM (부분동일) |
|||
| 시점1 | 시점2 | 시점1 | 시점2 | 시점1 | 시점2 | |||
| 긍정정서 요인 | ||||||||
| 죄책감드는 | .057** | .044** | .083 | .063* | .051*** | .065* | .019 | .103** |
| 적대적인 | .013 | .006 | .013 | .003 | .016 | .007 | .008 | .011 |
| 조마조마하는 | .002 | .017 | -.005 | .018 | .020 | .007 | -.002 | .022 |
| 부끄러운 | .029* | .044** | .039 | .063* | .041*** | .049** | .013 | .082* |
| 슬픈 | -.160*** | -.138*** | -.267*** | -.218*** | -.129*** | -.238*** | -.230** | -.181*** |
| 좌절한 | -.069** | -.021 | -.120 | -.039 | -.027 | -.073 | -.077 | -.013 |
| 지루한 | -.176*** | -.216*** | -.289*** | -.335*** | -.181*** | -.312*** | -.262*** | -.313*** |
| 부정정서 요인 | ||||||||
| 활기찬 | .043 | .103*** | -.026 | .008 | .065*** | -.049 | -.112 | .180 |
| 자랑스러운 | .158*** | .100*** | .160 | -.017 | .114*** | .006 | .001 | .194 |
| 흥미진진한 | .169*** | .165*** | .177 | .082 | .153*** | .068 | .009 | .309 |
| 행복한 | -.196*** | -.190*** | -.447* | -.428*** | -.204*** | -.473*** | -.505*** | -.265* |
| 주의깊은 | .148*** | .149*** | .167 | .083 | .141*** | .080 | .046 | .239 |
| 만족스러운 | -.183*** | -.169*** | -.431* | -.407*** | -.185*** | -.455*** | -.491*** | -.233* |
| 차분한 | -.284*** | -.225*** | -.587*** | -.460*** | -.260*** | -.540*** | -.596*** | -.341*** |
| 희망찬 | -.041 | -.029 | -.171 | -.186** | -.046** | -.220*** | -.245** | -.008 |